Il 4 agosto 2026, la pagina di stato ufficiale di DeepSeek ha registrato due incidenti di prestazioni degradate dell'API.
Il primo incidente è durato 1 ora e 18 minuti, dalle 02:02 alle 03:20 UTC, e ha interessato DeepSeek V4 Flash, V4 Pro ed Expert Mode. Il secondo incidente è durato 36 minuti, dalle 03:43 alle 04:20 UTC, e ha interessato l'API di DeepSeek V4 Flash.
Entrambi gli incidenti sono stati nel frattempo risolti. OpenCode ha inoltre segnalato che DeepSeek Flash stava riscontrando problemi di capacità a causa di una domanda senza precedenti. Tuttavia, la pagina di stato ufficiale di DeepSeek ha confermato solo prestazioni degradate e non ha pubblicato una causa principale.
TL;DR
- La pagina di stato ufficiale di DeepSeek ha registrato due incidenti di prestazioni degradate che hanno interessato V4 Flash il 4 agosto 2026.
- Un'integrazione diretta con un provider crea un singolo punto di guasto, anche quando lo stesso modello è disponibile altrove.
- AIHubMix può ritentare lo stesso modello su più canali di provider quando una route a monte restituisce un errore ritentabile.
- Se tutti i canali di provider per il modello principale falliscono, il fallback del modello a livello di chiave può indirizzare la richiesta verso modelli di riserva configurati.
- Il routing multi-provider riduce la dipendenza da un singolo endpoint, ma non può eliminare i guasti correlati né i rischi a livello di gateway.
Incidenti come questo evidenziano un importante principio infrastrutturale:
Un modello affidabile non basta se è accessibile tramite un unico endpoint di provider.
Un modello non deve necessariamente significare un solo provider
Quando un'applicazione si collega direttamente a un solo provider, quell'endpoint diventa un singolo punto di guasto.
Se il provider subisce un'interruzione, raggiunge il limite di frequenza o registra un picco di latenza, l'applicazione non ha altre destinazioni verso cui inviare la richiesta. Gli utenti vedono timeout ed errori anche quando lo stesso modello resta disponibile tramite altri provider di infrastruttura.
AIHubMix separa il modello dal provider che lo serve.
Ad esempio, DeepSeek V4 Flash è disponibile tramite più provider su AIHubMix, tra cui DeepSeek, Baidu, DeepInfra e Alibaba Cloud. Le applicazioni continuano a usare un unico endpoint API compatibile con OpenAI, mentre AIHubMix gestisce le route a monte disponibili.
Questo crea due distinti livelli di affidabilità.
Livello 1: Failover del provider
Il failover del provider mantiene invariato il modello richiesto, cambiando però il provider di infrastruttura che lo serve.
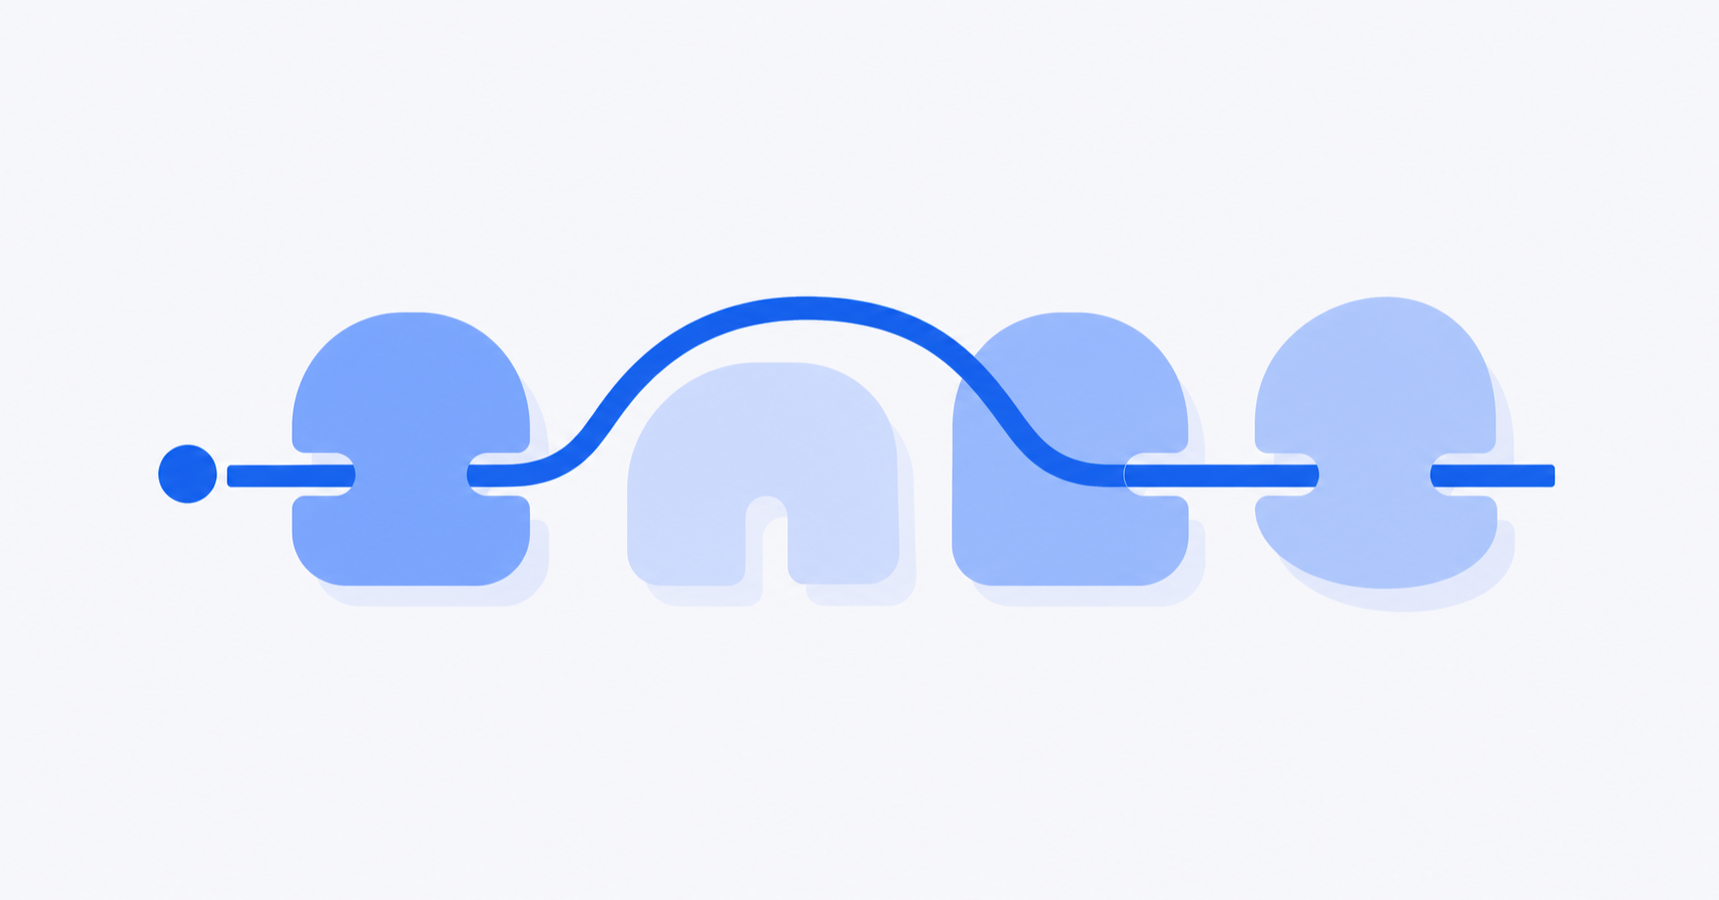
Quando una richiesta per DeepSeek V4 Flash raggiunge AIHubMix, il gateway seleziona un canale di provider idoneo. Se quel canale restituisce un errore ritentabile prima che inizi la risposta, AIHubMix può provare un altro canale disponibile per lo stesso modello.
Il percorso della richiesta può essere simile a questo:
- Prova DeepSeek V4 Flash tramite il Provider A.
- Il Provider A restituisce un timeout, un errore 5xx o un errore di capacità ritentabile.
- Prova lo stesso modello DeepSeek V4 Flash tramite il Provider B.
- Continua finché la richiesta non va a buon fine o tutti i canali idonei non sono esauriti.
Il client non deve integrare più SDK dei provider, gestire chiavi API separate o implementare una propria logica di retry.
Questo è il failover a livello di provider: cambia il provider, ma il modello richiesto resta lo stesso.
Livello 2: Fallback del modello
Il failover del provider non può aiutare se tutti i provider disponibili per il modello principale sono indisponibili.
AIHubMix prevede quindi un secondo livello di affidabilità: il fallback del modello.
Gli utenti possono configurare un elenco ordinato di modelli di riserva per ogni chiave API. Dopo che ogni canale idoneo per il modello principale ha restituito un errore ritentabile, AIHubMix passa al modello successivo nell'elenco di fallback.
Ad esempio:
- Principale:
deepseek-v4-flash - Primo fallback:
gpt-5.4 - Secondo fallback:
gemini-3.1-pro-preview
Il fallback viene eseguito all'interno del gateway di AIHubMix. Le applicazioni esistenti non devono inviare parametri di routing aggiuntivi né modificare il proprio codice client.
La fatturazione si basa sul modello che restituisce in ultima istanza la risposta riuscita. Gli sviluppatori possono verificare il comportamento del fallback tramite le intestazioni della risposta:
X-Aihubmix-Fallback: trueX-Aihubmix-Model: <final-model>
La configurazione completa e le regole di attivazione sono documentate in AIHubMix Model Mapping and Fallback.
Cosa può gestire il failover automatico
Il failover del provider è progettato per recuperare da problemi infrastrutturali a monte come:
- Timeout del provider
- Errori di connessione
- Risposte 5xx ritentabili
- Limiti di frequenza e errori di capacità del provider
- Indisponibilità temporanea di un canale a monte
Quando questi guasti si verificano prima dell'inizio della risposta, AIHubMix può provare in modo trasparente un'altra route.
Cosa il failover non può risolvere
Il routing multi-provider migliora la disponibilità, ma non rende il gateway infallibile.
Il fallback non viene attivato quando:
- La chiave API AIHubMix dell'utente è non valida, scaduta o esaurita nella quota
- La richiesta stessa non è valida
- Il client si disconnette o raggiunge il proprio timeout
- Una risposta in streaming è già iniziata
- È stato selezionato esplicitamente un canale di provider specifico
- Il guasto riguarda tutti i provider o il gateway stesso
I guasti dei provider possono anche essere correlati. Più provider possono dipendere dalla stessa infrastruttura sottostante, dalla stessa release del modello o dalla stessa rete regionale. Per questo motivo, la disponibilità multi-provider va misurata con traffico reale, anziché essere data per scontata in base al solo numero di provider.
Perché un aggregatore può essere più affidabile di un endpoint diretto
Chiamare direttamente un'API ufficiale offre a un'applicazione un'unica route verso il modello.
Un gateway multi-provider ne offre diverse.
Se queste route dei provider falliscono in modo indipendente, il gateway può aggirare un endpoint degradato senza esporre il guasto all'applicazione. Questo riduce la dipendenza da un singolo provider e può garantire una disponibilità più elevata rispetto a un'integrazione diretta con un solo provider.
La differenza è architetturale:
- API diretta: un modello, un provider, un unico dominio di guasto
- AIHubMix: un modello, più provider, failover automatico
- AIHubMix con fallback del modello: più provider più modelli di riserva
L'obiettivo non è prevedere quale provider fallirà per primo. È trasformare un incidente a monte in un evento di routing interno anziché in un'interruzione visibile ai clienti.
Progettare per il prossimo incidente di un provider
DeepSeek V4 Flash è tornato operativo, ma vincoli temporanei di capacità, limiti di frequenza e interruzioni a monte sono situazioni normali nell'infrastruttura AI di produzione.
Le applicazioni non dovrebbero dover modificare il codice ogni volta che un provider diventa instabile.
Con AIHubMix, gli sviluppatori possono accedere a più provider tramite un'unica API, ritentare automaticamente lo stesso modello sui canali disponibili e configurare modelli di riserva per un ulteriore livello di protezione.
Esplora i modelli e i provider disponibili su aihubmix.com/models.
FAQ
Cos'è il failover multi-provider?
Riprova automaticamente lo stesso modello tramite un altro provider idoneo quando la route attuale restituisce un errore ritentabile.
In cosa si differenzia il fallback del modello?
Il failover del provider mantiene invariato il modello. Il fallback del modello passa a un modello di riserva configurato solo dopo che tutti i canali idonei per il modello principale hanno fallito.
Quali errori possono attivare il failover?
Tra i trigger tipici ci sono timeout, errori di connessione, risposte 5xx ritentabili, limiti di frequenza ed errori temporanei di capacità prima dell'inizio di una risposta.
Il failover garantisce zero downtime?
No. Guasti correlati dei provider, incidenti a livello di gateway, errori non ritentabili e guasti dopo l'inizio dello streaming possono comunque raggiungere il client.
Devo modificare il codice della mia applicazione?
Non è richiesta alcuna logica di routing aggiuntiva. Le applicazioni continuano a usare l'endpoint compatibile con OpenAI di AIHubMix, mentre i modelli di riserva possono essere configurati a livello di chiave API.