AIHubMix оперира собствено изградена глобална мрежа за ускорение на API трафик. След като оценихме доставчици на ускорение от трети страни и установихме, че латентността и стабилността им са недостатъчни за производствени AI натоварвания, внедрихме собствени периферни възли, система за мониторинг и разпределение на трафика. Тази публикация описва измерените резултати и архитектурата зад тях.
Измерени резултати
Следните показатели идват от непрекъснат мониторинг в производствена среда след итерации върху алгоритъма за разпределение.
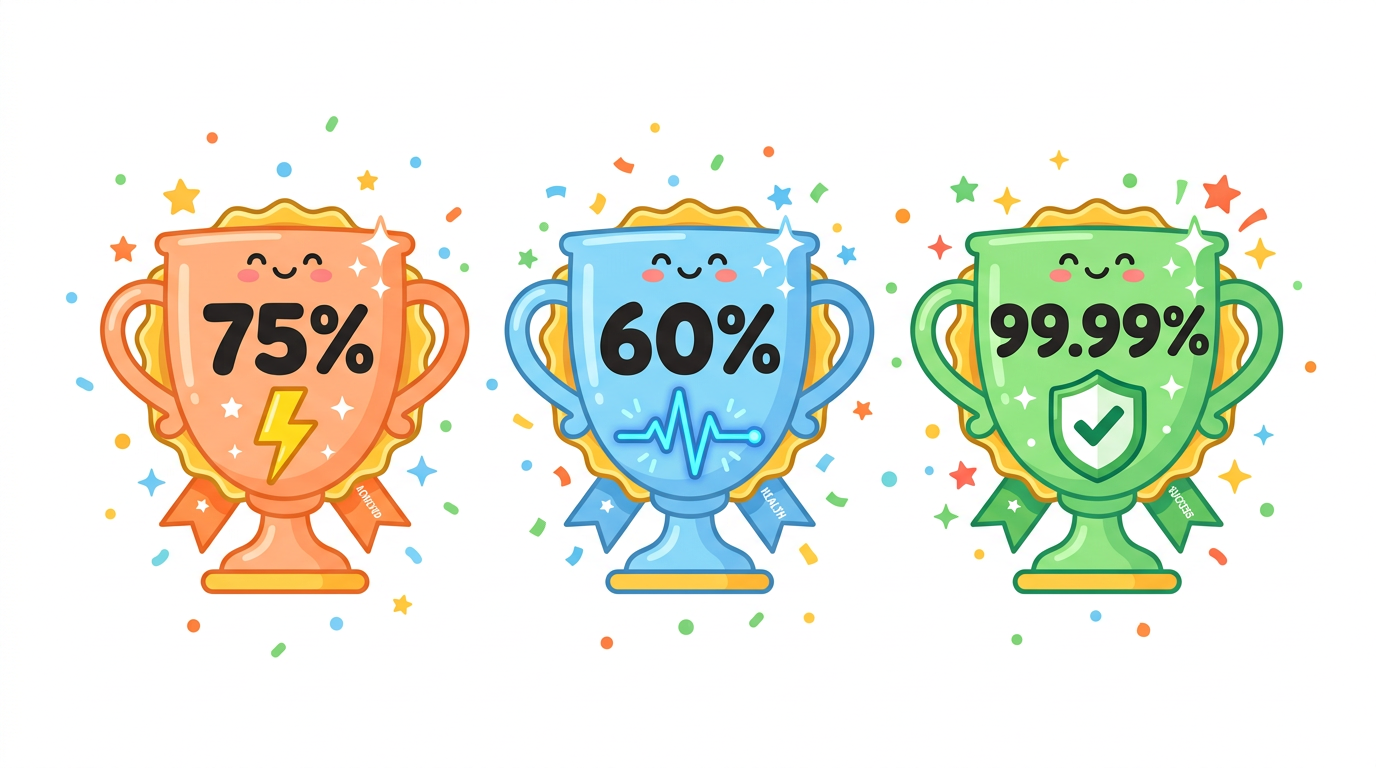
Времето за отговор е намалено с 75%
Средната латентност на API от край до край е намалена с 75%. При стрийминг сценарии това основно подобрява времето до първия токен (TTFT), интервала между изпращането на заявката и получаването на първия изходен токен, който определя колко отзивчиво се усеща чат приложението.
Колебанието в латентността е намалено с 60%
Разликата в латентността между отделните заявки е намалена с 60%. Постоянната латентност е важна за производствените приложения: тя прави времената за отговор, видими за потребителя, предвидими и намалява прекъсванията поради забавяния в крайните стойности.
Наличност на услугата от 99.99%
Наличността, измерена върху производствен трафик, достига 99.99%. Това е измерен показател, който обхваща всички часове, включително уикендите и празниците.
Архитектура
Собствено изградени периферни възли
Мрежата работи на специализирани възли за ускорение, разположени в множество региони, независимо от конкретна линия или облачен доставчик. Всеки възел преминава през тестове за латентност, загуба на пакети и пикови натоварвания, преди да влезе в производство; възлите, които не отговарят на праговете, се премахват от пула. Маршрутизацията избира най-бързия наличен път за всяко API извикване.
Мониторинг на състоянието с проверки на ниво минута
Разпределени сонди в множество региони извършват проверка на състоянието от край до край на всеки възел всяка минута, обхващайки три измерения: латентност, процент на успешност и стабилност. Цялата мрежа се сканира на всеки 60 секунди, така че аномалиите в възлите се откриват в рамките на един цикъл на проверка.
Разпределение на трафика с автоматично превключване при отказ
Системата за разпределение преизчислява оценка на състоянието за всеки възел всяка минута, на базата на данни от сонди в четири плъзгащи се прозореца: 1 минута, 5 минути, 15 минути и 1 час. Трафикът се насочва към възела с най-добра текуща оценка. Когато даден възел се влоши, превключването към здрав възел се извършва за милисекунди, без човешка намеса.
Автоматизирани операции
Управлението на възлите, оптимизацията на маршрутите, внедряването на конфигурации, подмяната на сертификати и възстановяването след повреди са напълно автоматизирани. Обработката на инциденти не зависи от времето за реакция на дежурния екип: деградиралите възли се изваждат от ротация от системата за разпределение веднага щом сондите открият аномалията.
Какво означава това за вашето приложение
- По-ниско и по-постоянно TTFT при стрийминг отговори.
- По-малко грешки от тип timeout и по-малко пикове в крайните стойности на латентността при натоварване.
- Без промени в интеграцията: ускорението се прилага автоматично към стандартните API крайни точки.
Често задавани въпроси
Трябва ли да променя интеграцията си, за да се възползвам от мрежата за ускорение?
Не. Ускорението се прилага на входния слой на платформата. Съществуващите API крайни точки, ключове и формати на заявките работят без промени.
Колко често се проверява състоянието на възлите?
Разпределените сонди сканират всеки възел в мрежата на всеки 60 секунди, измервайки латентност, процент на успешност и стабилност от край до край.
Какво се случва, когато даден възел се влоши?
Системата за разпределение преизчислява оценките на състоянието всяка минута от четири плъзгащи се прозореца (1 минута, 5 минути, 15 минути, 1 час) и автоматично прехвърля трафика към здравите възли. Превключването при отказ се извършва за милисекунди.
Последна актуализация: 2026-06-01