Anthropic пусна Claude Fable 5.2 на 9 ноември 2026 г. Google направи Gemini 4 Carbon общодостъпен ден по-късно. Собствената таблица с бенчмаркове за представянето на Anthropic включва колона за Carbon, което прави това полезно сравнение за една и съща задача по програмиране с дълъг хоризонт.
И двата модела са предназначени за една и съща задача: агентно програмиране с дълъг хоризонт. Агентът чете хранилище, редактира няколко файла, изпълнява команди, разглежда изхода от тестовете и продължава 15 до 45 минути без човешка намеса. Именно тази задача е оценена тук. Чатът, автодовършването и кратките скриптове са различен тест.
Краткият отговор
Fable 5.2 води в посочените бенчмаркове за сложни задачи по програмиране и е по-бърз при еднакво ниво на усилие, като заема първите три места в класацията на AA пред Carbon High на #4. Carbon има по-високи резултати в посочените редове за Terminal-Bench 4.0 и AutomationBench-AA и е по-евтин на задача при High effort, докато не изтече промоционалната цена на Google на 30 ноември. При Medium Fable е по-евтин и много по-бърз, докато Carbon има по-висок резултат по индекса AA.
Изберете Fable за сложни задачи по разсъждение върху код, а Carbon за изпълнение в терминала и автоматизация; преди да изберете някой от двата, проверете ограниченията за вход, съхранение и изход.
Какво показва един и същ тестов набор
Artificial Analysis изпълнява всички модели в един и същ тестов набор и с едни и същи задачи; страниците за Carbon и Fable съдържат резултатите за отделните оценки. Данните са от моментната снимка на 11 ноември 2026 г.; AA използва стандартните цени от ценоразписа, а не промоционалната отстъпка на Google.
| Модел | Индекс AA | $/задача | Минути/задача | Първи токен |
|---|---|---|---|---|
| Fable 5.2 Max | 64.56 | 26.54 | 45.2 | 233.9 s |
| Fable 5.2 Xhigh | 62.22 | 14.83 | 26.1 | 69.3 s |
| Fable 5.2 High | 61.82 | 9.08 | 17.3 | 30.4 s |
| Fable 5.2 Medium | 56.41 | 3.80 | 7.8 | 12.8 s |
| Carbon High | 60.03 | 7.76 | 25.6 | 67.1 s |
| Carbon Medium | 58.26 | 6.59 | 23.3 | 23.2 s |
| Opus 5.5 Max | 59.11 | 10.04 | 25.0 | 356.4 s |
Забележка: индексът Intelligence Index на AA и цена на задача при стандартни цени; моментна снимка от 2026-11-11T05:23Z. Fable Max, Xhigh и High са на места #1 до #3; Carbon High е #4; Opus 5.5 Max е #5; Carbon Medium е #6. „Първи токен“ означава времето до първия токен в отговора.
При High effort Fable води с 1.79 пункта, струва 17.0% повече на задача ($9.08 срещу $7.76), приключва за 17.3 минути вместо за 25.6 и връща първия си токен за 30.4 секунди вместо за 67.1. Max струва $26.54 на задача, 3.4 пъти повече от Carbon High, а първият токен пристига след 233.9 секунди.
При Medium редът се променя: Fable получава 56.41 срещу 58.26 за Carbon, тоест с 1.85 пункта по-малко, но струва $3.80 срещу $6.59 и отнема 7.8 минути срещу 23.3. По-ниската цена на токен при Carbon не го прави по-евтин на задача тук — той използва повече токени.
| Бенчмарк | Carbon High | Fable High | Fable Max | Opus 5.5 Max |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.15 | 59.6 | 59.6 | 59.6 |
| FrontierCode 2.0 | 40.56 | 49.13 | 48.76 | 46.44 |
| AutomationBench-AA | 77.82 | 71.36 | 76.42 | 69.54 |
| HLE-Diamond | 69.1 | 73.8 | 80.2 | 67.9 |
| Без халюцинации % | 88.58 | 42.02 | 40.73 | 49.66 |
| Точност % | 58.27 | 77.23 | 79.13 | 65.5 |
| Briefcase Elo | 1610.6 | 1677.4 | 1785.3 | 1800.6 |
Забележка: Artificial Analysis, един и същ тестов набор и моментна снимка. „Без халюцинации“ е делът на отговорите в Omniscience без измислени твърдения; точността е отделна оценка. По-високото е по-добро във всеки ред. Fable Xhigh е пропуснат, за да се запази четимостта на таблицата; резултатът му във FrontierCode 2.0 е 47.58.
Кой модел води във всеки тест при High effort? Подписаната разлика по-долу се изчислява като Carbon минус Fable; така посоката е ясна, а в таблицата по-горе са посочени абсолютните резултати.
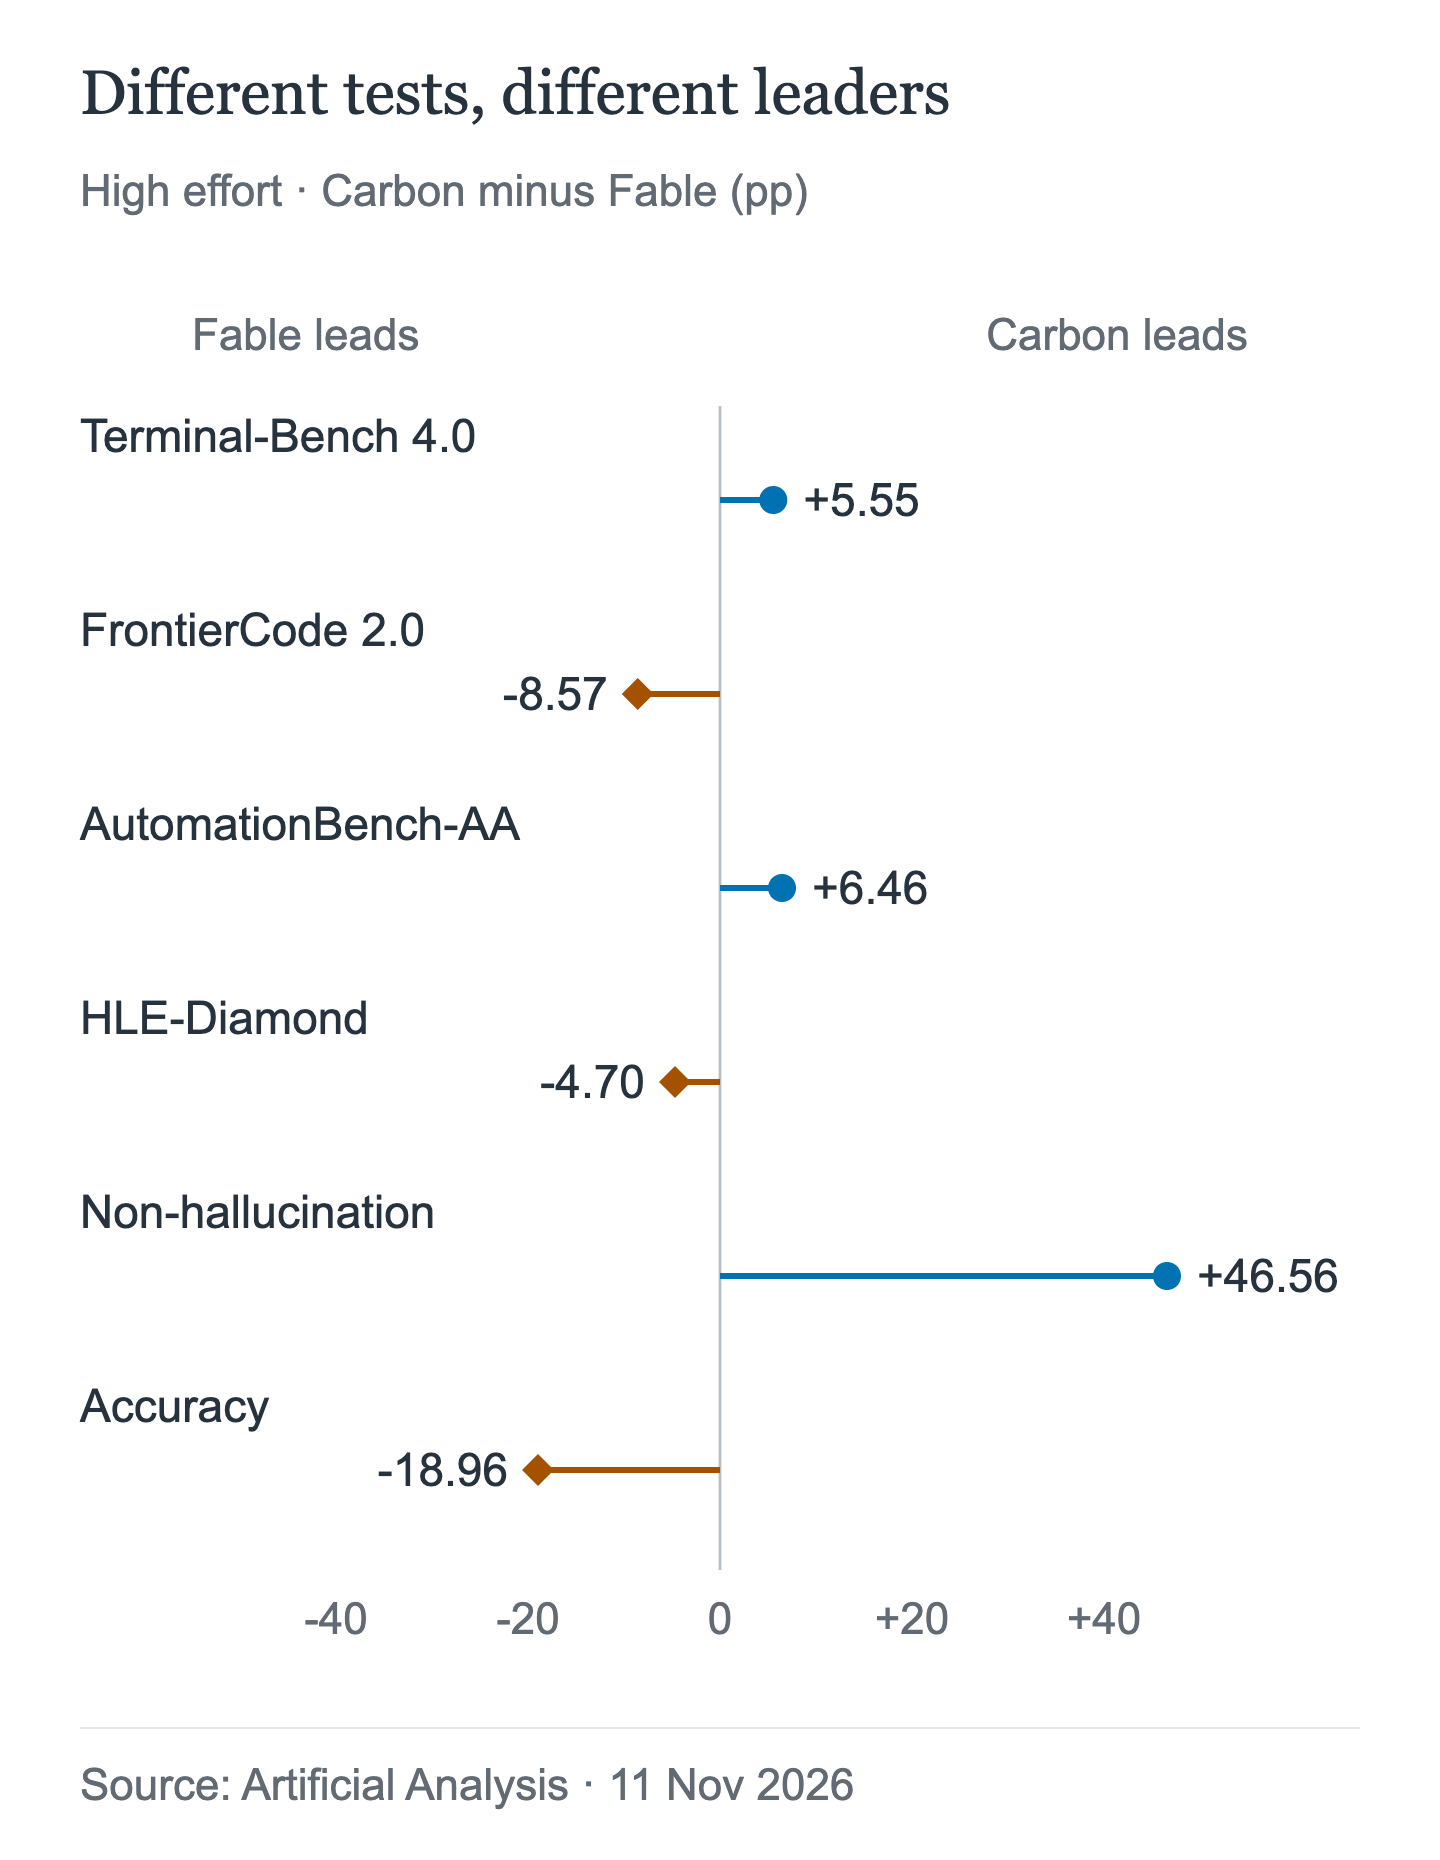
Това са разлики в процентни пунктове в независими тестове, а не обща оценка за качеството. По-голяма разлика в един бенчмарк не означава по-голямо общо подобрение на способностите. В частност, показателите „без халюцинации“ и точност оценяват различни резултати.
Fable води във FrontierCode 2.0 с 8.57 пункта при High, а в HLE-Diamond — с 4.7; Briefcase Elo е 1677.4 срещу 1610.6. FrontierCode е най-близкият бенчмарк до сложните промени в множество файлове. Carbon води в Terminal-Bench 4.0 с 5.55 пункта, а в AutomationBench — с 6.46; тези бенчмаркове оценяват изпълнение на команди, възстановяване след грешки и автоматизация.
Разликата при липсата на халюцинации е най-голямата в таблицата: 88.58% за Carbon срещу 42.02% за Fable при High. Точността показва обратното — 58.27% срещу 77.23%. При Carbon е по-малко вероятно да се измислят факти, но и по-малко вероятно да се даде правилен отговор. За агент, който не бива да си измисля API, това може да е предимство; за агент, който трябва да отговаря правилно, точността на Fable е по-добър показател.
По-голямото усилие не винаги води до по-добър резултат: оценката на Fable Max във FrontierCode — 48.76 — е малко под резултата на High от 49.13, а в Terminal-Bench остава 59.6.
Таблицата на Anthropic
Страницата на Anthropic за представянето публикува сравнителна таблица с модели на различни доставчици, сред които и Carbon. Настройките ѝ се различават от тези на AA: Fable е изпълнен при Xhigh, най-високото му публикувано ниво на усилие, а Carbon — при Medium. Сравнявайте резултатите само в рамките на тази таблица.
| Бенчмарк | Fable 5.2 | Carbon |
|---|---|---|
| FrontierCode 2.0 | 49.1 | 41.1 |
| FrontierSWE v2 | 69.9 | 61.2 |
| AutomationBench | 51.4 | 53.9 |
| TB-Science 0.1 | 74.6 | 64.8 |
| OSWorld 2.1 | 89.3 | 81.5 |
| Briefcase Elo | 1785 | 1611 |
| Chartography | 73.4 | 72.5 |
Забележка: данните са предоставени от Anthropic. Fable е при Xhigh — най-високото налично ниво на усилие; Carbon е при Medium. Скалата на Anthropic за AutomationBench се различава от тази на AA (51.4/53.9 срещу 71.36/77.82), затова сравнявайте резултатите само в тази таблица. Резултатът на Carbon от 41.1 във FrontierCode е при Medium; 40.56 на AA е при High и е измерен с друг тестов набор.
Посоката съвпада с тази при AA: Fable води във FrontierCode, FrontierSWE, OSWorld и TB-Science; Carbon води в AutomationBench с 2.5 пункта — по-малко от 6.5 при AA, но в същата посока. Таблицата подкрепя твърдението „Carbon е конкурентен при автоматизацията“, а не „Carbon е по-добрият модел за сложни задачи по програмиране“.
Собствената препоръка на Anthropic усложнява тезата, че „Fable е надграждане“: „За повечето задачи по програмиране и работа със знания препоръчваме потребителите да започнат с Claude Opus 5.5.“ Според компанията, при High effort Fable постига приблизително същия резултат като най-добрия резултат на Opus 5.5 (45.3% срещу 45.5%) при около половината цена на задача.
Колко струват токените
| Модел | Вход | Изход | Четене от кеш |
|---|---|---|---|
| Carbon, до 30 ноември | $2 | $10 | $0.10 |
| Carbon, от 1 декември | $4 | $20 | $0.20 |
| Fable 5.2 | $8 | $40 | $0.20 |
| Opus 5.5 | $4 | $20 | $0.20 |
Забележка: USD за 1M токена, официални цени. Записите в кеш за Fable струват $10 (5 минути) или $16 (1 час); Batch е с 50% отстъпка. Посочената цена за Carbon при кеширани данни е за четене; официалната цена за четене от кеш при Opus 5.5 е $0.20.
Цената на токен при Fable е двойно по-висока от стандартната цена на Carbon и четири пъти по-висока от промоционалната му цена. Съотношението е просто; сметката за задача — не. AA измерва $7.76 за Carbon High при $4/$20 срещу $9.08 за Fable High, разлика от 17.0%. При цената на Google от $2/$10 същото използване струва около $3.88 — изчислена оценка. До 30 ноември Fable High струва приблизително 2.3 пъти повече на задача; от 1 декември разликата се връща на 17.0%.
При стандартни цени Fable Medium струва $3.80 срещу $6.59 за Carbon, тоест с 42% по-малко, въпреки че цената на токен е двойно по-висока. Carbon отнема 23.3 минути и използва повече токени; Fable — 7.8 минути. При промоционалната цена Carbon Medium струва приблизително $3.30, изчислено по същия начин, което е близо до цената на Fable; това предимство изчезва на 1 декември.
На задача Max струва 3.4 пъти повече от Carbon High ($26.54) и отнема 45.2 минути. По-големият разход не гарантира всеобхватно по-добър агент за програмиране: резултатът на Max във FrontierCode е малко под този на High.
AIHubMix предлага Carbon по промоционалната цена на Google. Данните за Fable тук са по официалните цени на Anthropic.
Разлики в поведението, които определят избора при внедряване
| Показател | Carbon | Fable 5.2 |
|---|---|---|
| Макс. изход | 65,536; до 1,048,576−вход* според нативната версия | 128,000 |
| Контекст | 1,048,576 (нативен за Google) | 1M |
| Мислене | low / medium / high; по подразбиране medium | адаптивно; по подразбиране high |
| Принудителен избор на инструмент | документиран е auto* | any / извикването на инструмент връща 400 |
| Параметри за семплиране | игнорират се; премахнете ги | някои стойности връщат 400 |
| Съхранение | не е посочено като ограничение | 30 дни; няма ZDR |
| Вход | текст в AIHubMix | текст, изображение, PDF† |
| Крайна дата на знанията | март 2026 г. | юни 2026 г. |
Забележка: *По-високите ограничения на Carbon са възможности за дълго декодиране, нативни за Google; AIHubMix понастоящем документира само текстов вход и Chat Completions, така че поддръжката през шлюза не е потвърдена. †Модалностите за вход при Fable са посочени в индекса на моделите на AIHubMix. *AIHubMix документира tool_choice="auto", но поддръжката специално за Carbon не е потвърдена. Документираното ограничение на модела Fable за изход е 128,000. ZDR означава съхранение на данни за нулев период.
Принудителното използване на инструмент е сериозно препятствие при Fable: „Принудителното използване на инструмент (типовете tool_choice any и tool) връща грешка 400.“ Агент, който задължително трябва да извиква конкретен инструмент на всеки ход, не може да използва Fable без промени. Ръководството на Google за Carbon препоръчва последователни ходове за изпълнение на инструменти; в ръководството си за Gemini AIHubMix документира tool_choice="auto", но поддръжката на инструменти за Carbon през шлюза все още не е потвърдена.
Политиката за съхранение е пречка при Fable. В общия преглед се посочва, че той „изисква съхранение на данни в продължение на 30 дни и не е достъпен при нулево съхранение на данни, освен ако Anthropic не го разреши изрично“. Документацията на Carbon, както е разгледана тук, не посочва подобно ограничение; това не е гаранция. Преди внедряване екипите, работещи в регулирани отрасли, трябва да потвърдят и двете политики.
Стандартното ограничение от 65,536 токена при Carbon покрива повечето редакции; генерирането на цели файлове може да го надхвърли. Фоновият режим на Google може да достигне до 1,048,576 минус входните токени, таксува преходите между сегментите и може да върне incomplete с празен текст, като въпреки това таксуването продължава. AIHubMix не е документирал този режим. При Fable 128,000 токена се връщат в един отговор.
При нито един от двата модела мисленето не може да бъде изключено. Carbon предлага low, medium и high, използва medium по подразбиране и игнорира параметрите за семплиране. При Fable „адаптивното мислене винаги е включено и не може да бъде изключено“; по подразбиране е high, а някои стойности за семплиране връщат грешка 400.
Google предостави Carbon на защитниците чрез програмата си Fairwind още преди общата му достъпност. Класификаторите на Fable блокират заявки за тестове за проникване и експлойти и пренасочват към други модели задачи в областта на киберсигурността и биологията. При тестовете за сигурност поведението при отказ е по-важно от резултата в ред от таблица с бенчмаркове.
Opus 5.5 като референтен модел
Opus 5.5 не е конкурентът, но е собствената отправна точка на Anthropic. При $4/$20 той получава 59.11 в AA, струва $10.04 на задача, отнема 25.0 минути, а първият му токен пристига след 356.4 секунди — най-бавното време в таблицата (редът на AA е при Max effort; настройката по подразбиране е medium). Той печели по Briefcase Elo с 1800.6, но изостава от Fable High във FrontierCode и от Carbon High в Terminal-Bench. Въпреки това Anthropic продължава да препоръчва Opus 5.5 като отправна точка за повечето задачи по програмиране.
Кой модел да изберете
Изберете Fable 5.2, когато преобладават сложните промени в кода и искате най-добрите измерени резултати във FrontierCode и HLE. При Medium е по-евтин и по-бърз — $3.80 и 7.8 минути срещу $6.59 и 23.3 за Carbon — докато Carbon има по-висок резултат по индекса AA. Изберете го за вход с изображения, крайна дата на знанията юни 2026 г. или ако съхранението за 30 дни и невъзможността за принудителни извиквания на инструменти са приемливи.
Изберете Carbon, когато работата в терминал е основна: цикли на тестване и поправки, автоматизация на shell и операции в няколко стъпки. Той има по-високи резултати в посочените редове за Terminal-Bench 4.0 и AutomationBench-AA и е по-евтин при High effort до 30 ноември. Контекстът му, интегриран с Google, и ограниченията за дълъг изход не са потвърдени през AIHubMix; използвайте го само с текст и tool_choice="auto", след като потвърдите поддръжката на инструменти от Carbon. Резултатът му за липса на халюцинации е по-висок, а точността — по-ниска.
Изберете Opus 5.5 като препоръчана от Anthropic отправна точка с балансиран профил; приемете бавното получаване на първия токен при Max effort.
Не избирайте нито един от двата за интерактивна латентност: първите токени при High effort идват след 30.4 секунди при Fable и 67.1 при Carbon, а 23.2 секунди при Carbon Medium все още са далеч от скоростта на чат.
Използвайте и двата през AIHubMix
AIHubMix предоставя достъп до двата модела с един ключ и обща крайна точка за chat completions. ID на Carbon е gemini-4-carbon; страницата на модела описва chat completions, текстов вход и началната цена на Google. ID на Fable 5.2 е claude-fable-5-2; AIHubMix посочва Chat Completions, Responses и Anthropic Messages, контекст от 1M и максимален изход от 128K. Описаните възможности на Carbon са по-ограничени: chat completions, а не нативният Gemini API. Шлюзът също така прави повторен опит с най-добрия следващ доставчик, така че поведението може да се различава от това при внедряване с един доставчик.
Ръководството за бърз старт обхваща удостоверяването и базовия URL адрес. Тест с минимална заявка може да провери дали и двата ID работят с един и същ ключ; за тази чернова не е провеждан тест на живо:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

for model in ("gemini-4-carbon", "claude-fable-5-2"):
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "Reply with OK."}],
        max_tokens=4096,
    )
    print(model, response.choices[0].message.content)
Това проверява маршрутизирането, а не възможностите: няма инструменти и няма дълъг изход. За реално сравнение изпълнете една и съща следа на агента с двата ID и запишете времето за задача, използването на токени и неуспешните изпълнения. Страницата за сравнение представя контекста, протоколите и цените един до друг.
Често задавани въпроси
Gemini 4 Carbon по-добър ли е от Fable 5.2 за агентно програмиране?
Нито един не е най-добър във всяка част от работата. Fable 5.2 води във FrontierCode 2.0 и общия индекс при High effort; Carbon води в Terminal-Bench 4.0 и AutomationBench. Изберете според работното натоварване, което агентът действително изпълнява.
Защо Fable 5.2 струва четири пъти повече от Carbon?
По официалните цени Fable струва $8/$40 за милион токени спрямо началната цена на Carbon от $2/$10, тоест четири пъти повече за входа и изхода. Спрямо стандартната цена на Carbon от $4/$20, валидна от 1 декември, разликата е двукратна.
Наистина ли Fable 5.2 струва по-малко за задача при Medium?
При стандартните цени — да: $3.80 спрямо $6.59 за Carbon Medium, а времето е 7.8 минути спрямо 23.3. Началната цена на Carbon за токени намалява разликата; сравнението по стандартни цени е по-устойчиво във времето.
Може ли Fable 5.2 да наложи извикване на инструмент?
Не. Anthropic посочва, че стойностите any и tool за tool_choice връщат грешка 400. Агентите, които изискват принудително извикване, се нуждаят от различен цикъл или друг модел.
По-малко вероятно ли е Carbon да халюцинира от Fable 5.2?
Според показателя за липса на халюцинации Omniscience на AA — да: 88.58% спрямо 42.02% при High. Точността му обаче е по-ниска — 58.27% спрямо 77.23%, така че и вероятността да даде правилен отговор е по-малка.
Могат ли и двата модела да се използват през AIHubMix с един ключ?
Да. Използвайте gemini-4-carbon и claude-fable-5-2 с един и същ ключ и базов URL адрес. AIHubMix описва chat completions за Carbon и chat completions, Responses и Messages за Fable.
Прочетете още: серията Gemini 4 Carbon
- Преди да изберете конкурентен модел, изяснете въпроса за събратята: Gemini 4 Carbon срещу Argon: еднаква цена — кога си заслужава Carbon?
- След като включите Carbon в работния процес, първите грешки 400 и изтичания на времето обикновено се дължат на конфигурацията, а не на модела: Миграция на Gemini 4 Carbon API: грешки 400, изтичане на времето и ограничения на изхода
Източници
- Gemini 4 Carbon вече е наличен — Google, 10 ноември 2026 г.
- Claude Fable 5.2 — Anthropic, 9 ноември 2026 г.
- Общ преглед на Claude Fable 5.2 — документация на Anthropic.
- Gemini 4 Carbon и Claude Fable 5.2 — Artificial Analysis, моментна снимка от 11 ноември 2026 г.
- Gemini 4 Carbon в AIHubMix — страница на модела и цени.