AIHubMix 為 API 流量營運自建的全球加速網路。在評估第三方加速服務商後,我們發現其延遲與穩定性不足以支援正式環境中的 AI 工作負載,因此自行部署邊緣節點、監控系統與流量調度機制。本文將說明實測結果及背後的網路架構。
實測結果
以下數據來自調整調度演算法後,持續進行的正式環境監控。
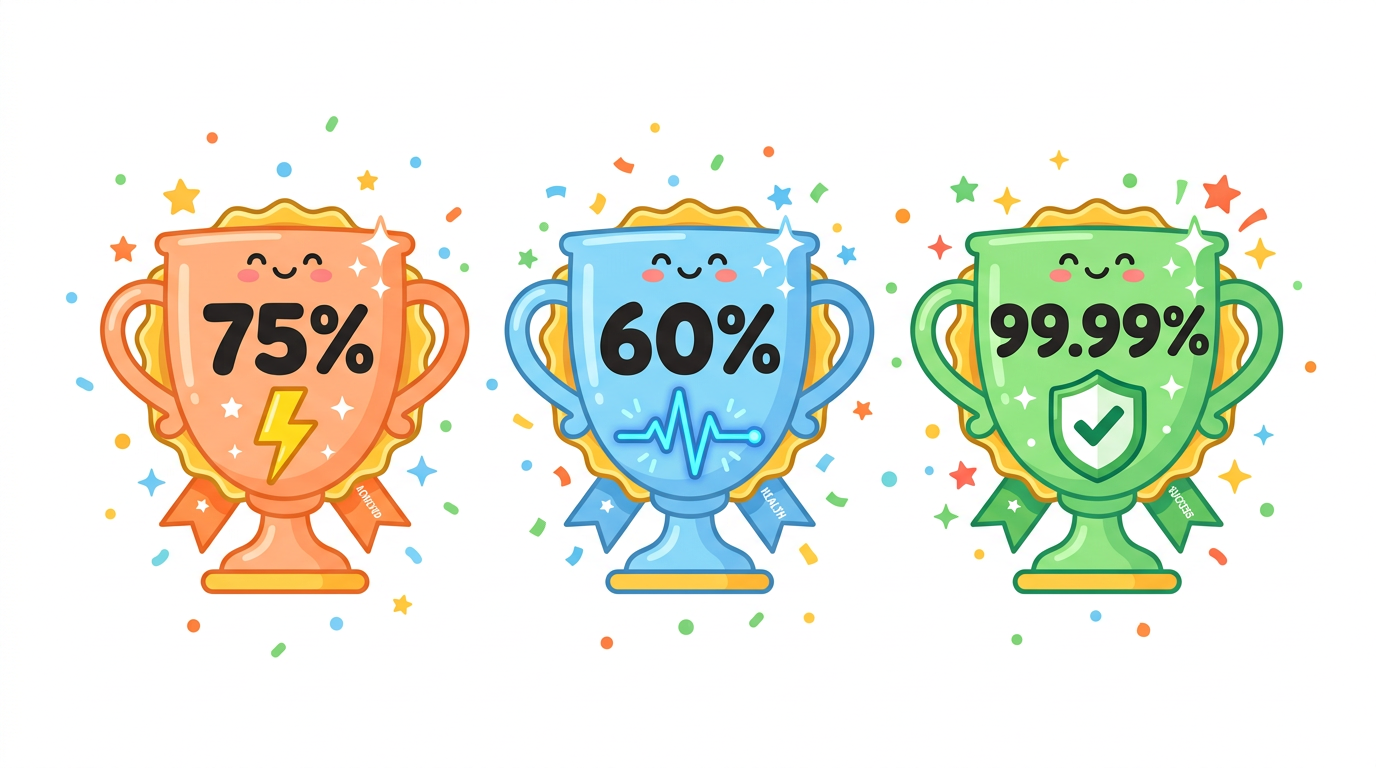
回應延遲降低 75%
端對端 API 延遲平均降低 75%。在串流情境中,這主要能改善首 token 延遲(TTFT),也就是從送出請求到收到第一個輸出 token 的時間,決定了聊天應用程式的回應速度。
延遲波動降低 60%
請求之間的延遲差異降低 60%。對正式環境中的應用程式而言,延遲一致性十分重要:它能讓面向使用者的回應時間更可預測,並減少尾端延遲造成的逾時。
服務可用性達 99.99%
以正式環境流量測得的可用性達 99.99%。這項數據涵蓋所有時段,包括週末與假日。
架構
自建邊緣節點
此網路使用部署於多個區域的專用加速節點,不依賴任何單一線路或雲端供應商。每個節點都必須通過延遲、封包遺失率與尖峰負載基準測試,才能投入正式環境;未達門檻的節點會從資源池中移除。系統會為每次 API 呼叫選擇最快的可用路徑。
每分鐘執行探測的健康監控
分布於多個區域的探測器每分鐘都會對每個節點執行端對端健康檢查,涵蓋三個面向:延遲、成功率與穩定性。整個網路每 60 秒掃描一次,因此可在一個探測週期內偵測到節點異常。
具備自動故障切換的流量調度
調度系統每分鐘根據四個滑動視窗的探測資料,重新計算每個節點的健康分數:1 分鐘、5 分鐘、15 分鐘和 1 小時。流量會導向目前分數最高的節點。節點效能下降時,系統會在毫秒內自動切換至健康節點,無須人工介入。
自動化維運
節點管理、路由最佳化、設定部署、憑證輪替與故障復原皆已自動化。事件處理不仰賴值班人員的回應時間:探測器一偵測到異常,調度系統就會立即將效能下降的節點移出輪替。
這對您的應用程式有何助益
- 串流回應的 TTFT 更低且更穩定。
- 負載升高時,逾時錯誤與尾端延遲尖峰更少。
- 無須變更整合方式:標準 API 端點會自動套用加速。
常見問題
使用加速網路需要變更整合方式嗎?
不需要。加速功能會套用於平台入口層。現有的 API 端點、金鑰與請求格式皆維持不變。
節點健康狀態多久檢查一次?
分布式探測器每 60 秒掃描網路中的所有節點,從端到端測量延遲、成功率與穩定性。
節點效能下降時會發生什麼事?
調度系統每分鐘根據四個滑動視窗(1 分鐘、5 分鐘、15 分鐘、1 小時)重新計算健康分數,並自動將流量切換至健康節點。故障切換會在毫秒內完成。
最後更新:2026-06-01