
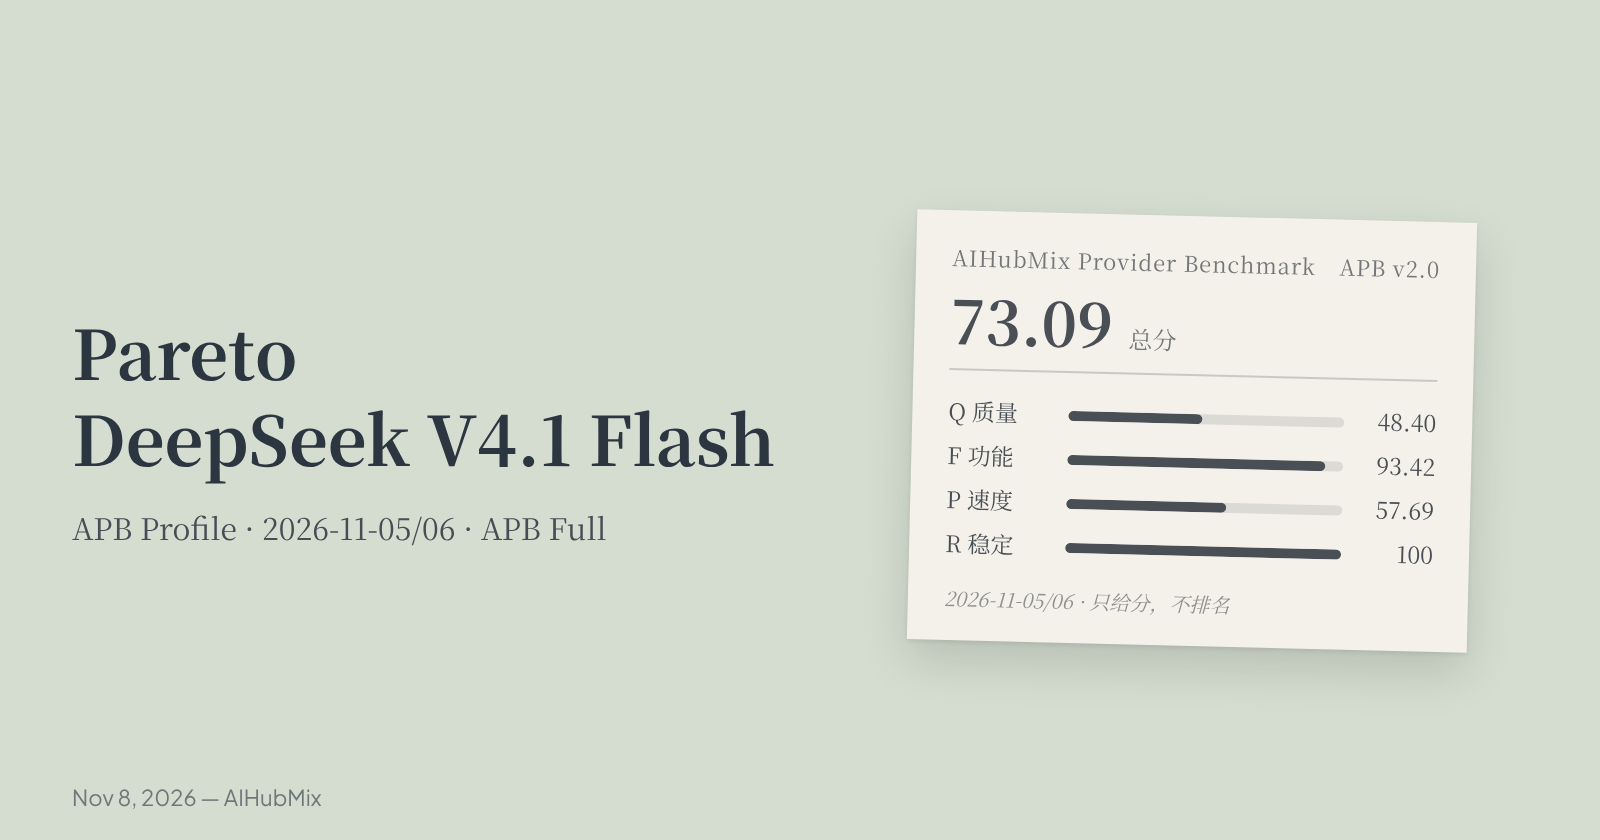
2026-11-05/06,DeepSeek V4.1 Flash 1017 在 Pareto 上進行 AIHubMix Provider Benchmark (APB) 完整測試套件。分數為 Q 48.40、F 93.42、P 57.69、K 27.58、R 100;整體指數為 73.09。此 APB Profile 僅涵蓋 Pareto。模型列為 DeepSeek V4.1 Flash 1017。
本文僅報告分數,不提供排名或供應商建議。Q、F、P、K 和 R 為主要分數;整體指數是摘要數值,沒有信賴區間。採用的標準為 AIHubMix Provider Benchmark Standard v2.0。
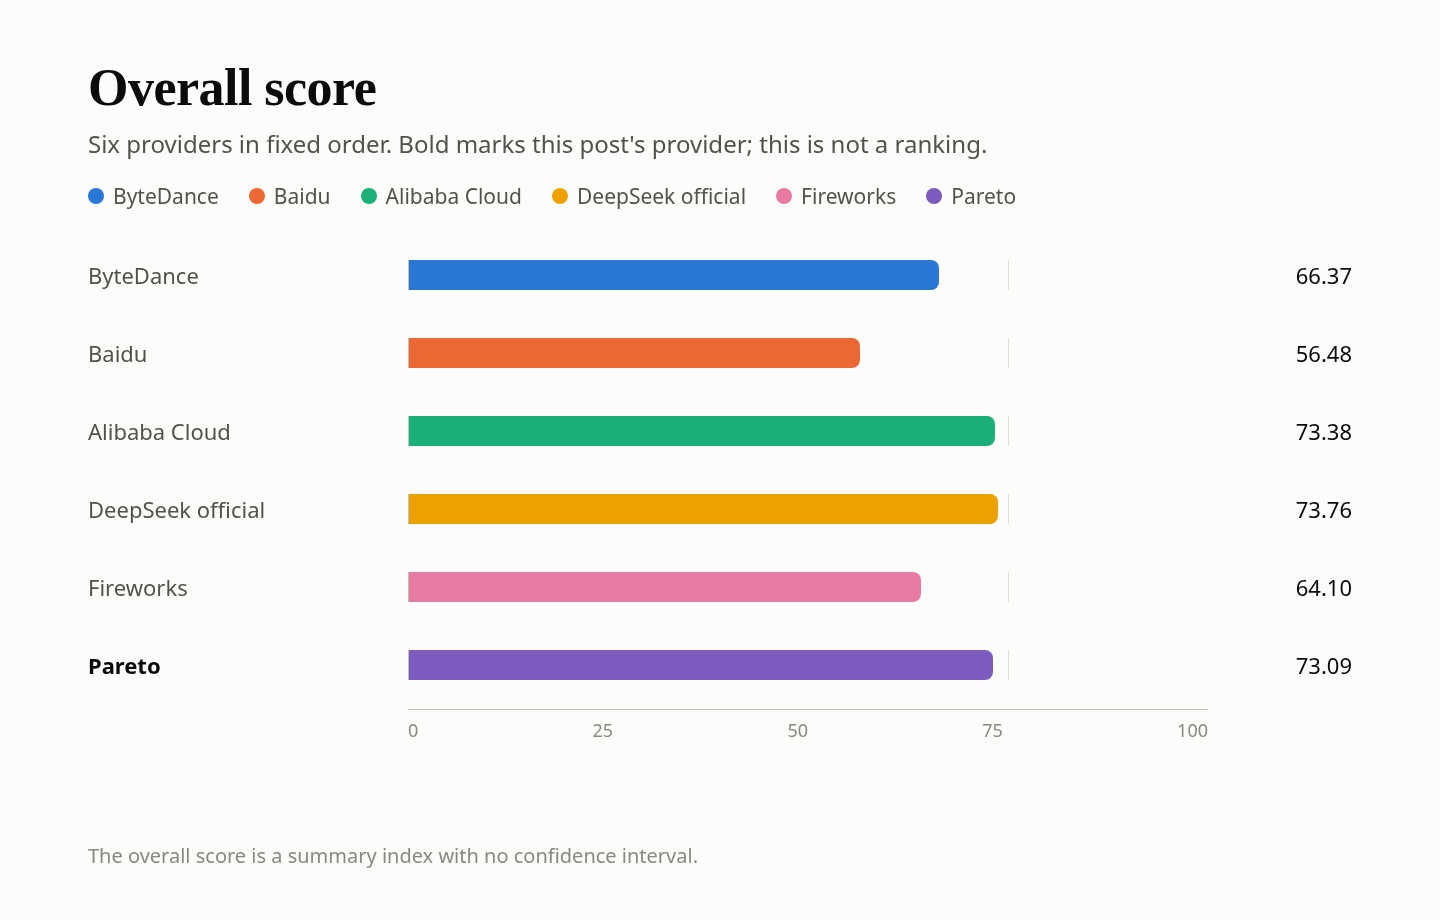
六家供應商的分數
粗體標示本文所測的供應商。供應商順序固定,並非排名。K 是 P 的子分數,占 20%。整體指數是摘要數值,沒有信賴區間。DeepSeek 官方管道與 Alibaba Cloud 相差 0.37,兩者無法區分。
快速一覽
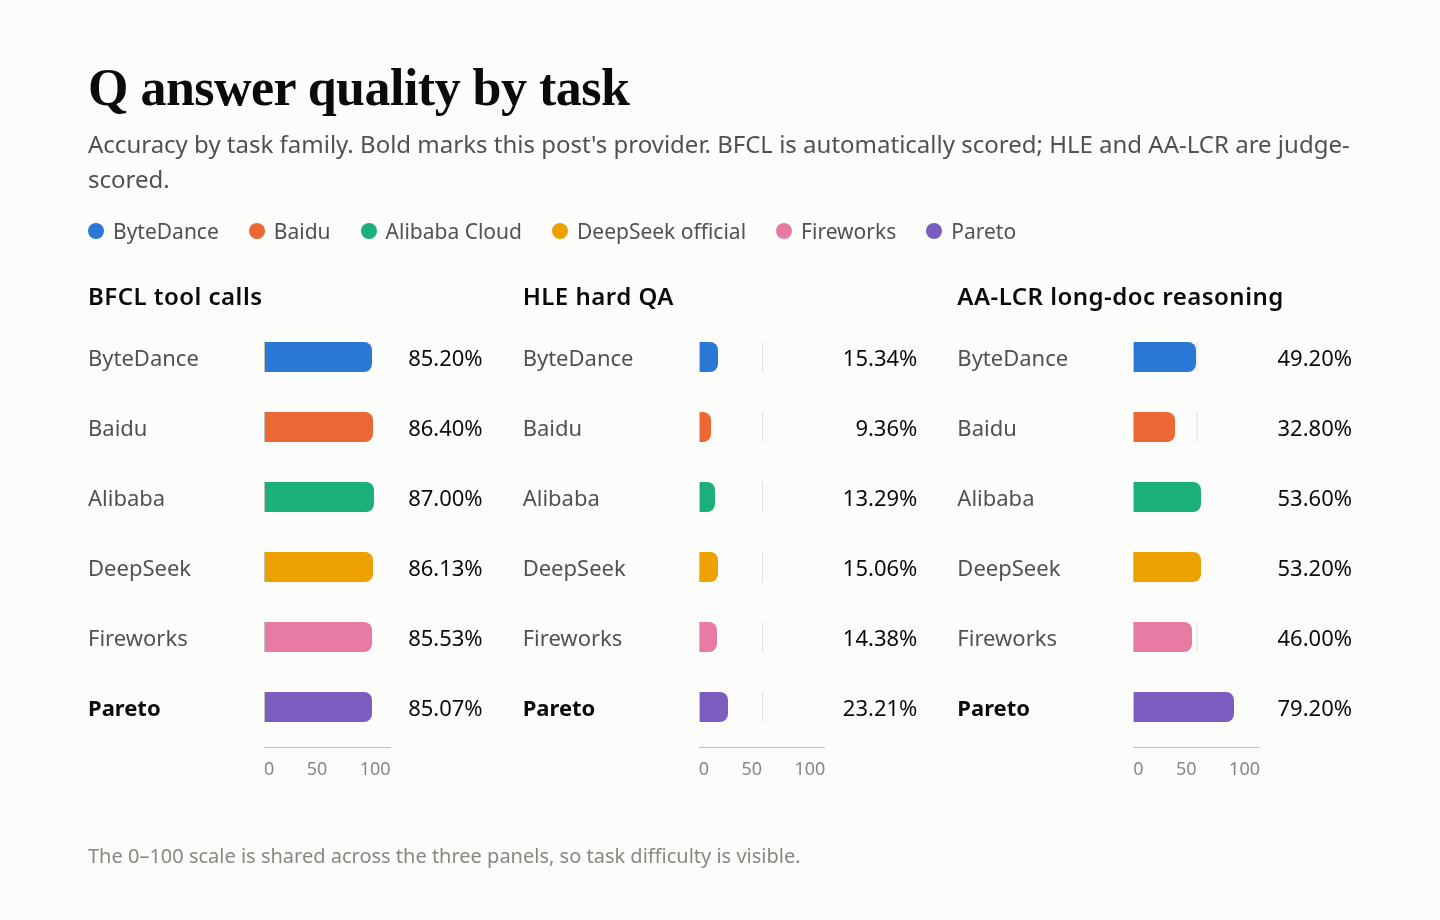
- Q — 答案品質:48.40。BFCL 85.07%、HLE 23.21%、AA-LCR 79.20%。相較官方管道:+5.94 個百分點,95% CI 為 +3.54 至 +8.36。HLE 有 996 次服務失敗,大多因思考內容耗盡輸出長度預算而遭截斷;這些結果均計為錯誤。
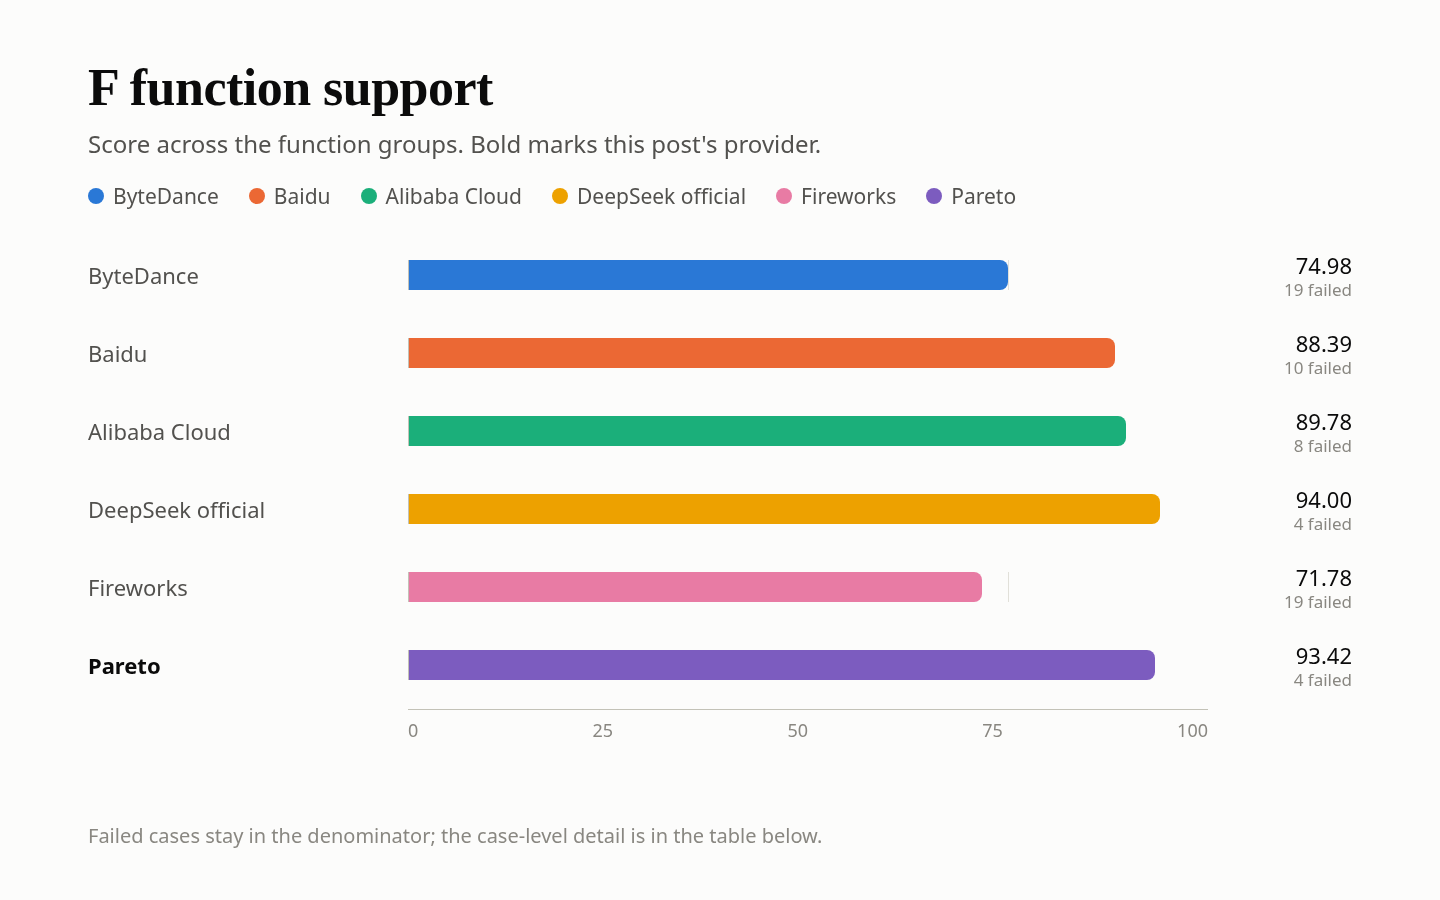
- F — 功能支援:93.42。33 項計分檢查中有 29 項通過(串流 23/27、錯誤 3/3、用量計量 3/3)。另有 147 項檢查未納入分母。4 項失敗中,3 項是在停止序列請求中回傳空白主體,另有 1 項串流文字測試資料與預期結果不完全相符。
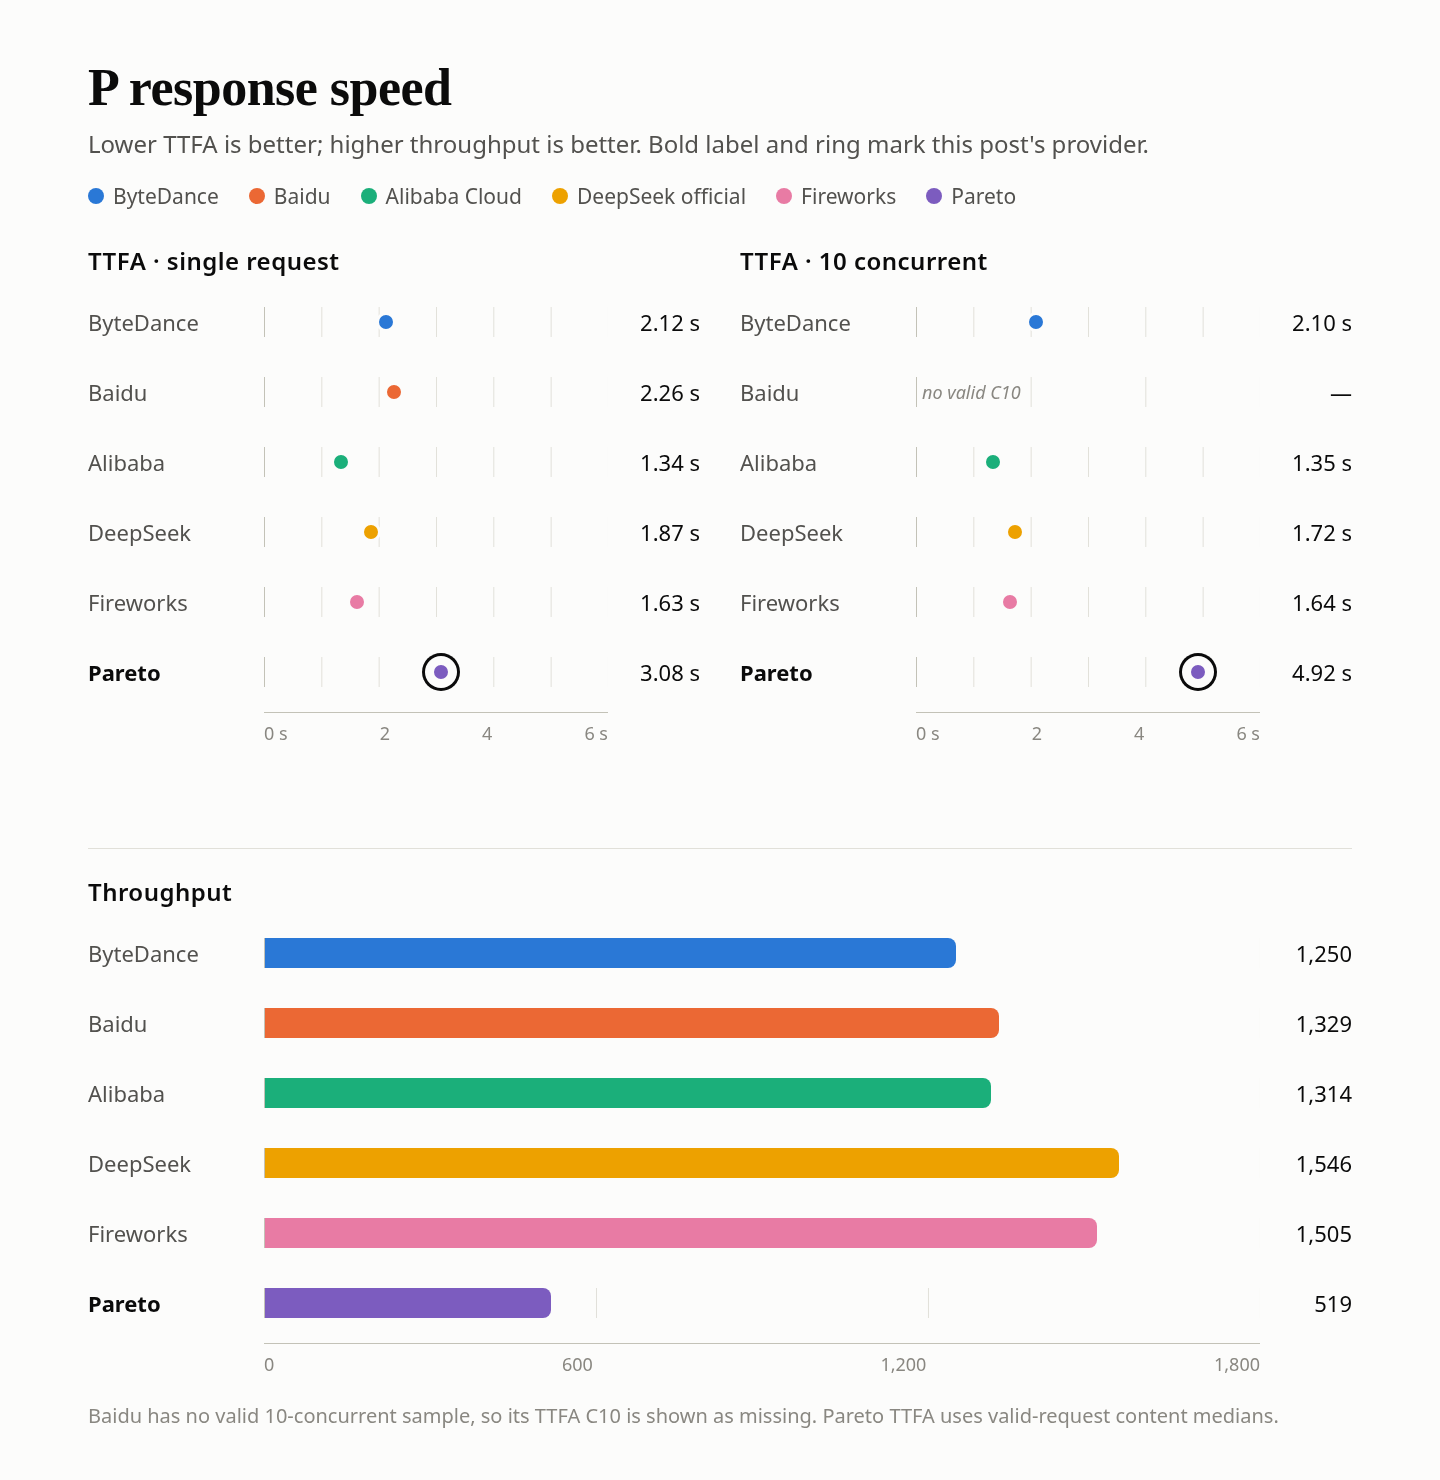
- P — 回應速度:57.69。回應分數為 65.22,快取 K 占 20%。有效請求的 TTFA 中位數:單一併發為 3.08 s,10 個併發為 4.92 s;包含無效請求的計分中位數則為 5.85 s 和 6.13 s。180 次探測中有 110 次有效;70 次無效,原因是思考內容耗盡速度測試的輸出預算。
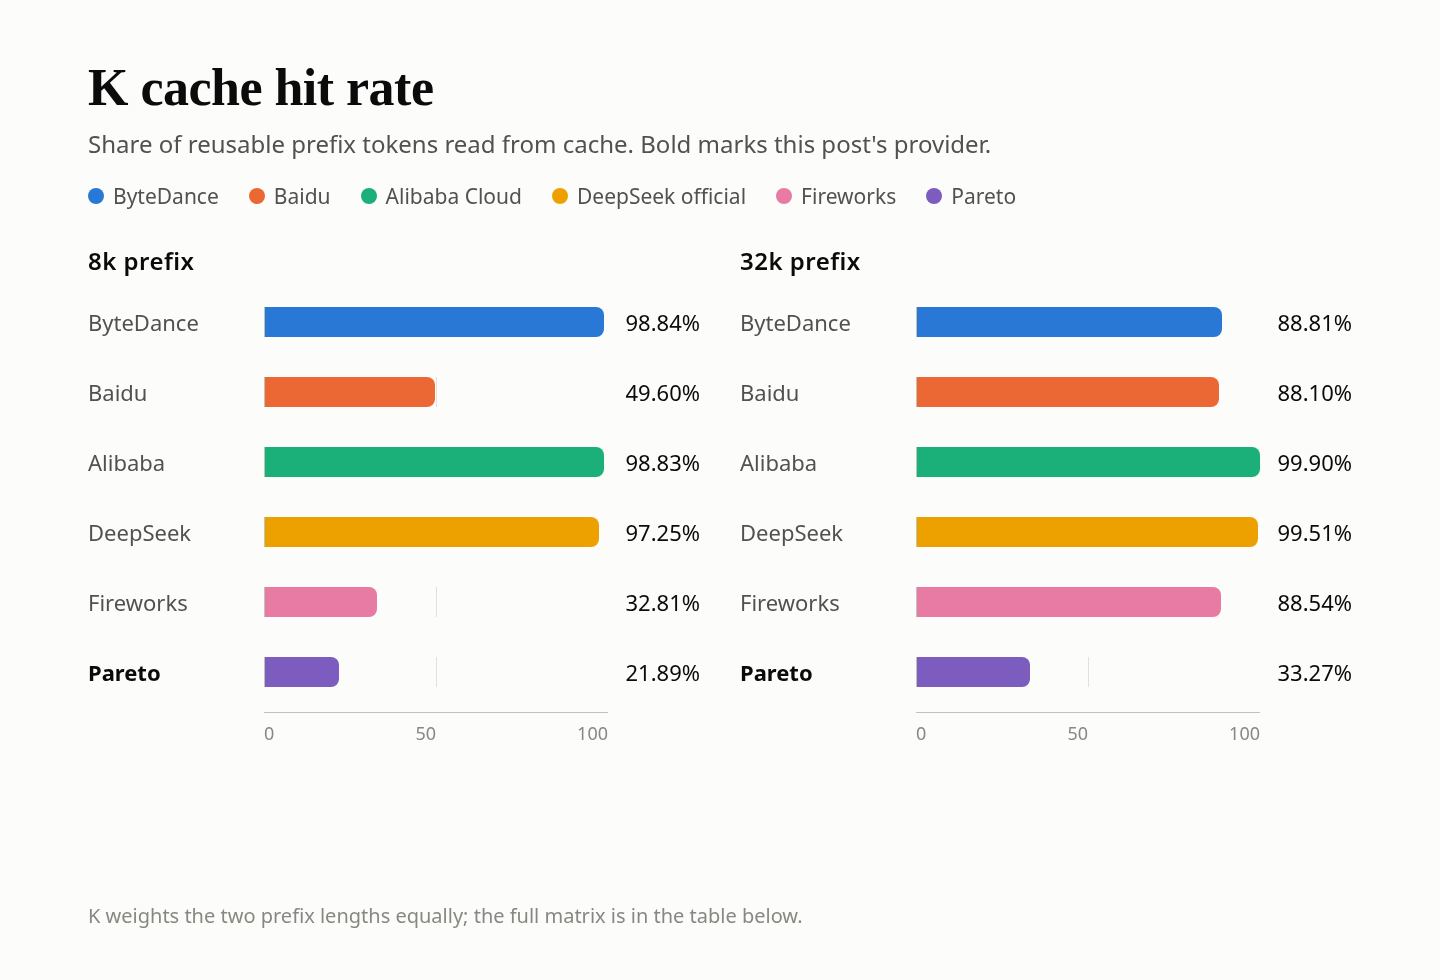
- K — 快取:27.58。8k 熱快取命中 2/9(讀取 15,872 / 可重用 72,504);32k 熱快取命中 3/9(讀取 96,000 / 可重用 288,513)。依預設設定計分。
- R — 服務穩定性:100。專用請求 300/300 均在第一次嘗試時成功。
測試設定
| 項目 | 設定 |
|---|---|
| 模型 | DeepSeek V4.1 Flash 1017 |
| 請求的模型 ID | deepseek/deepseek-v4.1-flash |
| 存取路徑 | Pareto,使用上述模型 ID |
| 參數 | temperature 1.0、max_tokens 16,384、timeout 300 s;僅使用串流請求 |
| 思考模式 | 已啟用高強度思考 |
| 時間 | 2026-11-05/06 UTC+8;快取測試為 2026-11-06 使用預設設定重新測試 |
| 樣本數 | Q 4,250(BFCL 500×3、HLE 250×10、AA-LCR 25×10);F 60×3;P 90+90;R 300;K 30 |
| 備註 | 本次測試使用高強度思考;系列中的其他五家供應商均未使用思考模式。功能支援依可使用串流功能的子集計分;快取測試使用預設設定。 |
請求使用 AIHubMix 的快速入門;模型 ID 請見模型頁面。
Q — 答案品質:48.40
測試套件執行 500 題 BFCL × 3 輪、250 題 HLE × 10 輪,以及 25 題 AA-LCR × 10 輪。BFCL 使用自動評分;HLE 和 AA-LCR 由 deepseek-flash 評判。三個題型使用的題目與其他供應商相同。移除 10 個無法評分的答案後,剩下 4,240 個計分樣本。
| 任務 | 題數 | 答對 | 正確率 | 失敗 |
|---|---|---|---|---|
| BFCL 工具呼叫 | 500 × 3 | 1,276/1,500 | 85.07% | 0 |
| HLE 高難度問答 | 250 × 10 | 578/2,490 | 23.21% | 996 |
| AA-LCR 長文件推理 | 25 × 10 | 198/250 | 79.20% | 0 |
| 總計 · 95% CI 45.39%–51.26% | — | 2,052/4,240 | 48.40% | 996 |
失敗結果仍納入分母並計為答錯:HLE 有 996 次因思考內容耗盡輸出長度預算而遭截斷。在回傳完整答案的 1,494 次 HLE 嘗試中,有 578 次答對(約 38.7%)。
| BFCL 類別 | 通過 | 通過率 |
|---|---|---|
| simple_python | 333/360 | 92.50% |
| multiple | 269/300 | 89.67% |
| parallel | 265/300 | 88.33% |
| parallel_multiple | 203/240 | 84.58% |
| irrelevance | 104/150 | 69.33% |
| ahm_multi_turn | 102/150 | 68.00% |
simple_python 通過 333/360(92.50%)、multiple 通過 269/300(89.67%)、ahm_multi_turn 通過 102/150(68.00%),irrelevance 通過 104/150(69.33%)。
與其他五家比較
相較官方管道的百分點差異;誤差線表示 95% 區間。區間跨過 0 代表無法區分。deepseek-flash 評判模型與受測模型屬於同一系列,且未經校準,因此評判可能較寬鬆。
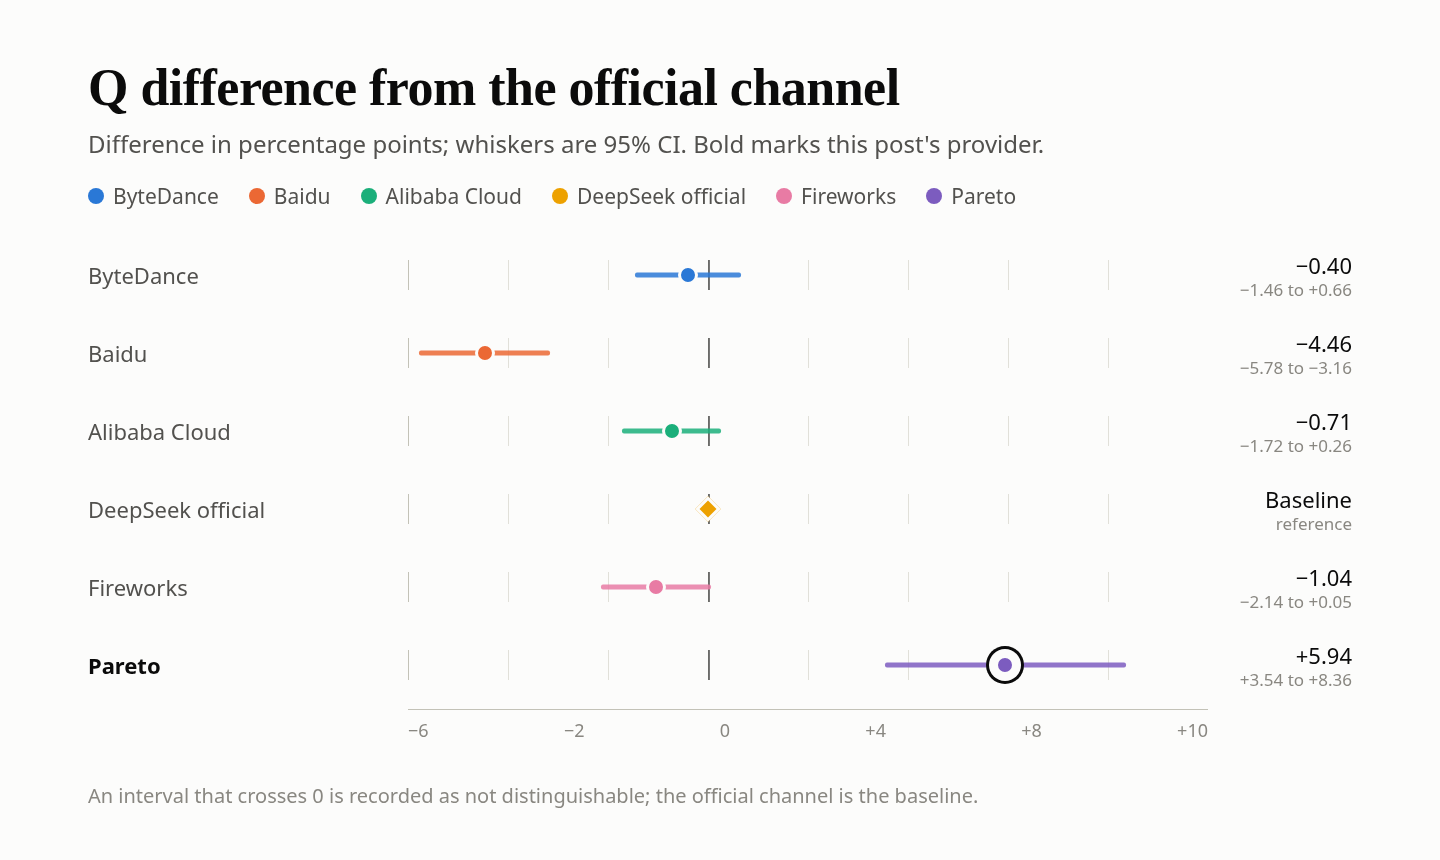
相較官方管道,數值差異為 +5.94(+3.54 至 +8.36)。
F — 功能支援:93.42
33 項計分檢查中有 29 項通過;147 項未納入計分。93.42 是依觀測到的群組重新正規化原始群組權重後得出的分數(串流 20%、錯誤 15%、用量計量 10%;合計 45%)。單純通過率 29/33 為 87.88%。工具、限制和上下文完全未納入計分。
| 案例群組 | 權重 | 通過 | 排除 | 群組分數 |
|---|---|---|---|---|
| 串流與訊息 | 20% | 23/27 | 3 | 85.19 |
| 工具介面 | 20% | — | 30 | — |
| 輸出限制 | 20% | — | 30 | — |
| 上下文與狀態 | 15% | — | 30 | — |
| 錯誤與復原 | 15% | 3/3 | 27 | 100.00 |
| 用量計量與快取 | 10% | 3/3 | 27 | 100.00 |
| 觀測值 / 加權值 | — | 29/33 | 147 | 93.42 |
「失敗的視窗數」表示案例未通過的三個視窗數量。
| 失敗案例 | 失敗視窗數 | 原因 |
|---|---|---|
| 串流停止 | 3/3 | 停止序列時主體為空白 |
| 串流文字 | 1/3 | 主體末尾多出句點,與測試資料不符 |
與其他五家比較
P — 回應速度:57.69
計分採用首個內容 token 的時間,而非首個任意 token 的時間。啟用思考模式時,模型會先輸出思考內容,再輸出可見的答案文字,因此等待內容的時間會比等待第一個封包更長。三個視窗中,每個視窗都以單一併發傳送 30 個請求,並以 10 個併發傳送 30 個請求,總計 180 個請求。
| 指標 | 結果 |
|---|---|
| 內容 TTFA | 計分中位數為 5.85 s(c=1)和 6.13 s(c=10);有效請求中位數為 3.08 s 和 4.92 s |
| 首個任意 token | 有效請求中位數為 1.46 s 和 1.76 s |
| TPOT | 較慢的計分區間為 4.87 ms/token |
| Goodput | 併發數 10 時為 519 token/s |
| 有效 | c=1 時 53/90、c=10 時 57/90,總計 110/180;70 次無效,因為思考內容耗盡速度測試的輸出預算(約 2,048 tokens) |
| 組成分數 | TTFA 24.59、TPOT 100.00、goodput 72.05;回應分數 65.22 |
| P 的組成 | 65.22 × 80% + 27.58 × 20% = 57.69 |
Goodput 分子不包含思考 tokens。
K — 快取:27.58
彙總讀取數據來自 2026-11-06 使用預設設定進行的重新測試。未提供逐請求快取矩陣(原始追蹤資料尚未遷移)。K 對兩種前綴長度採相同權重;K 占 P 的 20%。
| 前綴 | 熱快取命中 | 讀取 / 可重用 | 區段 |
|---|---|---|---|
| 8k | 2/9 | 15,872 / 72,504 | 21.89 |
| 32k | 3/9 | 96,000 / 288,513 | 33.27 |
| K(等權重) | 27.58 |
冷快取控制測試在各長度下均以 6/6 通過。
R — 服務穩定性:100
300 個請求以單一併發執行,涵蓋短文字、長輸入、工具呼叫和多輪對話歷史。只檢查首次回應的有效性與完整性;不評分答案,也不重試。Q 和 P 的失敗不會在此重複計算。
| 請求類型 | 首次嘗試成功 |
|---|---|
| 短文字 | 120/120 |
| 10k 長輸入 | 90/90 |
| 工具呼叫 | 60/60 |
| 多輪對話歷史 | 30/30 |
| 總計 · 95% CI 98.78%–100% | 300/300 |
常見問題
Q 48.40 涵蓋哪些內容?
BFCL、HLE 和 AA-LCR 共 4,240 個計分樣本:答對 2,052 題,正確率 48.40%,95% CI 為 45.39%–51.26%。相較官方管道,數值差異為 +5.94(+3.54 至 +8.36)。
為什麼 HLE 有 996 次服務失敗?
大多因思考內容耗盡輸出長度預算而遭截斷;這些結果仍留在分母中並計為錯誤。
為什麼 F 是 93.42,卻有 147 項檢查遭排除?
只計入可使用串流功能的子集。依觀測到的群組重新正規化群組權重;工具、限制和上下文完全未納入計分。
為什麼停止序列案例會失敗?
含有停止序列的請求在三個視窗中都回傳空白主體。
為什麼 180 次速度探測中有 70 次無效?
思考內容耗盡速度測試的輸出預算(約 2,048 tokens)。
R 100 涵蓋哪些內容?
300 個專用請求全部在首次嘗試時有效;95% 信賴區間下限為 98.78%。Q 和 P 的失敗不計入 R。
繼續閱讀:DeepSeek V4.1 Flash 系列
- ByteDance 回報在停用思考模式後仍有思考 tokens:DeepSeek V4.1 Flash 在 ByteDance:工具呼叫符合預期,用量計量則否
- Baidu 的 Q 為 38.00、P 為 37.77:DeepSeek V4.1 Flash 在 Baidu:沒有可用管道能達到 Q 和 P
- Alibaba Cloud 的首個 token 時間為 1.34 s,快取分數為 99.37:DeepSeek V4.1 Flash 在 Alibaba Cloud:首個 token 1.34s、快取 99.37
- 官方管道是 Q 的基準,F 為 94.00:DeepSeek V4.1 Flash 在官方管道:F 94.00、15 次無效探測
- Fireworks 的停止序列回覆為空白,8k 快取命中 3/9:DeepSeek V4.1 Flash 在 Fireworks:停止序列回覆空白、快取命中 3/9


