

在 2026-11-03/04 的 APB Full 完整測試中,Pareto 的四項分數為 Q 44.58、F 93.42、P 57.69、R 100,總分為 68.72。8k 熱請求命中 2 次(共 9 次),32k 熱請求命中 3 次(共 9 次)。
2026-11-03/04,我們透過 AIHubMix 對 DeepSeek V4.1 Flash 1017 的六家供應商進行測試,採用 APB Full 測試套件,並為每家供應商使用相同的問題、參數和請求腳本。這份 APB Profile 僅涵蓋 Pareto:各部分測量的項目,以及測試結果。
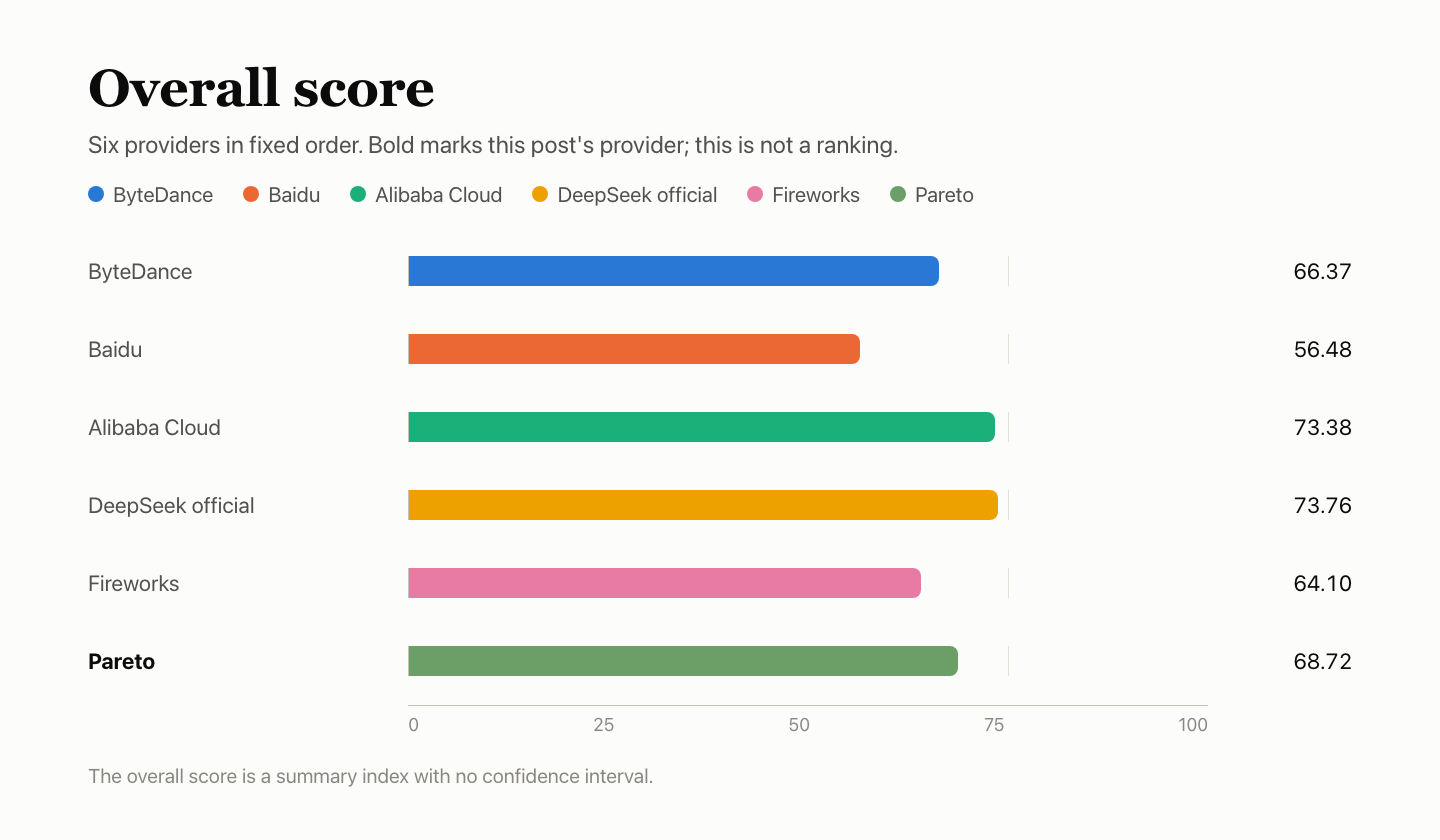
以下數字是分數,不代表排名或供應商推薦。首先列出 Q、F、P、R 四項分數;總分是摘要指標,不代表認證,也沒有信賴區間。計分規則定義於 AIHubMix Provider Benchmark Standard v2.0。
六家供應商的分數
| 供應商 | Q 品質 | F 功能 | P 速度 | K 快取 | R 穩定性 | 總分 |
|---|---|---|---|---|---|---|
| ByteDance | 42.05 | 74.98 | 84.37 | 93.83 | 100 | 66.37 |
| Baidu | 38.00 | 88.39 | 37.77 | 68.85 | 100 | 56.48 |
| Alibaba Cloud | 41.75 | 89.78 | 88.58 | 99.37 | 100 | 73.38 |
| DeepSeek 官方管道 | 42.45 | 94.00 | 86.14 | 98.38 | 100 | 73.76 |
| Fireworks | 41.42 | 71.78 | 79.51 | 60.68 | 100 | 64.10 |
| Pareto(本文) | 44.58 | 93.42 | 57.69 | 27.58 | 100 | 68.72 |
供應商依固定順序列出,不代表排名。K 是 P 的子分數,占 P 的 20%,另行列出供參考。總分依據 AIHubMix Provider Benchmark Standard 的組合規則計算,亦納入與官方管道的比較及證據完整度;並非直接對表中的四項分數加權。總分是沒有信賴區間的摘要指標。DeepSeek 官方管道與 Alibaba Cloud 的總分僅差 0.37,差異無法區分。
重點一覽
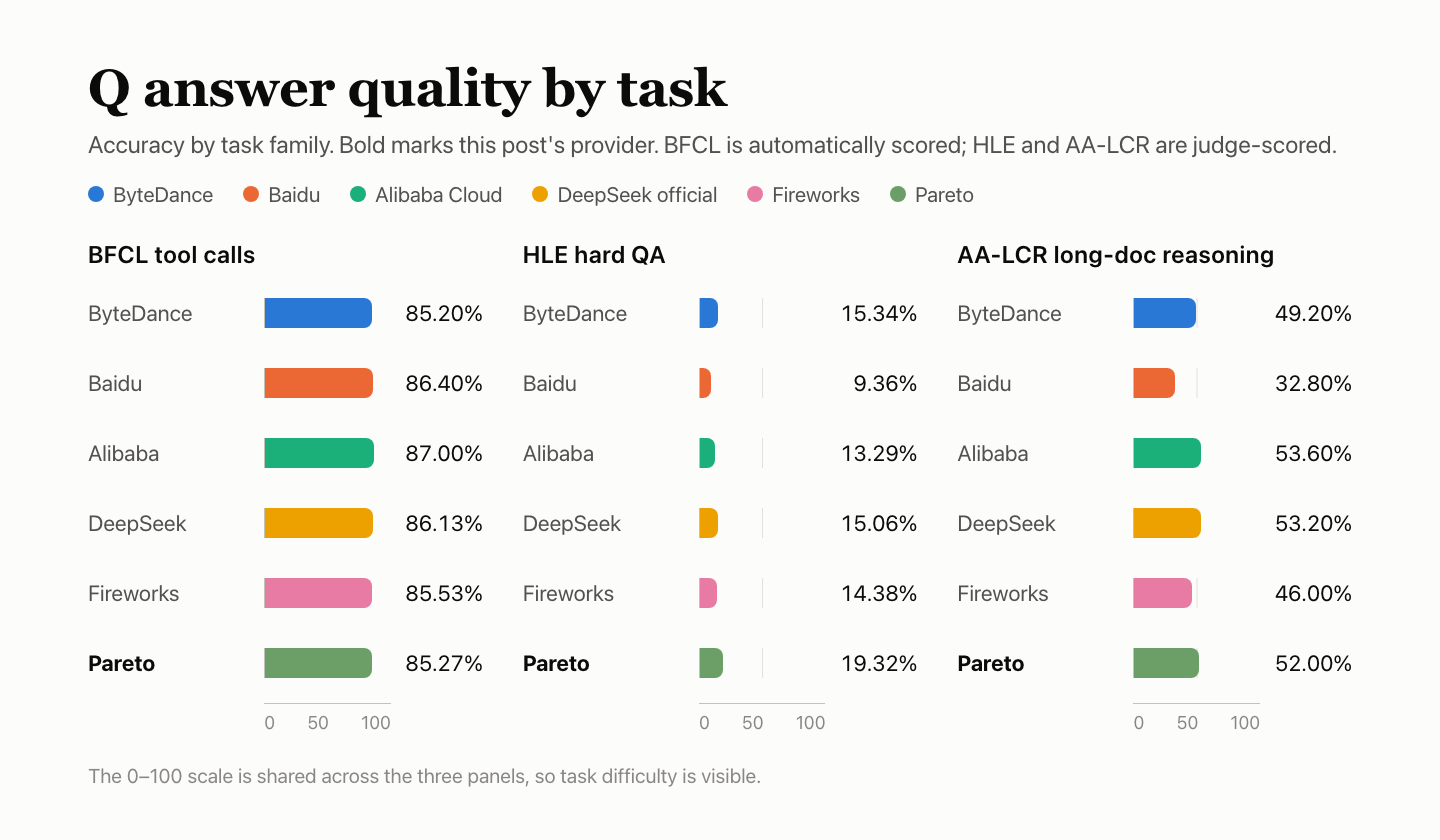
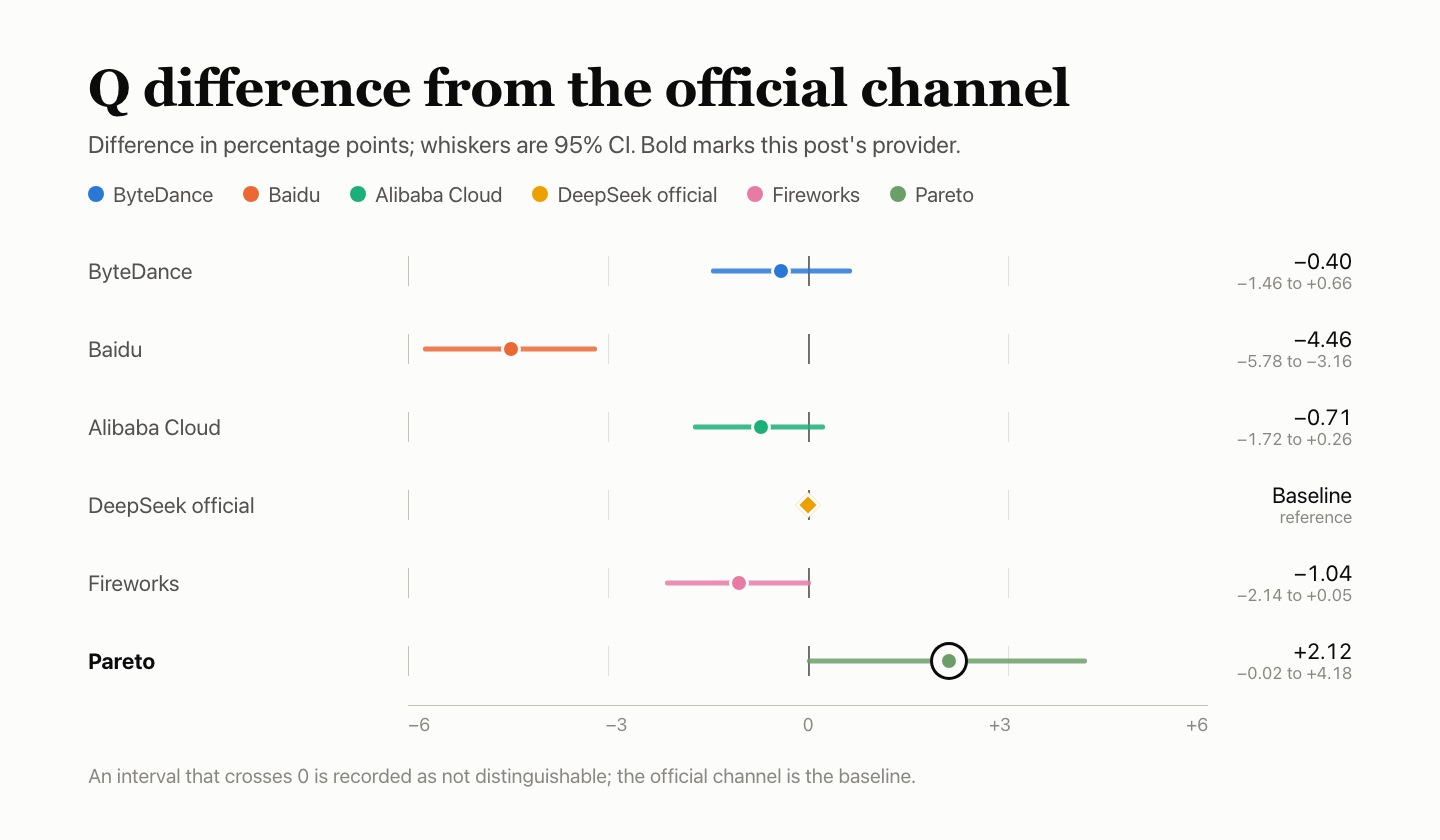
- 回答品質:Q 44.58,其中 BFCL 為 85.27%、HLE 為 19.32%、AA-LCR 為 52.00%。與官方管道的差距為 +2.12 個百分點,95% 區間為 −0.02 至 +4.18:差異無法區分。
- 功能支援:F 93.42,原始計分的 33 項檢查中有 29 項通過。工具呼叫與工具結果往返、平行及具名呼叫、JSON 模式和對話歷史,另有成功的串流紀錄;分數維持原值。
- 回應速度:P 57.69。單一並行的首個本文 token 中位數為 5.85 s,10 路並行為 6.13 s,TPOT 為 4.63 ms;180 次速度請求中有 110 次有效。
- 快取:K 27.58。8k 熱請求命中 2 次(共 9 次),32k 熱請求命中 3 次(共 9 次);沒有任何冷請求讀取快取。
- 服務穩定性:R 100。專用測試的 300 次請求皆首次成功。
測試設定
| 項目 | 詳細資料 |
|---|---|
| 模型 | DeepSeek V4.1 Flash 1017 |
| 請求的模型 ID | deepseek/deepseek-v4.1-flash |
| 回傳的模型名稱 | deepseek/deepseek-v4.1-flash |
| 存取路徑 | 透過 AIHubMix,使用供應商專屬的模型 ID;並非直接連線至供應商帳戶 |
| 參數 | 固定的 APB v2 請求設定檔,temperature 1.0、max_tokens 16,384、逾時 300 s、不自動重試 |
| 時間 | 2026-11-03 18:07 – 11-04 16:33;快取請求為 11-05 19:31 – 11-06 10:35;均為 UTC+8。六家供應商共用一台 Mac mini、一個網路和一個帳戶。 |
| 樣本數 | Q 4,250 個問題實例;F 180 項檢查;P 180 次請求;R 300 次;K 30 次 |
請求使用 AIHubMix 的 快速入門路徑和供應商專屬的模型 ID;其他供應商的 ID 列於模型頁面。模型本身的參數說明請參閱 DeepSeek 的API 文件。
Q — 回答品質:44.58
回答品質由三套測試組成:500 道 BFCL 題目各回答 3 次、250 道 HLE 題目各回答 10 次,以及 25 道 AA-LCR 題目各回答 10 次。BFCL 依自動規則評分;HLE 和 AA-LCR 則由裁判模型 deepseek-flash 判定正誤。六家供應商收到相同的問題,三套測試合併計算為一個正確率。因問題無法評分而移除 10 個答案,最後留下 4,240 個可評分的問題實例。
| 測試套件 | 問題數 × 回合數 | 答對 | 正確率 | 服務失敗 |
|---|---|---|---|---|
| BFCL 工具呼叫,自動評分 | 500 × 3 | 1,279/1,500 | 85.27% | 0 |
| HLE 高難度問答,由裁判評分 | 250 × 10 | 481/2,490 | 19.32% | 0 |
| AA-LCR 長文件推理,由裁判評分 | 25 × 10 | 130/250 | 52.00% | 0 |
| 總計 · 95% 區間 41.57%–47.49% | — | 1,890/4,240 | 44.58% | 0 |
每個問題實例都收到完整答案;沒有服務失敗。
| BFCL 類別 | 通過 | 通過率 |
|---|---|---|
| simple_python:一個函式,呼叫和引數正確 | 333/360 | 92.50% |
| multiple:從多個函式中選出正確的一個 | 269/300 | 89.67% |
| parallel:同時多次呼叫一個函式 | 265/300 | 88.33% |
| parallel_multiple:同時呼叫多個函式 | 203/240 | 84.58% |
| irrelevance:沒有相關函式,因此不呼叫 | 109/150 | 72.67% |
| ahm_multi_turn:三階段工具鏈 | 100/150 | 66.67% |
每道 BFCL 題目回答 3 次;表格加總這 3 個回合的結果。
與其他五家比較
| 供應商 | BFCL | HLE | AA-LCR | 合併 | 與官方管道相比 |
|---|---|---|---|---|---|
| ByteDance | 85.20% | 15.34% | 49.20% | 42.05% | −0.40(−1.46 至 +0.66),差異無法區分 |
| Baidu | 86.40% | 9.36% | 32.80% | 38.00% | −4.46(−5.78 至 −3.16),低於官方管道 |
| Alibaba Cloud | 87.00% | 13.29% | 53.60% | 41.75% | −0.71(−1.72 至 +0.26),差異無法區分 |
| DeepSeek 官方管道 | 86.13% | 15.06% | 53.20% | 42.45% | 基準 |
| Fireworks | 85.53% | 14.38% | 46.00% | 41.42% | −1.04(−2.14 至 +0.05),差異無法區分 |
| Pareto(本文) | 85.27% | 19.32% | 52.00% | 44.58% | +2.12(−0.02 至 +4.18),差異無法區分 |
與官方管道相比:正確率差距以百分點表示,方括號內為 95% 區間;區間跨越 0 時,記為差異無法區分。HLE 和 AA-LCR 的裁判 deepseek-flash 與受測模型同屬 DeepSeek 系列,且未經校準,因此判定結果可能偏寬鬆。
F — 功能支援:93.42
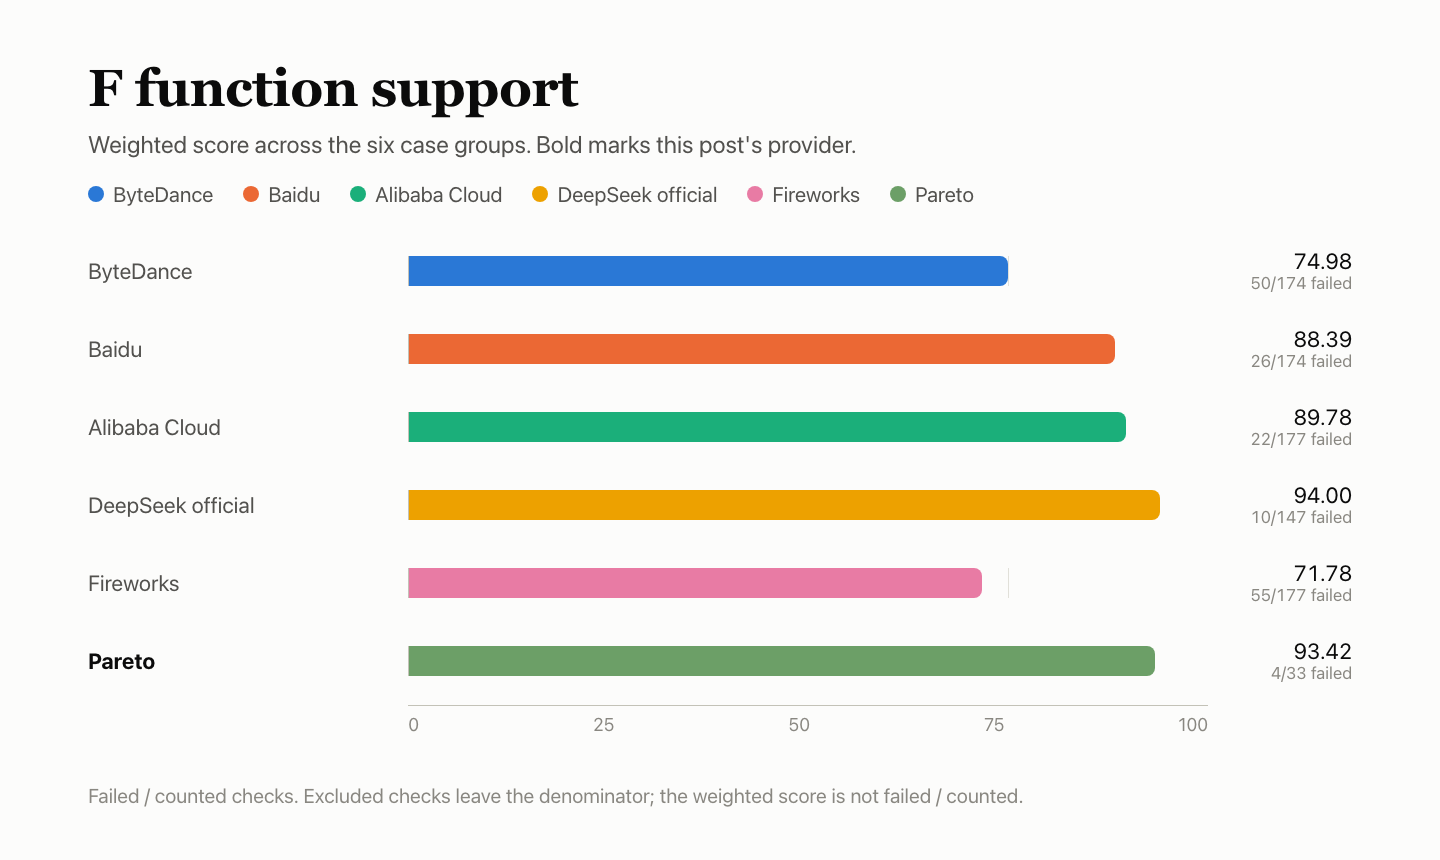
功能案例檢查介面行為是否符合通訊協定。F 93.42 是根據 33 項計分檢查(29 項通過)計算,並依觀察到的群組權重重新正規化;原始套件中其餘 147 個預定檢查項目未納入評分。
| 案例群組 | 權重 | 通過/串流觀察結果 | 排除 | 群組分數 |
|---|---|---|---|---|
| 串流與訊息通訊協定 | 20% | 23/27 | 3 | 85.19 |
| 工具介面 工具呼叫、工具結果往返、平行及具名呼叫 | 20% | 觀察到串流通過紀錄* | 30 | — |
| 輸出限制與參數 JSON 模式與停用思考模式 | 20% | 觀察到串流通過紀錄* | 30 | — |
| 上下文與狀態 對話歷史與系統指示 | 15% | 觀察到串流通過紀錄* | 30 | — |
| 錯誤與復原 | 15% | 3/3 | 27 | 100.00 |
| 用量計量與快取通訊協定 | 10% | 3/3 | 27 | 100.00 |
| 總計 · 加權分數 | 29/33 | 147 | 93.42 | |
- 列出的功能都有成功的串流紀錄;這不代表整個群組取得滿分。沒有新增任何檢查項目納入評分。F 93.42 和總分 68.72 均維持原值。
| 失敗案例 | 視窗 | 原因 |
|---|---|---|
| 串流停止序列 串流與訊息通訊協定 | 3/3 | 使用停止序列時回傳空白本文;相同輸入但不使用停止序列則正常 |
| 精確文字輸出 串流與訊息通訊協定 | 1/3 | 多出一個句點,導致精確文字比對失敗 |
「視窗」表示 3 個視窗中有幾個未通過檢查。
在幾家供應商上,格式錯誤的訊息和格式錯誤的串流選項案例都回傳 400,且回應本文為空。各供應商對推理 token 的計量方式有所不同。
與其他五家比較
| 供應商 | 通過 | 失敗 | 排除 | 加權分數 |
|---|---|---|---|---|
| ByteDance | 124 | 50 | 6 | 74.98 |
| Baidu | 148 | 26 | 6 | 88.39 |
| Alibaba Cloud | 155 | 22 | 3 | 89.78 |
| DeepSeek 官方管道 | 137 | 10 | 33 | 94.00 |
| Fireworks | 122 | 55 | 3 | 71.78 |
| Pareto(本文) | 29 | 4 | 147 | 93.42 |
P — 回應速度:57.69
每次請求約帶有 10,000 個輸入 token,並要求生成約 1,100 個本文輸出 token。在三個視窗中,每個視窗各執行 30 次單一並行請求和 30 次 10 路並行請求,總計 180 次請求。
| 項目 | 詳細資料 |
|---|---|
| 首個本文 token(TTFA) | 單一並行中位數 5.85 s(僅計有效請求為 3.08 s),10 路並行為 6.13 s(僅計有效請求為 4.92 s) |
| 生成速度(TPOT) | 單一並行為 4.42 ms/token,10 路並行為 4.63 ms/token |
| 有效吞吐量 | 10 路並行時為 519.4 token/s |
| 有效請求 | 單一並行為 53/90(視窗 1–3:15/30、18/30、20/30),10 路並行為 57/90(23/30、16/30、18/30);無效請求:70 次回傳 200,但內容為 None |
| 子分數 | TTFA 24.59、TPOT 100.00、吞吐量 72.05;TTFA 和 TPOT 採較低級距,加權占比為 35% / 35% / 30%:回應分數 65.22 |
| P 分數 | 回應分數 65.22 × 80% + 快取 K 27.58 × 20% = 57.69 |
無效請求以無限大計分,因此表格中的中位數可能高於僅計有效請求的中位數。TPOT 是根據串流區塊估算,並非在硬體上逐 token 測量。吞吐量是 10 路並行下的有效輸出 token 數除以批次實際執行時間。
與其他五家比較
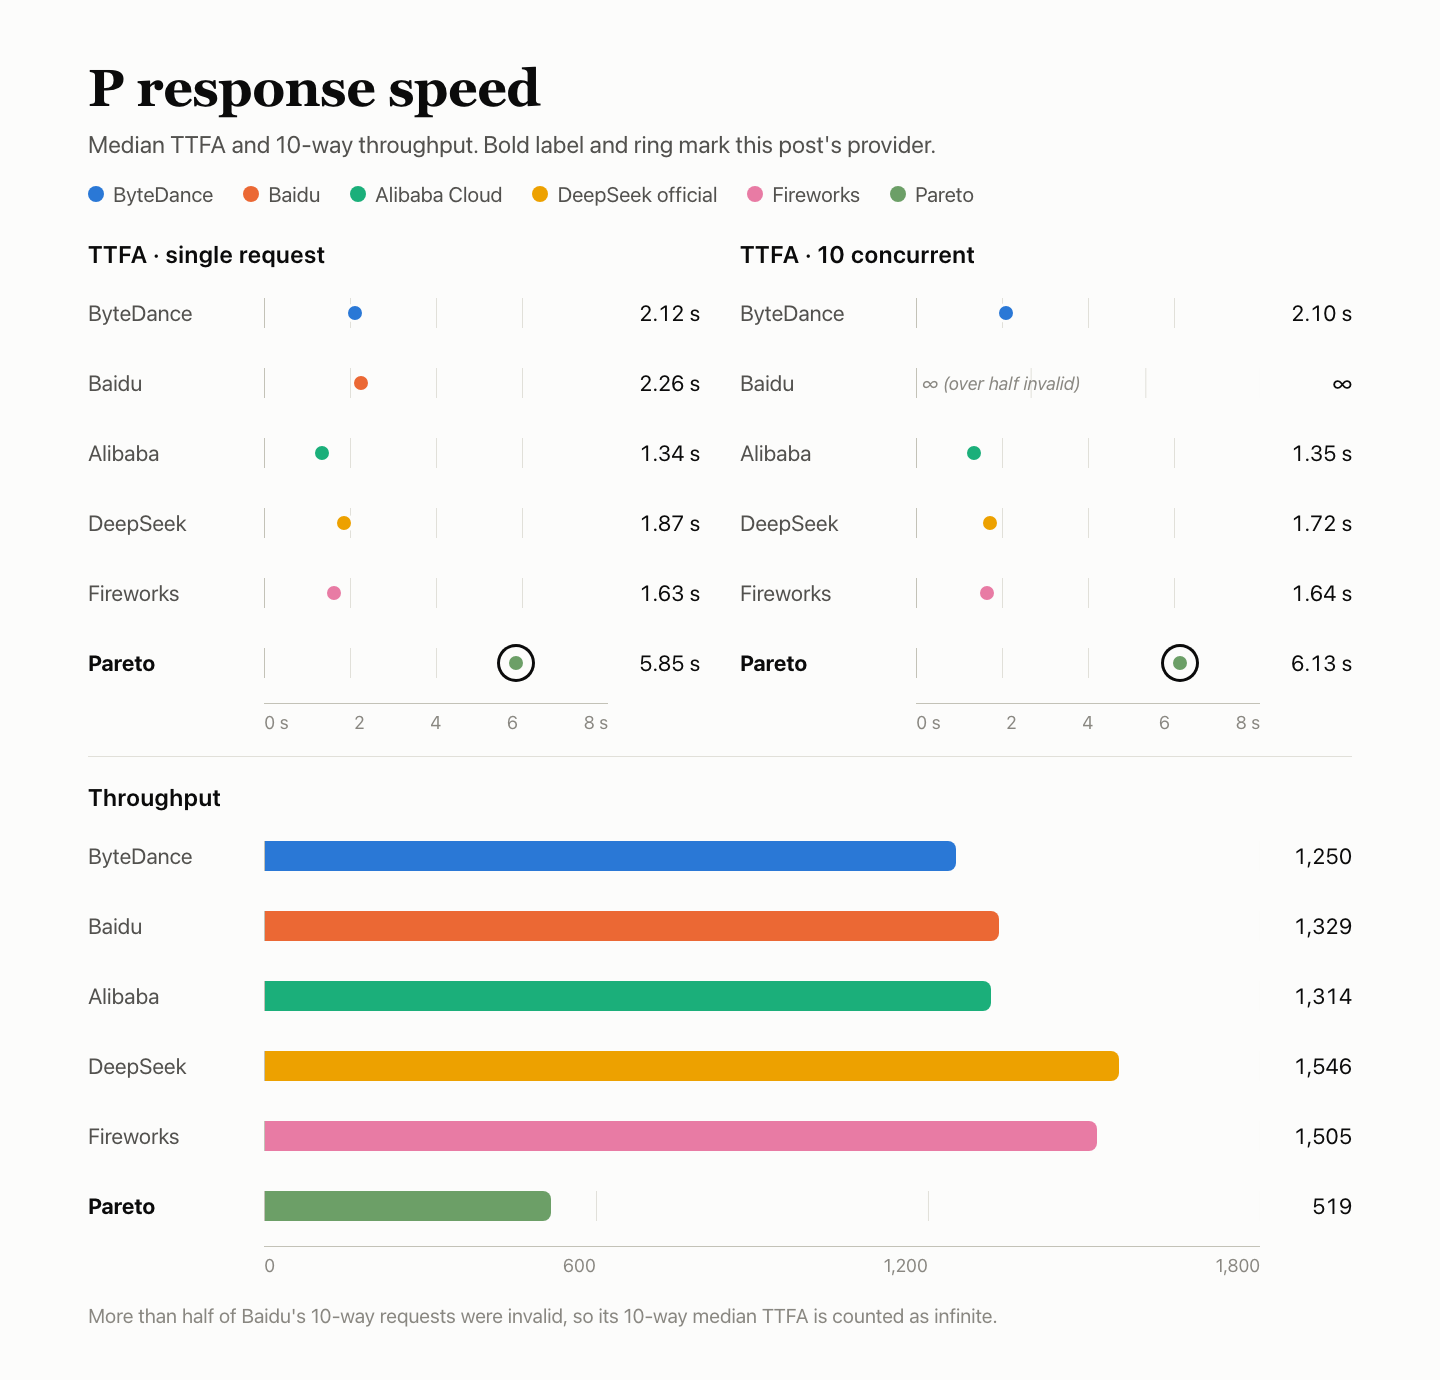
| 供應商 | 有效請求 | 單一並行 TTFA | 10 路並行 TTFA | TPOT(較慢者) | 吞吐量 token/s | 回應分數 |
|---|---|---|---|---|---|---|
| ByteDance | 180/180 | 2.12 s | 2.10 s | 3.43 毫秒 | 1,250 | 82.00 |
| Baidu | 118/180 | 2.26 s | ∞ | 50.00 毫秒 | 1,329 | 30.00 |
| Alibaba Cloud | 180/180 | 1.34 s | 1.35 s | 4.69 毫秒 | 1,314 | 85.88 |
| DeepSeek 官方管道 | 165/180 | 1.87 s | 1.72 s | 2.84 毫秒 | 1,546 | 83.08 |
| Fireworks | 179/180 | 1.63 s | 1.64 s | 3.29 毫秒 | 1,505 | 84.22 |
| Pareto(本文) | 110/180 | 5.85 s | 6.13 s | 4.63 毫秒 | 519 | 65.22 |
六家供應商共用同一台機器、網路和帳戶。三個時段依供應商分開排程,因此資料收集期間並未完全重疊;不宜過度解讀細微差異。∞ 表示超過半數請求無效,因此中位數視為無限大。
K — 快取:27.58
每組會送出五個請求。第一個請求帶有約 8k 或 32k token 的固定前綴,並建立快取。第 2–4 個請求保留前綴,只更改最後的問題,間隔分別為 5 s、30 s 和 120 s。第五個請求使用新的前綴作為冷快取對照。三個時段 × 兩種長度,共 30 個請求。K 是熱請求讀取的快取 token 數,除以依規則可重複使用的 token 數;兩種長度的權重相同;K 占 P 的 20%。
| 時段 | 1 · 建立快取 | 2 · +5 s | 3 · +30 s | 4 · +120 s | 5 · 冷快取 |
|---|---|---|---|---|---|
| 8k 前綴 · 熱請求命中 2/9 · 讀取 15,872 / 72,504 個可重複使用 token · 21.89 | — | — | — | — | — |
| 時段 1 | 0 | 0 | 7,936 | 0 | 0 |
| 時段 2 | 0 | 0 | 0 | 0 | 0 |
| 時段 3 | 0 | 0 | 7,936 | 0 | 0 |
| 32k 前綴 · 熱請求命中 3/9 · 讀取 96,000 / 288,513 個可重複使用 token · 33.27 | — | — | — | — | — |
| 時段 1 | 0 | 0 | 32,000 | 0 | 0 |
| 時段 2 | 0 | 0 | 0 | 0 | 0 |
| 時段 3 | 0 | 0 | 0 | 32,000 | 0 |
| K(8k 和 32k 權重相同) | — | — | — | — | 27.58 |
數值為伺服器回報的快取讀取 token 數;「未回傳」表示回應中沒有此欄位。
8k 熱請求中有 2/9 命中,每次命中讀取 7,936 個 token;32k 熱請求中有 3/9 命中,每次命中讀取 32,000 個 token。冷請求沒有讀取快取,因此熱、冷請求能清楚區分。
與其他五家比較
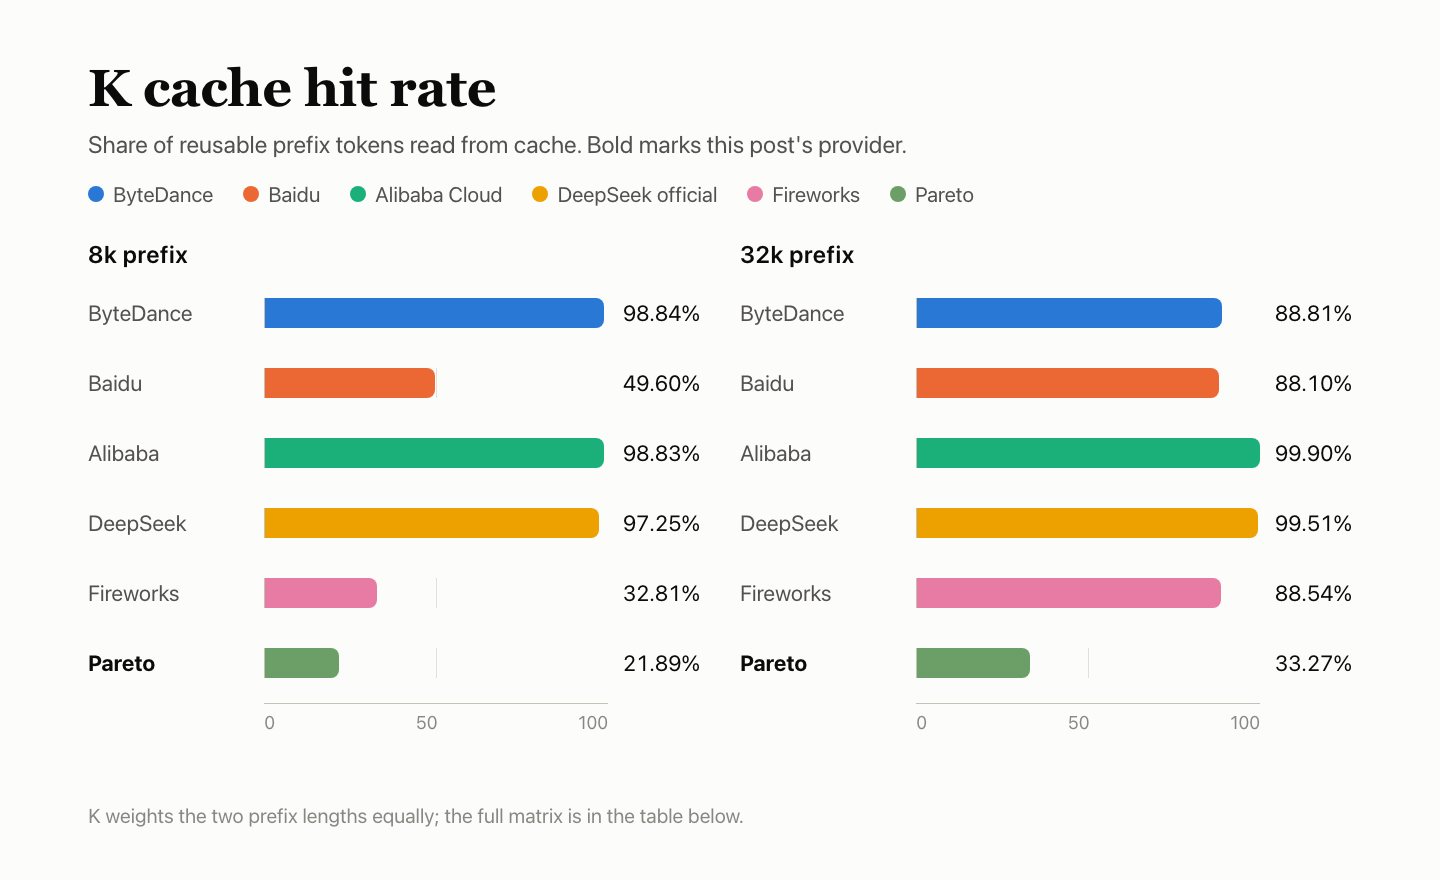
| 供應商 | 8k 命中數 | 8k | 32k 命中數 | 32k | K |
|---|---|---|---|---|---|
| ByteDance | 9/9 | 98.84 | 8/9 | 88.81 | 93.83 |
| Baidu | 5/9 | 49.60 | 8/9 | 88.10 | 68.85 |
| Alibaba Cloud | 9/9 | 98.83 | 9/9 | 99.90 | 99.37 |
| DeepSeek 官方管道 | 9/9 | 97.25 | 9/9 | 99.51 | 98.38 |
| Fireworks | 3/9 | 32.81 | 8/9 | 88.54 | 60.68 |
| Pareto(本文) | 2/9 | 21.89 | 3/9 | 33.27 | 27.58 |
R — 服務穩定性:100
300 個請求分為四種類型:短文字、長輸入、工具呼叫和多輪對話歷史。請求以單一並行度在三個時段執行。只檢查第一次嘗試是否回傳有效且完整的回應;不評分答案,也不重試。答案品質和速度章節中的失敗會計入 Q 和 P,不會再次計入 R。
| 請求類型 | 首次嘗試成功率 |
|---|---|
| 短文字 | 120/120 |
| 10k 長輸入 | 90/90 |
| 工具呼叫 | 60/60 |
| 多輪對話歷史 | 30/30 |
| 總計 · 95% 信賴區間 98.78%–100% | 300/300 |
全部 300 個請求第一次嘗試都回傳有效且完整的回應。R = 100 僅描述這 300 個專門測試的請求;不代表整條鏈路完全沒有失敗。95% 信賴區間的下限為 98.78%:300 個請求全數成功,只能表示失敗率很可能低於 1.22%。
與其他五家比較
| 供應商 | 首次嘗試成功率 | 95% 信賴區間 |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek 官方管道 | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
| Pareto(本文) | 300/300 | 98.78%–100% |
R 僅涵蓋這 300 個專門測試的請求;答案品質和速度章節中的失敗會記錄在 Q 和 P 中,不會再次計入 R。
常見問題
為什麼只計入 33 項檢查,F 卻是 93.42?
原始計分的檢查項目中,33 項有 29 項通過;將觀察到的組別權重重新正規化後,F 為 93.42。其餘 147 個預計檢查項目未納入評分。串流記錄描述了特定可正常運作的功能,並未增加計分項目。顯示的總分仍為 68.72。
為什麼 TPOT 得分是 100.00,P 卻只有 57.69?
180 個速度測試請求中,只有 110 個有效;70 個請求回傳 200 和 None。無效請求視為無限大,因此首次回應本文 token 的中位數,單一並行度為 5.85 秒,10 路並行為 6.13 秒(僅計有效請求則為 3.08 秒和 4.92 秒)。TTFA 得分為 24.59,吞吐量得分為 72.05,回應得分為 65.22;再加上占 20% 的快取 K 27.58,P 為 57.69。
為什麼 K 只有 27.58?
8k 熱請求命中 2/9(21.89),32k 熱請求命中 3/9(33.27),兩種長度的權重相同。命中時分別讀取 7,936 或 32,000 個 token,而冷快取對照請求都沒有讀取快取。
Pareto 的答案品質是否高於官方管道?
差異未達顯著。綜合準確率為 44.58%,官方管道為 42.45%,相差 +2.12 個百分點;但 95% 信賴區間介於 −0.02 至 +4.18,包含 0。HLE 和 AA-LCR 評審 deepseek-flash 未經校準,評分可能偏寬鬆。
F 有哪些案例未通過?
兩項。三個時段的串流停止序列都回傳空白本文,但相同輸入在不使用停止序列時可正常運作。精確文字輸出有一次在結尾多出一個句點,三個時段中出現一次。
繼續閱讀:DeepSeek V4.1 Flash 系列
- Pareto 的 Q 差距 +2.12 是與官方管道比較所得;基準組本身的測試結果見DeepSeek 官方管道 DeepSeek V4.1 Flash 評測:比較基準,單一並行度下有 15 個無效請求。
- Fireworks 的停止請求也回傳空白本文,且 8k 熱請求命中 3/9:Fireworks DeepSeek V4.1 Flash 評測:停止請求回傳空白本文,8k 快取熱請求命中 3/9。
- Alibaba Cloud 的熱請求命中 18/18,Pareto 則為 5/18:Alibaba Cloud DeepSeek V4.1 Flash 評測:首次回應本文 token 為 1.34 秒,18 個熱請求全數命中快取,答案與官方無法區分。
- ByteDance 的速度測試請求全數有效,首次回應本文 token 為 2.12 秒:ByteDance DeepSeek V4.1 Flash 評測:答案與官方無法區分,但輸入計數不一致。
- Baidu 也有許多速度測試請求因 no_available_channel 而失敗:Baidu DeepSeek V4.1 Flash 評測:工具呼叫表現與官方相當,頻繁的 no-available-channel 錯誤拖累答案品質和速度。
資料來源
- DeepSeek V4.1 Flash 1017 模型頁面(AIHubMix)
- AIHubMix Provider Benchmark Standard v2.0(AIHubMix 文件)
- 快速入門(AIHubMix 文件)
- 模型(AIHubMix)
- DeepSeek API 文件(DeepSeek)


