Gemini 4 Carbon并不是一个新的模型系列,而是Gemini 4 Argon的思考量更大的版本,token 单价相同:在 2026 年 11 月 30 日之前,入门价格为每百万输入 token $2、每百万输出 token $10;从 12 月 1 日起则为 $4 和 $20。问题不在于哪个模型的 token 单价更低,两者完全相同。问题在于,每个任务增加的思考能否带来足够的收益,值得为此接受更慢的首次响应。
Artificial Analysis 的实时数据对一种工作给出了明确答案,也对另一种工作发出了明确警告。在 AA Intelligence Index 上,Carbon High 以 60.03 排名 104 个模型中的第 #4,Argon High 则为 50.41。Carbon 每项任务的成本为 $7.76,低于 Argon 的 $9.95;完成时间为 25.6 分钟,也快于 Argon 的 29.0 分钟。但 Carbon 首次生成回答 token 需要 67.1 秒,而 Argon 只需 40.1 秒。Carbon 更适合处理任务队列,Argon 更适合对话。
这就是本文的核心。下文将介绍有哪些变化、测量数据说明了什么、Google 的模型卡补充了哪些信息、价格将在 12 月 1 日如何变化,以及哪些工作负载应该继续使用 Argon。
Argon 有哪些变化
Google 的模型卡明确说明了两者的关系:“Gemini 4 Carbon 基于 Gemini 4 Argon。”模型 ID 为gemini-4-carbon,在 AIHubMix 上也相同。Google 记载的上下文窗口为 1,048,576 个 token。思考强度分为低、中、高,默认值为中。标准输出上限为 65,536 个 token;Google 原生的长解码路径最高可达到 1,048,576 个 token 减去输入 token 数,文档中列出的示例值为 131,072 和 262,144。AIHubMix 目前只记录了 Chat Completions,因此在有更大输出路径的文档说明之前,请将网关请求控制在 65,536 个 token 以内。知识截止时间为 2026 年 3 月。Google 不向免费额度用户提供该模型。
在Google 的 AI Studio 说明中,模型变化被描述为:“Carbon 每轮会花费更多思考 token,以进行充分探索并核验结果,因此,与 Argon 相比,每轮 token 用量和延迟都会增加。”这句话几乎解释了本文后续提到的所有差异。更多思考可以提高处理困难任务的上限,也会增加每轮费用,并延长首个 token 到达前的等待时间。
迁移过程刻意保持简单。“从 Argon 升级无需更改请求架构。”在 API 层面,只需更换模型字符串。Google 给出的运维建议是:“除非工作负载需要高强度,否则请将 thinking_level 保持为中(默认值),并确保 max_output_tokens 和 HTTP 超时时间能够容纳更长的推理过程。”
实测权衡:思考更多,每项任务花费更少
下列数据来自Artificial Analysis 的实时测量,访问时间为 2026-11-11T05:23Z(06:01Z 重新检查模型页面,数据未变),采用标准价格:每百万输入 token $4、每百万输出 token $20。
值得关注的比较是质量与任务完成成本之间的关系:Carbon 能否以更低的费用提升指数得分?图中将四种模型配置分别列出。
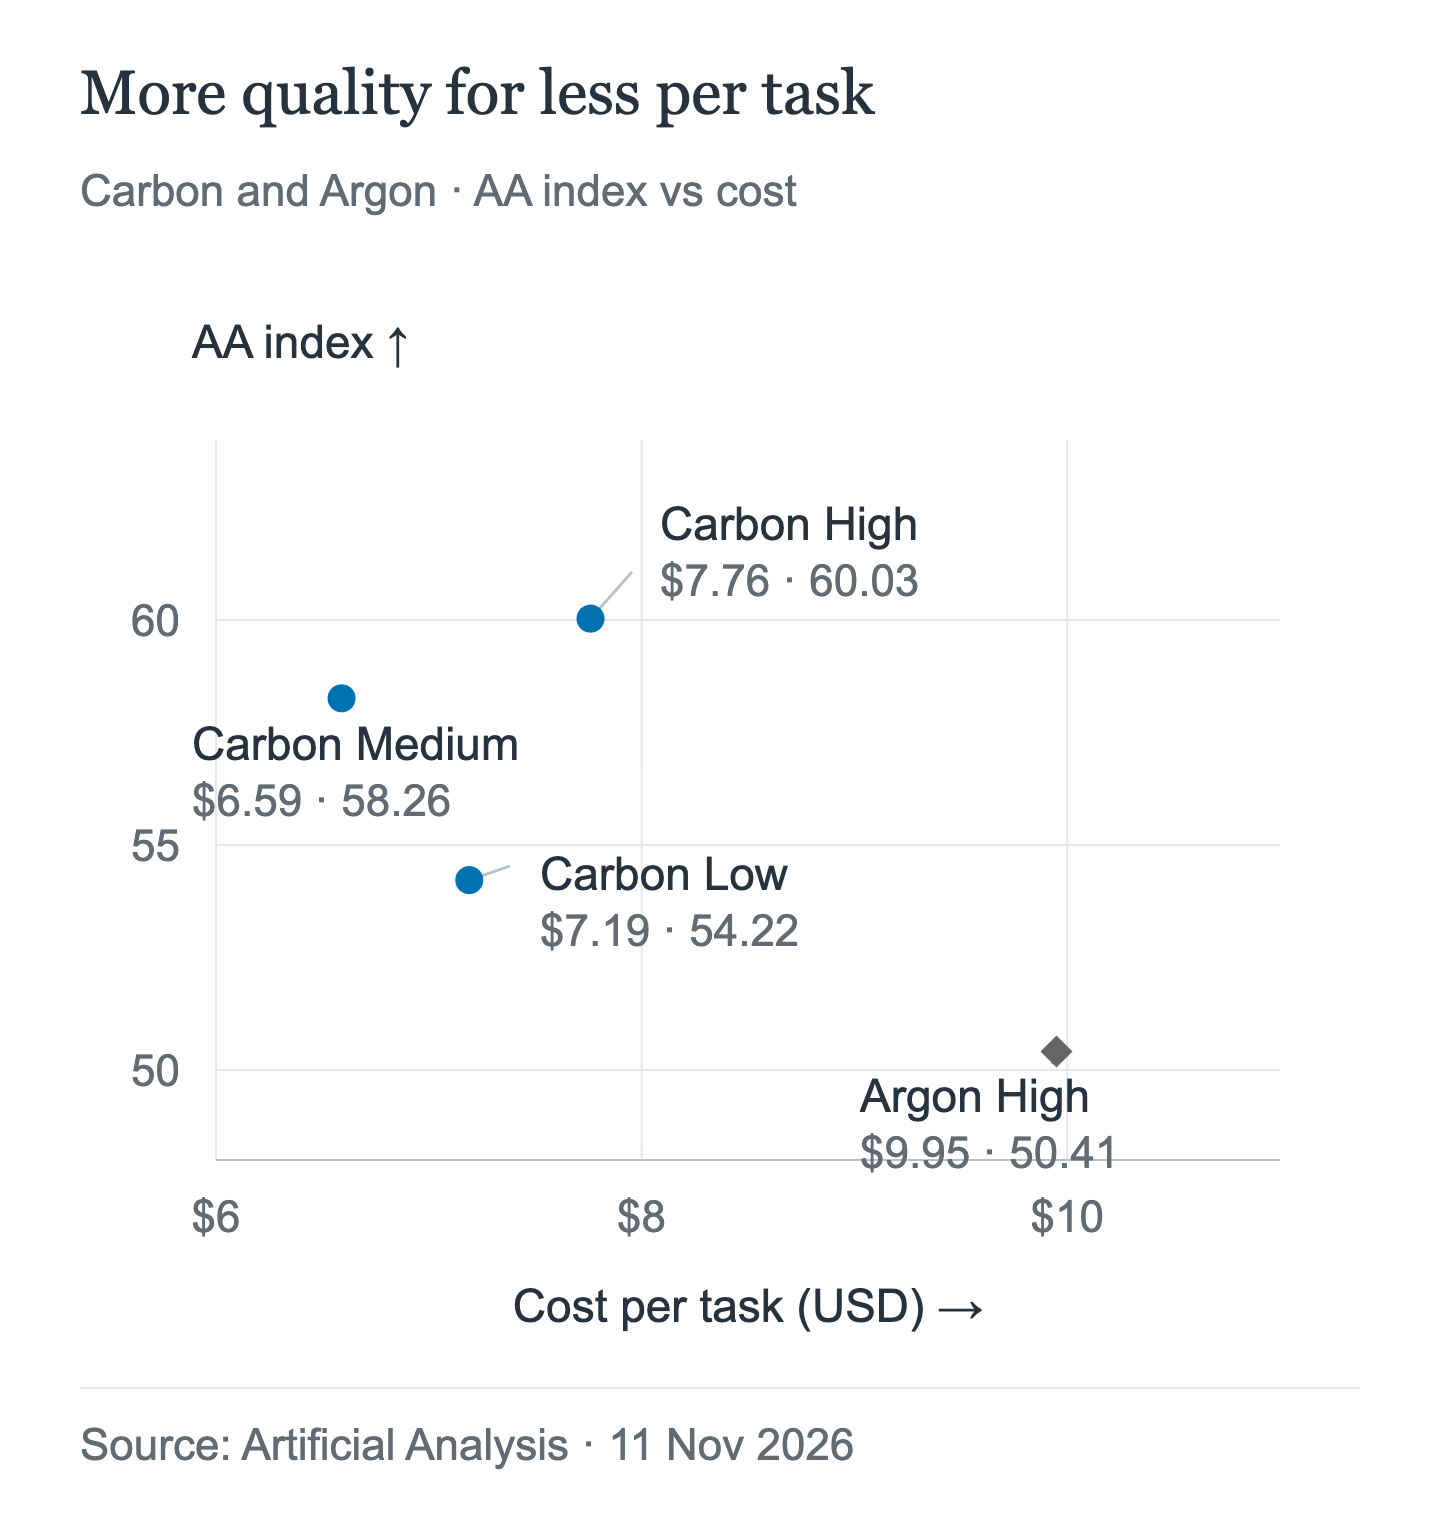
Carbon High 位于 Argon High 的左上方。此次测试中,Carbon Medium 是成本最低的 Carbon 配置;Low 是为降低延迟而选的配置,并非成本最低的配置。这些是 AA 按标准价格计算的任务成本,不是 AIHubMix 的请求费用。
| 模型 | AA 指数 | 美元/任务 | 分钟/任务 | 首个 token | 输出 token/秒 |
|---|---|---|---|---|---|
| Carbon High | 60.03 | 7.76 | 25.6 | 67.1 s | 80.1 |
| Carbon Medium | 58.26 | 6.59 | 23.3 | 23.2 s | 73.7 |
| Carbon Low | 54.22 | 7.19 | 22.6 | 12.9 s | 63.5 |
| Argon High | 50.41 | 9.95 | 29.0 | 40.1 s | 66.8 |
Carbon High、Medium 和 Low 分别位列 104 个模型中的第 #4、#6 和 #14;Argon High 排在它们之后。Carbon High 之前的三个配置全都是 Claude Fable 5.2。“首个 token”指生成第一个回答 token 所需的时间。与 Argon High 相比,Carbon High 的指数得分高出 9.62 分,每项任务成本低 22.0%,耗时为 25.6 分钟而非 29.0 分钟,但首个回答 token 的等待时间为 67.1 秒而非 40.1 秒。
指数差距足以改变排行榜名次,延迟差距也足以影响用户是否需要等待。这两点来自同一行数据。
Artificial Analysis 称 Carbon“每项任务的速度明显较慢,且输出非常冗长”,并报告称,运行该指数时 Carbon 生成了 205 million 个 token,Argon 为 113 million,而参与测量的模型中位数为 72.8 million。在这次 AA 测试中,Carbon 的输出量大幅增加,但每项任务成本反而更低:标价相同,token 多得多,整体任务成本却更低。
有一个异常值得单独说明。Carbon Low 每项任务成本为 $7.19,高于 Medium 的 $6.59,尽管它的思考量更少。无论原因是什么,Low 的表现更像是降低延迟的配置,而非省钱的配置,因此在将大量请求路由到它之前,请先测量每项任务的成本。
从编程智能体的角度看
Intelligence Index 汇总了许多任务的表现。Coding Agent Index v2则更贴近 API 客户的实际使用场景:它在同一测试框架中端到端测量配备工具的编程智能体。Carbon High 排名第 #4,Argon High 排名第 #11。
| 排名 | 智能体 + 模型 | 指数 | 美元/任务 | 分钟/任务 | 缓存命中 |
|---|---|---|---|---|---|
| 4 | Antigravity CLI + Carbon High | 59.4 | 7.74 | 29.8 | 0.95 |
| 11 | Antigravity CLI + Argon High | 53.2 | 11.73 | 34.7 | 0.87 |
使用相同的智能体和测试框架,只更换模型,因此这项比较测出的是模型本身的差异,而非外围配置的差异。Carbon 每项任务成本低 34.0%,指数得分高 6.2 分,快 4.9 分钟,且每项任务的输出量几乎相同:109,031 个 token,而 Argon 为 109,236 个。Carbon 的缓存命中率更高,为 0.95,而 Argon 为 0.87;输入用量也更低,为 12.44 million 个 token,而 Argon 为 13.76 million。
需要注意两点。Carbon 在该指数中排名第 #4:Claude Code 搭配 Opus 5.5 Max 以 61.7 领跑,其后是 Devin Fusion CLI 和 GitHub Copilot Fusion。此外,Fable 5.2 并未列入该指数,因此这张表无法定论 Carbon 与 Fable 谁更好。
Google 的模型卡补充了什么,又没有说明什么
Google 的模型卡是供应商提供的文档:数据截至 2026 年 10 月,由 Google 自行报告,与上文的实时数据来自不同时间点。下表中的每一项,Google 给出的 Carbon 数值都更高。
| 基准测试 | Carbon | Argon |
|---|---|---|
| AA Index v5.0(供应商数据) | 59 | 50 |
| Terminal-Bench 4.0 | 65.2 | 57.1 |
| FrontierSWE 2 | 61.2 | 55.0 |
| OSWorld-2.1 | 81.5 | 74.7 |
| Agents' Last Exam | 77.4 | 69.0 |
AA 这一行是 Google 四舍五入后的 59,并非前表实时数据中的 60.03;两者来自不同时间点,不应混为一谈。模型卡中的外部对比对象是 Fable 5.1,而不是 Fable 5.2。
值得关注的是各项结果都保持一致:优势并非只体现在某一个基准测试上。局限也很明显。供应商模型卡不会计算每项任务的价格,也不会测量首个 token 的延迟,更无法告诉你智能体需要执行多少轮。它能支持“Carbon 的平均表现更强”这一说法,却不能支持“Carbon 更适合你的工作流”这一结论。
价格:相同价目表,12 月 1 日同样调价
Carbon 和 Argon 的价格逐项相同。两者都在 2026 年 11 月 30 日之前采用入门价格,并于 12 月 1 日起涨至原来的两倍。
| 模型 | 输入 | 输出 | 缓存读取 |
|---|---|---|---|
| Carbon,入门价(截至 11 月 30 日) | $2.00 | $10.00 | $0.10 |
| Carbon,12 月 1 日起 | $4.00 | $20.00 | $0.20 |
| Argon,入门价(截至 11 月 30 日) | $2.00 | $10.00 | $0.10 |
| Argon,12 月 1 日起 | $4.00 | $20.00 | $0.20 |
| Gemini 3.1 Pro Preview(≤200k) | $2.00 | $12.00 | $0.20 |
| Fable 5.2 | $8.00 | $40.00 | $0.20 |
官方价格,单位为每百万 token 的美元,数据日期为 2026 年 11 月 11 日。Gemini 3.1 Pro Preview 在提示词 token 数超过 200k 时的价格为 $4/$18/$0.40,另加每百万 token 每小时 $4.50 的存储费。Fable 5.2 的缓存写入费用为 5 分钟 $10、1 小时 $16;批量处理可享受 50% 的折扣。Carbon 和 Argon 的入门价格于 11 月 30 日结束;两者的所有价格都将在 12 月 1 日翻倍。
AIHubMix 为 Carbon 标出的价格为 $2/$10/$0.10,与 Google 的入门价格一致。本文不预设网关在 11 月 30 日之后的收费标准;请查看模型页面获取当前价格。
按照入门价格,重新计算 Artificial Analysis 测得的 token 数量,可得每项任务的大致费用:Carbon High 为 $3.88,Medium 为 $3.30,Low 为 $3.60,Argon High 为 $4.98。这些是计算得出的估算值,并非 AA 的测量结果:计算假定每项任务的 token 构成保持不变,而你的提示词和缓存命中率都会影响最终结果。
按 token 计价,在标准价格下,Fable 5.2 的成本是 Carbon 的两倍;在入门价格下则是四倍。这只是价格差异,并不代表质量高低;本系列的第三篇文章将对此进行比较。
Carbon 并非更好的选择的情况
不选 Carbon,并不是因为它表现更差,而是因为它带来的优势——每轮更多的思考——恰恰是交互式产品无法等待的东西。
首个 token 来得太晚。Carbon High 要等 67.1 秒才能生成第一个回答 token,Argon High 则需要 40.1 秒。Medium 将等待时间缩短至 23.2 秒,Low 则缩短至 12.9 秒,但两者的指数得分也随之降低。聊天界面暂停一分钟,就已经错过了这轮对话,不管最终答案有多好。
Google 建议速度优先时继续使用 Argon。Argon 面向“交互式编程、日常功能开发和快速生产迭代”等场景,可提供“更快的响应和更低的每轮 token 消耗”。迁移说明中的建议直截了当:“速度很重要时,请继续使用 Argon。”Google 的公告文章也再次强调:“对于大多数软件工程和知识工作,Argon 仍然是理想选择。”
即使每项任务成本更低,每轮开销仍然更高。两者的 token 单价相同,但 Carbon 每轮会使用更多思考 token。对于关注每轮 token 用量或需要控制 token 配额的团队来说,Carbon 用起来会更贵。指数测试中 Carbon 使用了 205-million 个 token,而 Argon 使用 113 million,这正是这种影响最明显的例子。
Low 并不是省钱的选项。Carbon Low 每项任务成本为 $7.19,高于 Medium 的 $6.59。如果路由规则是降低每项已完成任务的成本,Low 就不符合要求。
基准测试的胜利无法追回等待时间。在 Google 的表格中,Carbon 在 OSWorld-2.1 和 FrontierSWE 2 上都表现更好,但这些数据由供应商报告,而且都不会缩短首个 token 的等待时间。基准测试衡量最终结果,用户感受到的却是开场等待。
哪些人应该立即切换,哪些人应该继续使用 Argon
如果你运行供应商原生的批处理或后台智能体任务(AIHubMix 尚未记录 Carbon 对这些路径的支持),如果质量问题造成的损失超过耗时,如果请求能够容忍更长的超时和更大的输出预算,或者你已经在为 Carbon 可能避免的重试付费,现在就切换到 Carbon。
如果你在开发聊天、自动补全,或任何有人等待结果的循环;如果预算或配额按轮次计算;或者产品要求延迟控制在约 30 秒以内,就继续使用 Argon。
如果情况介于两者之间,先进行测试。将相同的 20 到 50 个真实请求分别发送给两个模型,记录首 token 耗时和每个已完成任务的成本,然后根据这些数据进行路由,而不是依据排行榜。AIHubMix 对比页面将两个模型页面并排展示。
如何通过 AIHubMix 调用
Carbon 在 AIHubMix 上使用相同的模型 ID 格式,并采用文档中说明的聊天补全端点。
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-carbon",
    messages=[{"role": "user", "content": "Summarise this incident report and list the follow-ups."}],
    max_tokens=16384,
)

print(response.choices[0].message.content)
端点为 POST /v1/chat/completions;这是 AIHubMix 为该模型记录的唯一调用路径。文档列出的输入模态为文本。AIHubMix 尚未记录 Carbon 对图像和 PDF 输入、Responses API、Anthropic Messages 以及 Gemini 原生端点的支持,因此应将这些功能视为未经确认。reasoning_effort映射也同样如此:不要假设网关会传递思考级别参数。请将max_tokens控制在 65,536 的标准输出限制内;更高的限制需要使用 Google 的后台模式,目前尚未确认 AIHubMix 是否支持。本文未进行实时测试,因此示例展示的是请求格式,而非经过验证的响应。
常见问题
Carbon 和 Argon 的价格相同吗?
是的。Google 官方定价完全相同:截至 2026 年 11 月 30 日,每百万输入 token 收费 $2,每百万输出 token 收费 $10,此后分别为 $4 和 $20。缓存读取费用分别为 $0.10 和 $0.20。
Carbon 比 Argon 更好吗?
在质量和每个已完成任务的成本方面,根据 Artificial Analysis 的测量结果,是的:Intelligence Index 得分为 60.03,对比 50.41;每个任务的成本为 $7.76,对比 $9.95。在响应速度方面则不是:Carbon 首个回答 token 耗时 67.1 秒,而 Argon 为 40.1 秒。
为什么 Carbon 完成任务更快,响应却更慢?
它会等待更久才开始回答,但随后更快完成整个任务:耗时 25.6 分钟,而 Argon 为 29.0 分钟。等待首个 token 的时间与任务总耗时是不同的指标,且呈现出相反的趋势。
请求需要修改吗?
不需要。Google 表示,从 Argon 升级无需更改 schema;只需将模型字符串改为 gemini-4-carbon。请提高输出限制和 HTTP 超时时间,以适应更长的思考过程。
为什么 Carbon Low 的单任务成本比 Medium 更高?
Artificial Analysis 测得 Low 的成本为 $7.19,Medium 为 $6.59。应将 Low 视为延迟设置,而非折扣设置;在通过它处理大量请求之前,先测量每个任务的成本。
Carbon 在 Artificial Analysis 上排名如何?
它在 Intelligence Index 上排名第 #4,排在三种 Claude Fable 5.2 配置之后。Google 的模型卡显示该指数的四舍五入分数为 59;实时分数为 60.03,不应混为一谈。
Carbon 提供免费额度吗?
不提供。Google 不在免费额度中提供 Gemini 4 Carbon,因此只能通过付费 API 定价或 AIHubMix 这类网关访问。
继续阅读:Gemini 4 Carbon 系列
- 如果这篇文章让你决定尝试 Carbon,但首次请求失败,迁移指南介绍了在更长的思考过程中可能出现的 400 错误、超时设置和输出限制变化:Gemini 4 Carbon API 迁移:400 错误、超时和输出限制。
- 如果你仍在考虑 Carbon 是否足以胜任智能体编程,或者 Fable 5.2 的溢价是否物有所值,第三篇文章会将相同的实测数据与 Fable 5.2 并列比较:Gemini 4 Carbon 与 Fable 5.2:智能体编程该选哪个?。
来源
- Google AI Studio,Gemini 4 Carbon:新增内容
- Google DeepMind,Gemini 4 Carbon 模型卡
- Google AI Studio,Gemini API 定价
- Artificial Analysis,Gemini 4 Carbon
- AIHubMix,Gemini 4 Carbon