

在 2026-11-03/04 的 APB Full 测试中,Pareto 的四项得分为 Q 44.58、F 93.42、P 57.69 和 R 100,总分为 68.72。8k 热请求命中 2/9,32k 热请求命中 3/9。
在 2026-11-03/04,我们通过 AIHubMix 使用 APB Full 套件测试了六家供应商提供的 DeepSeek V4.1 Flash 1017,对每家都使用相同的问题、参数和请求脚本。本篇 APB Profile 仅介绍 Pareto:各部分测试了什么,以及测试结果如何。
以下数字是得分,不是排名,也不是对供应商的推荐。首先列出 Q、F、P 和 R 四项得分;总分是汇总指数,不是认证结果,也没有置信区间。评分规则详见 AIHubMix Provider Benchmark Standard v2.0。
六家供应商得分
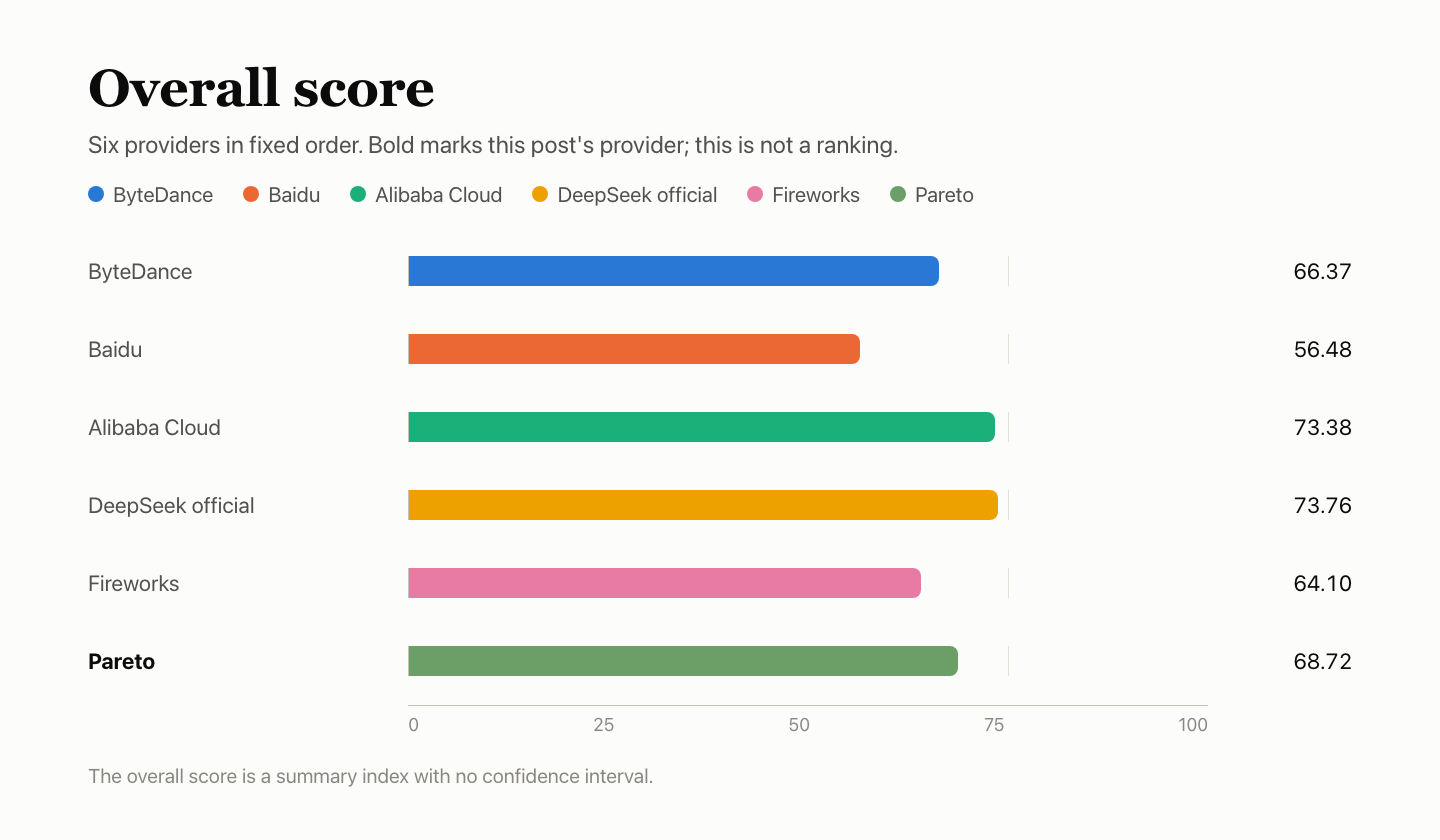
| 供应商 | Q 质量 | F 功能 | P 速度 | K 缓存 | R 稳定性 | 总分 |
|---|---|---|---|---|---|---|
| ByteDance | 42.05 | 74.98 | 84.37 | 93.83 | 100 | 66.37 |
| Baidu | 38.00 | 88.39 | 37.77 | 68.85 | 100 | 56.48 |
| Alibaba Cloud | 41.75 | 89.78 | 88.58 | 99.37 | 100 | 73.38 |
| DeepSeek 官方渠道 | 42.45 | 94.00 | 86.14 | 98.38 | 100 | 73.76 |
| Fireworks | 41.42 | 71.78 | 79.51 | 60.68 | 100 | 64.10 |
| Pareto(本文) | 44.58 | 93.42 | 57.69 | 27.58 | 100 | 68.72 |
供应商按固定顺序列出,并非排名。K 是 P 的子分数,占 P 的 20%,单独列出仅供参考。总分按照 AIHubMix Provider Benchmark Standard 的构成规则计算,其中也考虑了与官方渠道的对比和证据完整度;它并非对表中四项得分直接加权。总分是没有置信区间的汇总指数。DeepSeek 官方渠道和 Alibaba Cloud 的总分仅相差 0.37,这一差异无法区分。
一览
- 答案质量:Q 44.58,其中 BFCL 为 85.27%、HLE 为 19.32%、AA-LCR 为 52.00%。与官方渠道的差距为 +2.12 个百分点,95% 区间为 −0.02 至 +4.18,差异无法区分。
- 功能支持:F 93.42,原始计分检查项中 29/33 通过。工具调用及工具结果往返、并行和命名调用、JSON 模式与对话历史另有成功的流式输出记录;得分保留原值。
- 响应速度:P 57.69。单并发下首个正文 token 的中位数为 5.85 s,10 路并发下为 6.13 s;TPOT 为 4.63 ms;180 个速度请求中有 110 个有效。
- 缓存:K 27.58。8k 热请求命中 2/9,32k 热请求命中 3/9;冷请求对照组均未读取缓存。
- 服务稳定性:R 100。专门测试的 300 个请求首次尝试均成功。
测试设置
| 项目 | 详情 |
|---|---|
| 模型 | DeepSeek V4.1 Flash 1017 |
| 请求的模型 ID | deepseek/deepseek-v4.1-flash |
| 返回的模型名称 | deepseek/deepseek-v4.1-flash |
| 访问路由 | 通过 AIHubMix,使用供应商专属模型 ID;并非直接连接到供应商账户 |
| 参数 | 固定的 APB v2 请求配置,temperature 1.0,max_tokens 16,384,超时 300 s,不自动重试 |
| 时间 | 2026-11-03 18:07 – 11-04 16:33;缓存请求为 11-05 19:31 – 11-06 10:35;均为 UTC+8。六家供应商共用一台 Mac mini、一个网络和一个账户。 |
| 样本 | Q 4,250 个问题实例;F 180 项检查;P 180 个请求;R 300 个请求;K 30 个请求 |
请求使用 AIHubMix 的 快速入门路由和供应商专属模型 ID;其他供应商的 ID 列于模型页面。模型自身的参数说明见 DeepSeek 的 API 文档。
Q — 答案质量:44.58
答案质量基于三个测试套件:500 道 BFCL 题目,每题回答 3 次;250 道 HLE 题目,每题回答 10 次;以及 25 道 AA-LCR 题目,每题回答 10 次。BFCL 按自动规则评分;HLE 和 AA-LCR 则由评审模型 deepseek-flash 判断对错。六家供应商收到的问题完全相同,三个套件的结果合并计算准确率。由于问题无法评分,10 个答案被移除;最终留下 4,240 个可评分的问题实例。
| 测试套件 | 问题数 × 轮数 | 正确数 | 准确率 | 服务故障 |
|---|---|---|---|---|
| BFCL 工具调用,自动评分 | 500 × 3 | 1,279/1,500 | 85.27% | 0 |
| HLE 高难度问答,由评审模型评分 | 250 × 10 | 481/2,490 | 19.32% | 0 |
| AA-LCR 长文档推理,由评审模型评分 | 25 × 10 | 130/250 | 52.00% | 0 |
| 总计 · 95% 区间 41.57%–47.49% | — | 1,890/4,240 | 44.58% | 0 |
每个问题实例都收到了完整答案;没有服务故障。
| BFCL 类别 | 通过数 | 通过率 |
|---|---|---|
| simple_python:调用一个函数,函数和参数均正确 | 333/360 | 92.50% |
| multiple:从多个函数中选出正确的一个 | 269/300 | 89.67% |
| parallel:同时多次调用一个函数 | 265/300 | 88.33% |
| parallel_multiple:同时调用多个函数 | 203/240 | 84.58% |
| irrelevance:没有相关函数,因此不调用 | 109/150 | 72.67% |
| ahm_multi_turn:三阶段工具链 | 100/150 | 66.67% |
每道 BFCL 题目回答 3 次;表中汇总了 3 轮结果。
与其他五家对比
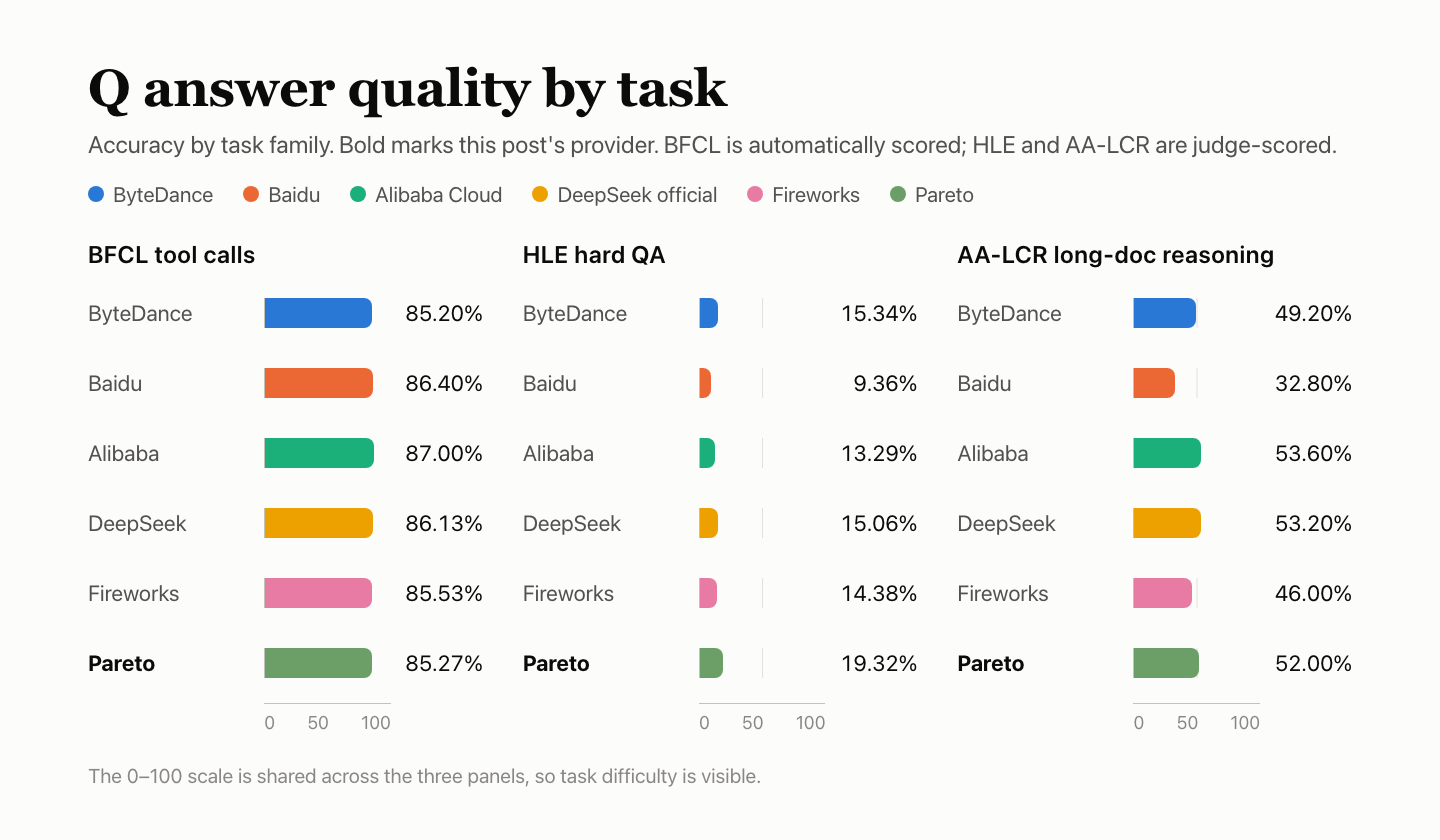
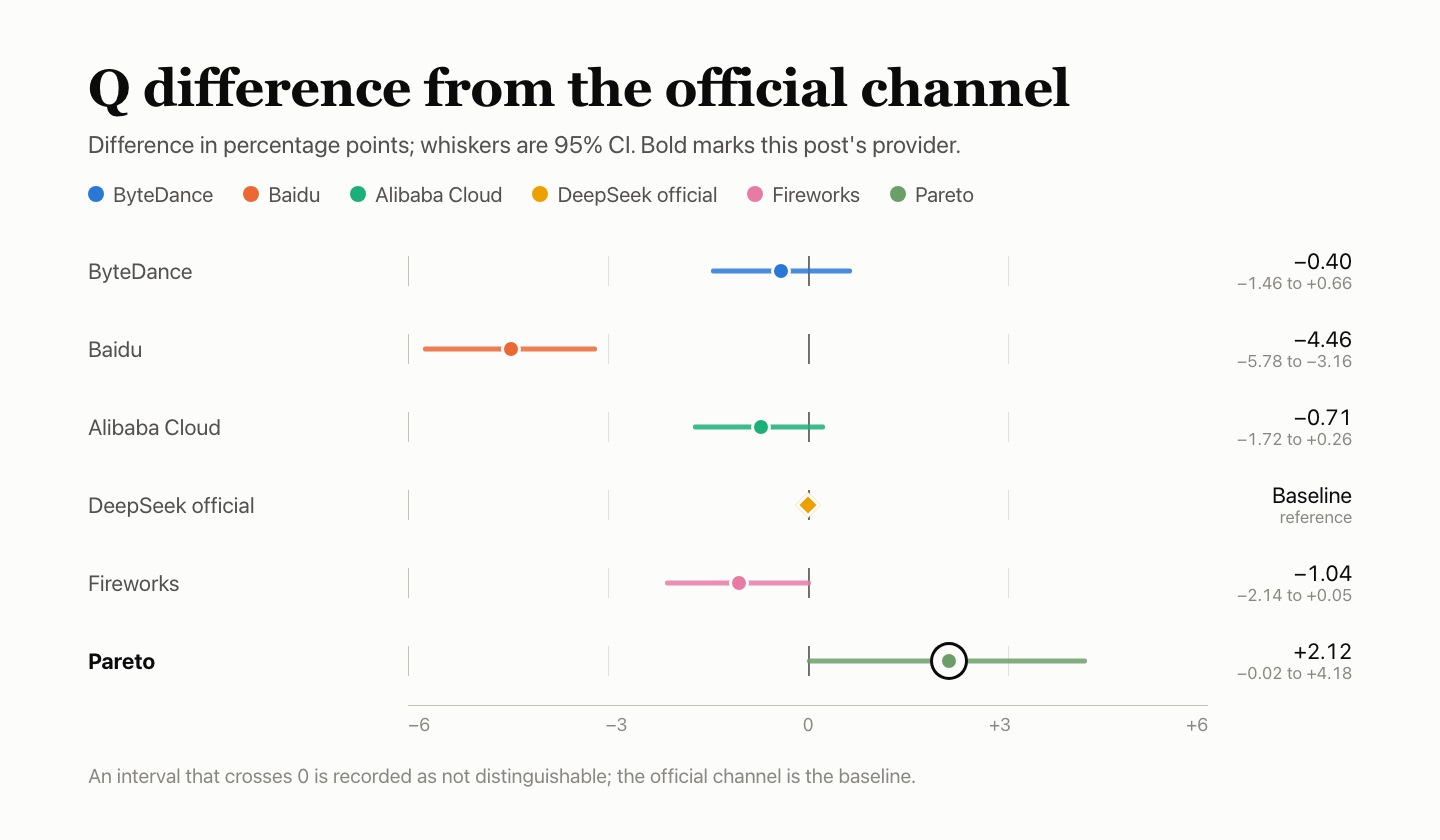
| 供应商 | BFCL | HLE | AA-LCR | 综合 | 相较官方渠道 |
|---|---|---|---|---|---|
| ByteDance | 85.20% | 15.34% | 49.20% | 42.05% | −0.40(−1.46 至 +0.66),差异无法区分 |
| Baidu | 86.40% | 9.36% | 32.80% | 38.00% | −4.46(−5.78 至 −3.16),低于官方渠道 |
| Alibaba Cloud | 87.00% | 13.29% | 53.60% | 41.75% | −0.71(−1.72 至 +0.26),差异无法区分 |
| DeepSeek 官方渠道 | 86.13% | 15.06% | 53.20% | 42.45% | 基线 |
| Fireworks | 85.53% | 14.38% | 46.00% | 41.42% | −1.04(−2.14 至 +0.05),差异无法区分 |
| Pareto(本文) | 85.27% | 19.32% | 52.00% | 44.58% | +2.12(−0.02 至 +4.18),差异无法区分 |
相较官方渠道:准确率差距,以百分点表示,方括号内为 95% 区间;区间跨过 0 时,记为差异无法区分。HLE 和 AA-LCR 的评审模型 deepseek-flash 与受测模型同属 DeepSeek 系列,且未经校准,因此评审结果可能偏宽松。
F — 功能支持:93.42
功能测试检查接口行为是否符合协议。F 93.42 根据 33 项计分检查(29 项通过)计算,并按实际观察到的组别权重重新归一化;原始套件中其余 147 个计划检查名额未纳入评分。
| 用例组 | 权重 | 通过项 / 流式输出观察记录 | 排除项 | 组得分 |
|---|---|---|---|---|
| 流式输出和消息协议 | 20% | 23/27 | 3 | 85.19 |
| 工具接口 工具调用、工具结果往返、并行和命名调用 | 20% | 观察到流式输出通过* | 30 | — |
| 输出约束和参数 JSON 模式和关闭思考模式 | 20% | 观察到流式输出通过* | 30 | — |
| 上下文和状态 对话历史和系统指令 | 15% | 观察到流式输出通过* | 30 | — |
| 错误和恢复 | 15% | 3/3 | 27 | 100.00 |
| 计量和缓存协议 | 10% | 3/3 | 27 | 100.00 |
| 总计 · 加权得分 | 29/33 | 147 | 93.42 | |
- 所列功能均有成功的流式输出记录;这并不意味着整个组都获得满分。评分时未新增检查项。F 93.42 和总分 68.72 均保留原值。
| 失败用例 | 失败窗口数 | 原因 |
|---|---|---|
| 流式输出停止序列 流式输出和消息协议 | 3/3 | 使用停止序列时正文为空;不使用停止序列的相同输入正常工作 |
| 精确文本输出 流式输出和消息协议 | 1/3 | 末尾多了一个句点,导致精确文本匹配失败 |
“失败窗口数”表示 3 个测试窗口中有多少个未通过检查。
格式错误的消息和格式错误的流式输出选项用例,在多个供应商处返回了状态码 400,且响应正文为空。各供应商对推理 token 的计量方式也不一致。
与其他五家对比
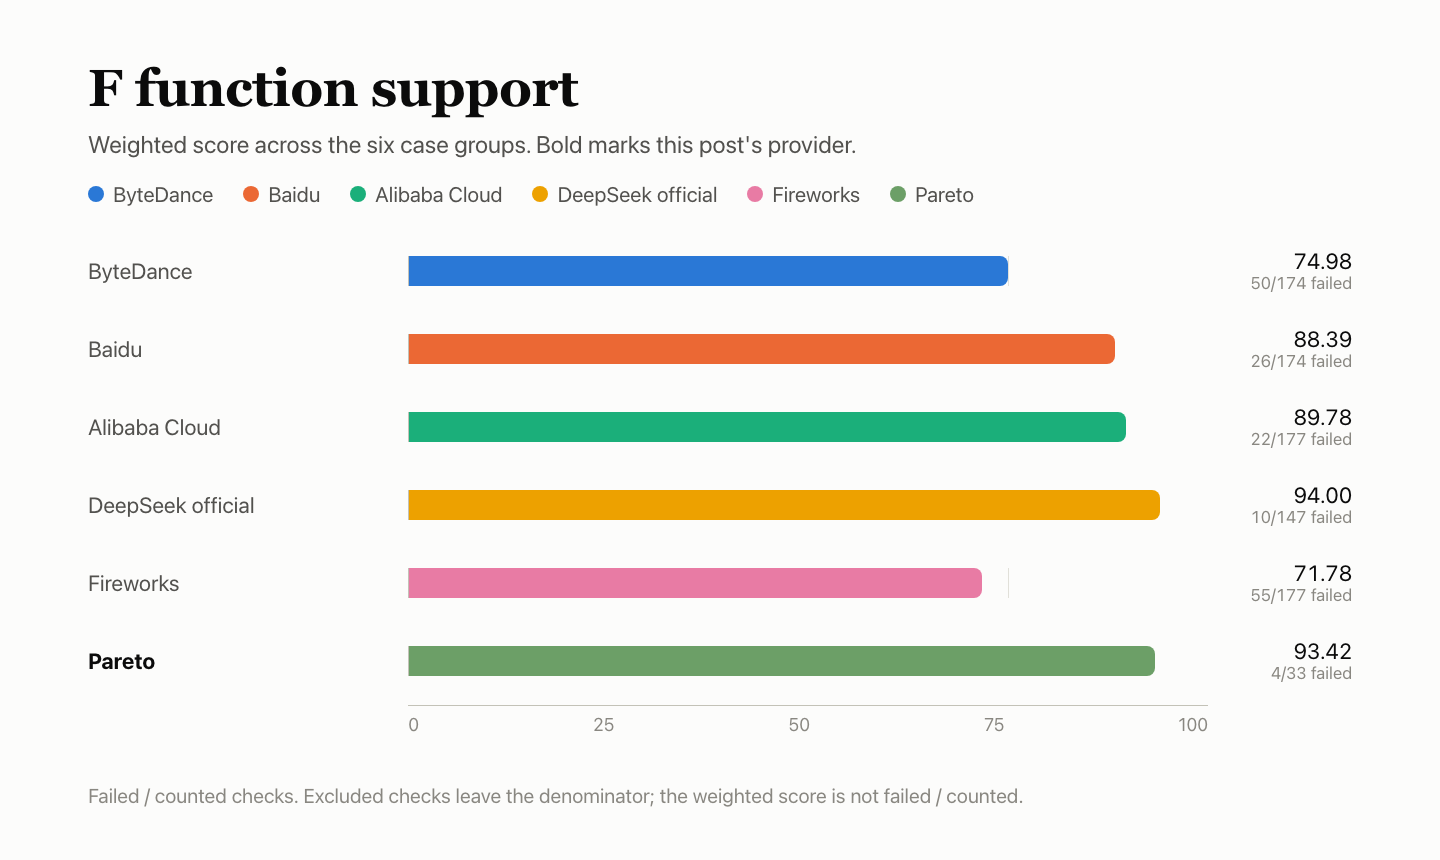
| 供应商 | 通过 | 失败 | 排除 | 加权得分 |
|---|---|---|---|---|
| ByteDance | 124 | 50 | 6 | 74.98 |
| Baidu | 148 | 26 | 6 | 88.39 |
| Alibaba Cloud | 155 | 22 | 3 | 89.78 |
| DeepSeek 官方渠道 | 137 | 10 | 33 | 94.00 |
| Fireworks | 122 | 55 | 3 | 71.78 |
| Pareto(本文) | 29 | 4 | 147 | 93.42 |
P — 响应速度:57.69
每个请求约包含 10,000 个输入 token,并要求生成约 1,100 个正文输出 token。在三个测试窗口中的每个窗口里,分别以单并发和 10 路并发运行 30 个请求,总计 180 个请求。
| 项目 | 详情 |
|---|---|
| 首个正文 token(TTFA) | 单并发下中位数 5.85 s(仅有效请求为 3.08 s),10 路并发下为 6.13 s(仅有效请求为 4.92 s) |
| 生成速度(TPOT) | 单并发下 4.42 ms/token,10 路并发下 4.63 ms/token |
| 有效吞吐量 | 10 路并发下 519.4 token/s |
| 有效请求 | 单并发下 53/90(窗口 1–3:15/30、18/30、20/30),10 路并发下 57/90(23/30、16/30、18/30);无效请求:70 个返回 200,但正文为 None |
| 子分数 | TTFA 24.59,TPOT 100.00,吞吐量 72.05;TTFA 和 TPOT 采用较低的档位,权重分别为 35% / 35% / 30%:响应得分 65.22 |
| P 得分 | 响应得分 65.22 × 80% + 缓存 K 27.58 × 20% = 57.69 |
无效请求按无限值计分,因此表中的中位数可能高于仅统计有效请求时的中位数。TPOT 根据流式输出分块估算,并非在硬件上逐 token 测量。吞吐量是 10 路并发下有效输出 token 数除以批次耗时。
与其他五家对比
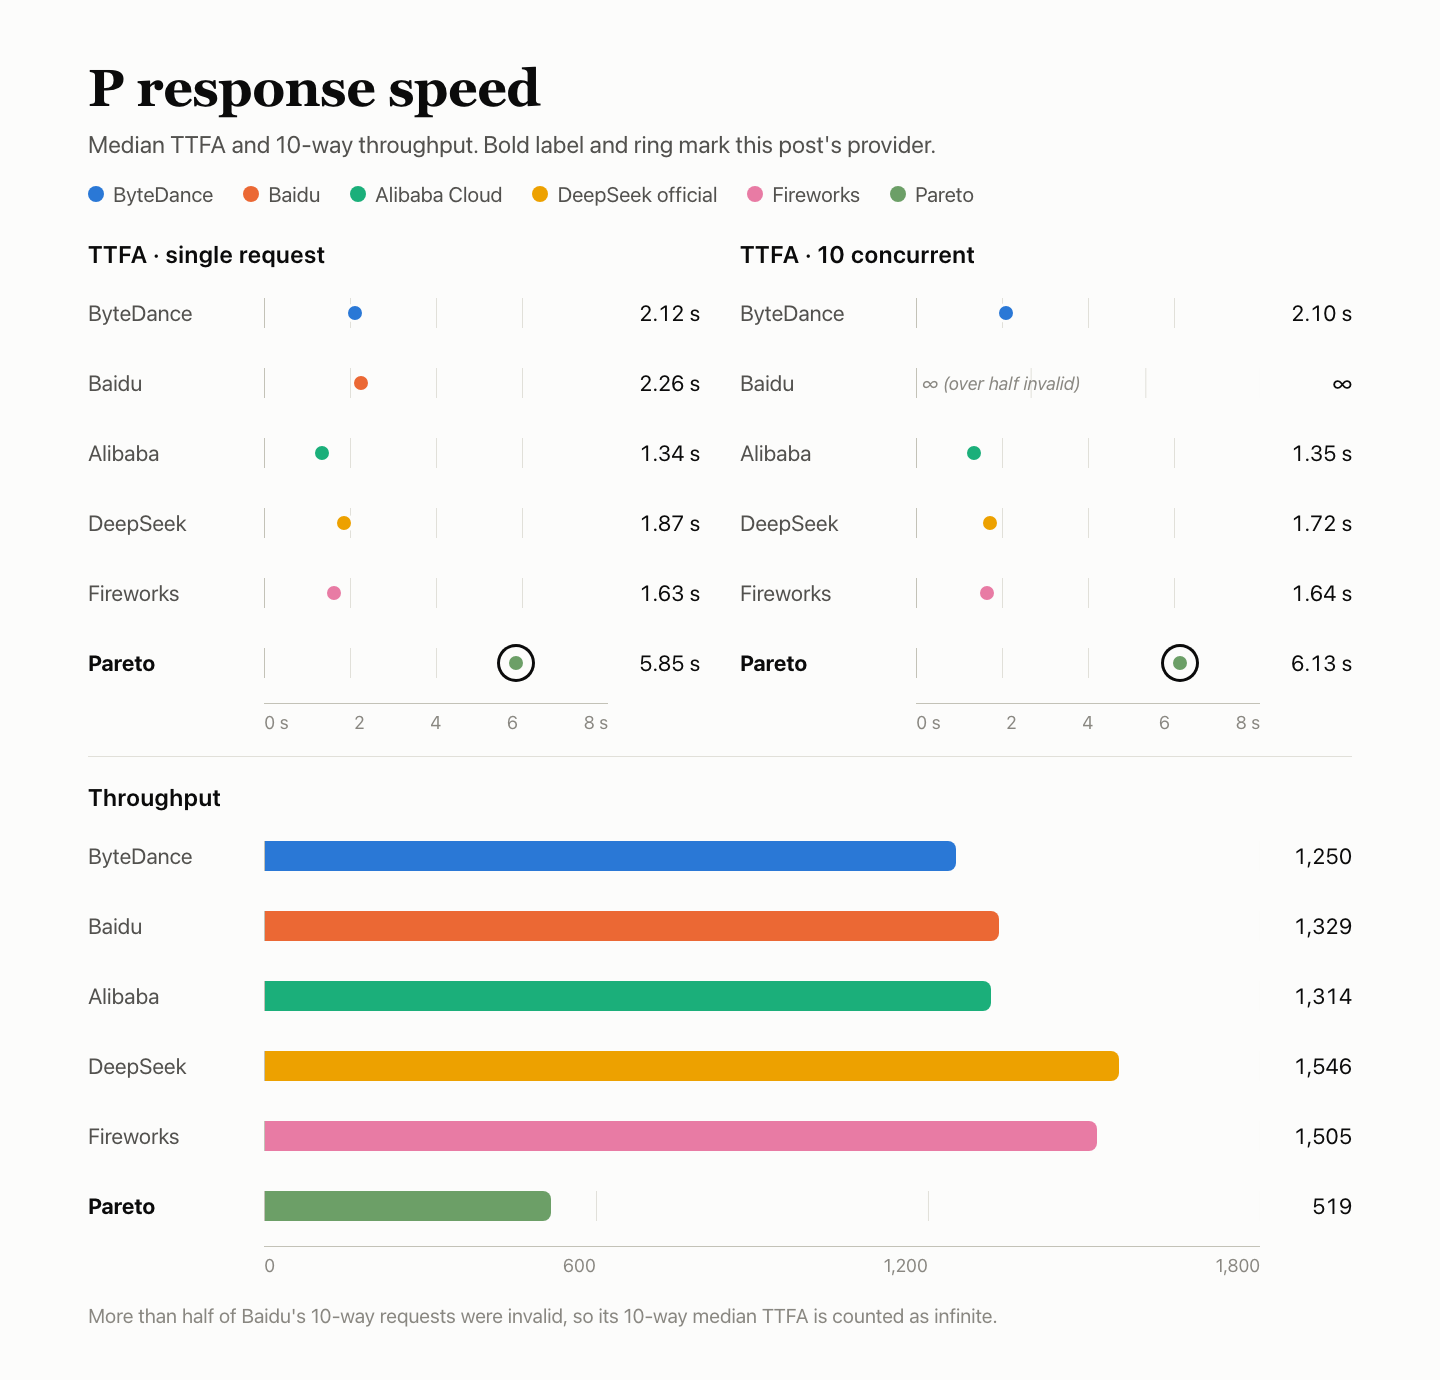
| 供应商 | 有效请求 | 单并发 TTFA | 10 路并发 TTFA | TPOT(较慢者) | 吞吐量 tok/s | 响应得分 |
|---|---|---|---|---|---|---|
| ByteDance | 180/180 | 2.12 s | 2.10 s | 3.43 ms | 1,250 | 82.00 |
| 百度 | 118/180 | 2.26 s | ∞ | 50.00 ms | 1,329 | 30.00 |
| 阿里云 | 180/180 | 1.34 s | 1.35 s | 4.69 ms | 1,314 | 85.88 |
| DeepSeek 官方渠道 | 165/180 | 1.87 s | 1.72 s | 2.84 ms | 1,546 | 83.08 |
| Fireworks | 179/180 | 1.63 s | 1.64 s | 3.29 ms | 1,505 | 84.22 |
| Pareto(本文) | 110/180 | 5.85 s | 6.13 s | 4.63 ms | 519 | 65.22 |
六家共用同一台机器、网络和账号。三个时间窗口按供应商依次安排,因此数据采集时段并不完全重叠;不应过度解读细微差异。∞ 表示超过一半的请求无效,因此中位数计为无穷大。
K — 缓存:27.58
每组发送五个请求。第一个请求携带约 8k 或 32k token 的固定前缀,并为缓存预热。第 2–4 个请求保留该前缀,仅更改最后的问题,间隔分别为 5 s、30 s 和 120 s。第五个请求使用新前缀作为冷缓存对照。三个时间窗口 × 两种长度,共计 30 个请求。K 为热请求读取的缓存 token 数除以按规则应可复用的 token 数,两种长度等权;K 占 P 的 20%。
| 时间窗口 | 1 · 预热 | 2 · +5 s | 3 · +30 s | 4 · +120 s | 5 · 冷缓存 |
|---|---|---|---|---|---|
| 8k 前缀 · 热请求命中 2/9 · 读取 15,872 / 72,504 个可复用 token · 21.89 | — | — | — | — | — |
| 时间窗口 1 | 0 | 0 | 7,936 | 0 | 0 |
| 时间窗口 2 | 0 | 0 | 0 | 0 | 0 |
| 时间窗口 3 | 0 | 0 | 7,936 | 0 | 0 |
| 32k 前缀 · 热请求命中 3/9 · 读取 96,000 / 288,513 个可复用 token · 33.27 | — | — | — | — | — |
| 时间窗口 1 | 0 | 0 | 32,000 | 0 | 0 |
| 时间窗口 2 | 0 | 0 | 0 | 0 | 0 |
| 时间窗口 3 | 0 | 0 | 0 | 32,000 | 0 |
| K(8k 和 32k 等权) | — | — | — | — | 27.58 |
数值为服务器报告的缓存读取 token 数;“Not returned”表示响应中缺少该字段。
8k 热请求命中 9 次中的 2 次,每次命中读取 7,936 个 token;32k 热请求命中 9 次中的 3 次,每次命中读取 32,000 个 token。冷请求没有读取缓存,因此热请求和冷请求可以清楚地区分。
与另外五家对比
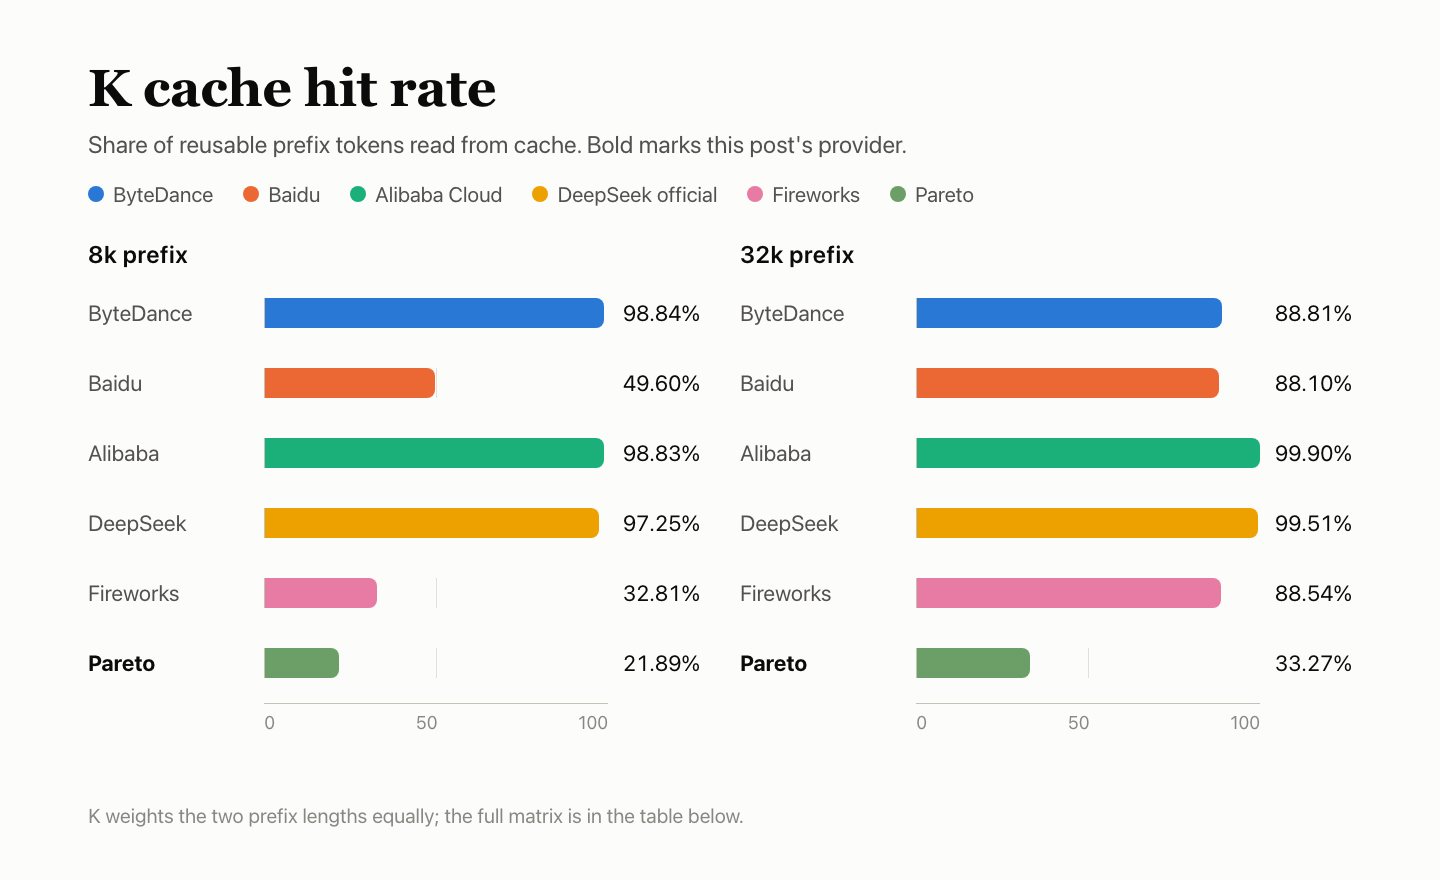
| 供应商 | 8k 命中次数 | 8k | 32k 命中次数 | 32k | K |
|---|---|---|---|---|---|
| 字节跳动 | 9/9 | 98.84 | 8/9 | 88.81 | 93.83 |
| 百度 | 5/9 | 49.60 | 8/9 | 88.10 | 68.85 |
| 阿里云 | 9/9 | 98.83 | 9/9 | 99.90 | 99.37 |
| DeepSeek 官方渠道 | 9/9 | 97.25 | 9/9 | 99.51 | 98.38 |
| Fireworks | 3/9 | 32.81 | 8/9 | 88.54 | 60.68 |
| Pareto(本文) | 2/9 | 21.89 | 3/9 | 33.27 | 27.58 |
R — 服务稳定性:100
这 300 个请求分为四种类型:短文本、长输入、工具调用和多轮历史记录。它们在三个时间窗口内以单并发运行。只检查首次尝试是否返回有效且完整的响应;不评判答案,也不重试。答案质量和速度部分的失败计入 Q 和 P,不会在 R 中重复计算。
| 请求类型 | 首次尝试成功率 |
|---|---|
| 短文本 | 120/120 |
| 10k 长输入 | 90/90 |
| 工具调用 | 60/60 |
| 多轮历史记录 | 30/30 |
| 总计 · 95% 置信区间 98.78%–100% | 300/300 |
全部 300 个请求首次尝试均返回了有效且完整的响应。R = 100 仅描述这 300 个专门测试的请求;这并不意味着整个测试链路没有失败。95% 置信区间的下限为 98.78%:300 次请求全部成功,只能说明失败率很可能低于 1.22%。
与另外五家对比
| 供应商 | 首次尝试成功率 | 95% 置信区间 |
|---|---|---|
| 字节跳动 | 300/300 | 98.78%–100% |
| 百度 | 300/300 | 98.78%–100% |
| 阿里云 | 300/300 | 98.78%–100% |
| DeepSeek 官方渠道 | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
| Pareto(本文) | 300/300 | 98.78%–100% |
R 仅涵盖这 300 个专门测试的请求;答案质量和速度部分的失败记入 Q 和 P,不会在 R 中重复计算。
常见问题
为什么只统计了 33 项检查,F 却是 93.42?
原始统计的检查项中,33 项有 29 项通过;按实际观测到的组别权重重新归一化后,F 为 93.42。其余 147 个计划中的检查项不纳入评分。流式输出记录描述了特定可用功能,不会增加计分检查项。显示的总分仍为 68.72。
为什么 TPOT 得分为 100.00,P 却只有 57.69?
180 个速度请求中只有 110 个有效;70 个请求返回 200,但值为 None。无效请求按无穷大计算,因此首次正文 token 的中位延迟在单并发时为 5.85 s,在 10 路并发时为 6.13 s(仅计有效请求时分别为 3.08 s 和 4.92 s)。TTFA 得分为 24.59,吞吐量得分为 72.05,响应得分为 65.22;加上权重为 20% 的缓存 K(27.58),P 为 57.69。
为什么 K 只有 27.58?
8k 时热请求命中 9 次中的 2 次(21.89),32k 时命中 9 次中的 3 次(33.27),两种长度等权。命中时分别读取 7,936 或 32,000 个 token,冷缓存对照请求均未读取缓存。
Pareto 的答案质量高于官方渠道吗?
无法明确区分。综合准确率为 44.58%,官方渠道为 42.45%,相差 +2.12 个百分点;但 95% 置信区间为 −0.02 到 +4.18,跨过了 0。HLE 和 AA-LCR 的评判模型 deepseek-flash 未经过校准,可能存在宽松倾向。
F 中哪些情况未通过?
有两项。流式输出的停止序列在三个时间窗口中都返回了空响应正文,而不带停止序列的相同输入则正常工作。一次三次测试中,精确文本输出末尾多了一个句号。
继续阅读:DeepSeek V4.1 Flash 系列
- Pareto 的 Q 高出 +2.12,是相对于官方渠道测得的;基线自身的测试见DeepSeek 官方渠道 DeepSeek V4.1 Flash 评测:对比基线,单并发下有 15 个无效请求。
- Fireworks 的停止请求也返回了空响应正文,且 8k 时命中 9 次中的 3 次:Fireworks DeepSeek V4.1 Flash 评测:停止请求返回空响应正文,8k 缓存热请求命中 9 次中的 3 次。
- 阿里云的热请求命中 18 次中的 18 次,而 Pareto 为 18 次中的 5 次:阿里云 DeepSeek V4.1 Flash 评测:首次正文 token 延迟 1.34s,18 个热请求全部命中缓存,答案与官方渠道难以区分。
- 字节跳动的速度请求全部有效,首次正文 token 延迟为 2.12 s:字节跳动 DeepSeek V4.1 Flash 评测:答案与官方渠道难以区分,输入计数不匹配。
- 百度也有大量速度请求失败,错误为 no_available_channel:百度 DeepSeek V4.1 Flash 评测:工具调用表现与官方渠道相当,频繁出现 no-available-channel 拉低答案质量和速度。
来源
- DeepSeek V4.1 Flash 1017 模型页面(AIHubMix)
- AIHubMix Provider Benchmark Standard v2.0(AIHubMix 文档)
- 快速入门(AIHubMix 文档)
- 模型(AIHubMix)
- DeepSeek API 文档(DeepSeek)


