

2026-11-03/04,APB Full 套件通过 AIHubMix 对五家供应商的 DeepSeek V4.1 Flash 1017 进行了测试。所有供应商使用相同的模型、问题、参数和请求脚本;该模型列于AIHubMix 模型页面,五家供应商的条目则列于模型页面。本 APB Profile 仅介绍 Alibaba Cloud:各部分测量了什么,以及测试结果如何。
本文报告测试分数,不对供应商进行排名或推荐。先看 Q、F、P、K 和 R;K 是 P 的子分数。总分是汇总指数,并非认证结果,也没有置信区间。评分规则见 AIHubMix Provider Benchmark Standard v2.0。
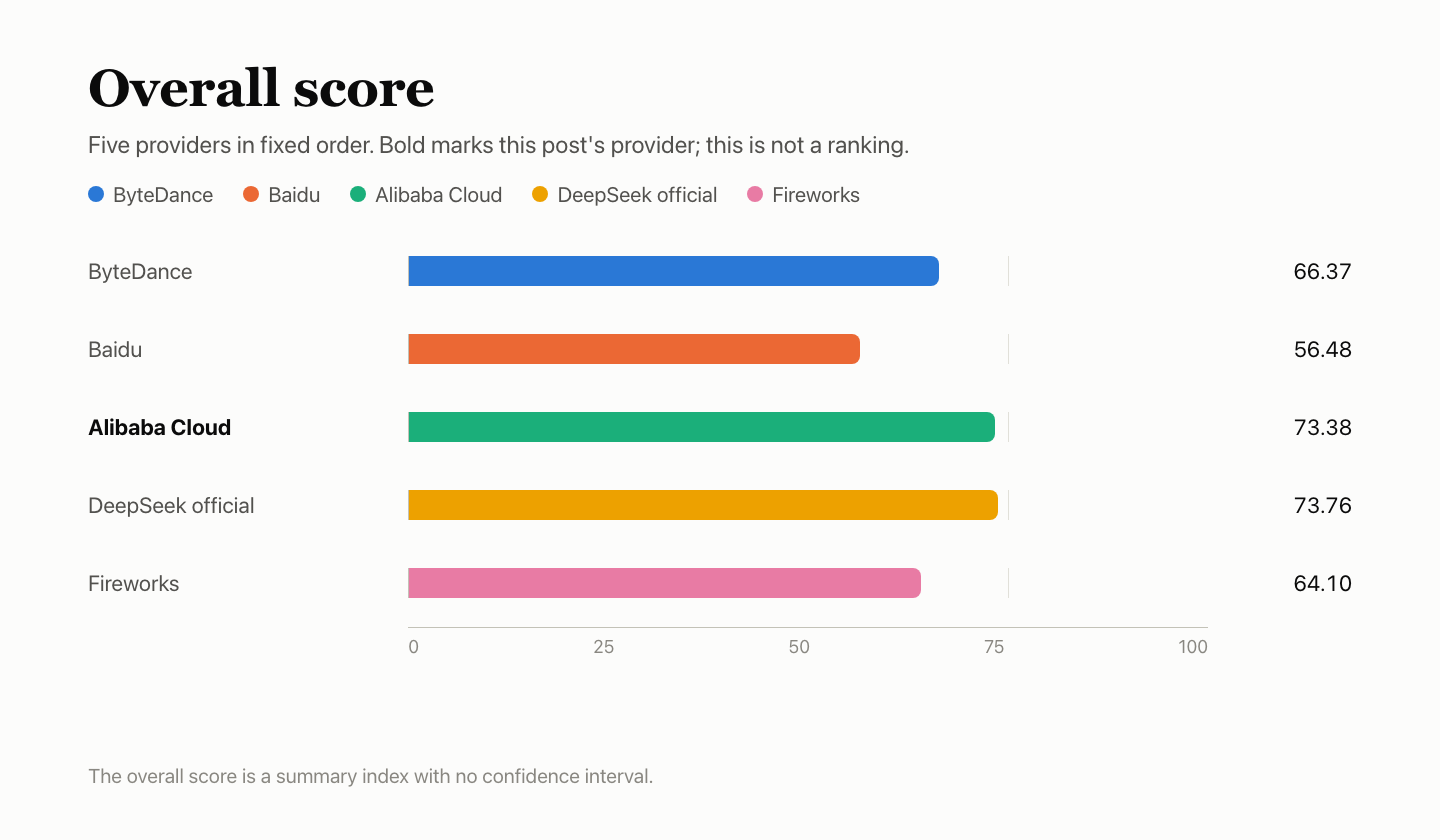
五家供应商的得分
粗体标出本文所述的供应商。供应商按固定顺序排列,不代表排名。K 是 P 的子分数,占 20%,单独列出以供参考。总分是没有置信区间的汇总指数。DeepSeek 官方渠道和 Alibaba Cloud 的总分相差 0.37,无法区分二者。
概览
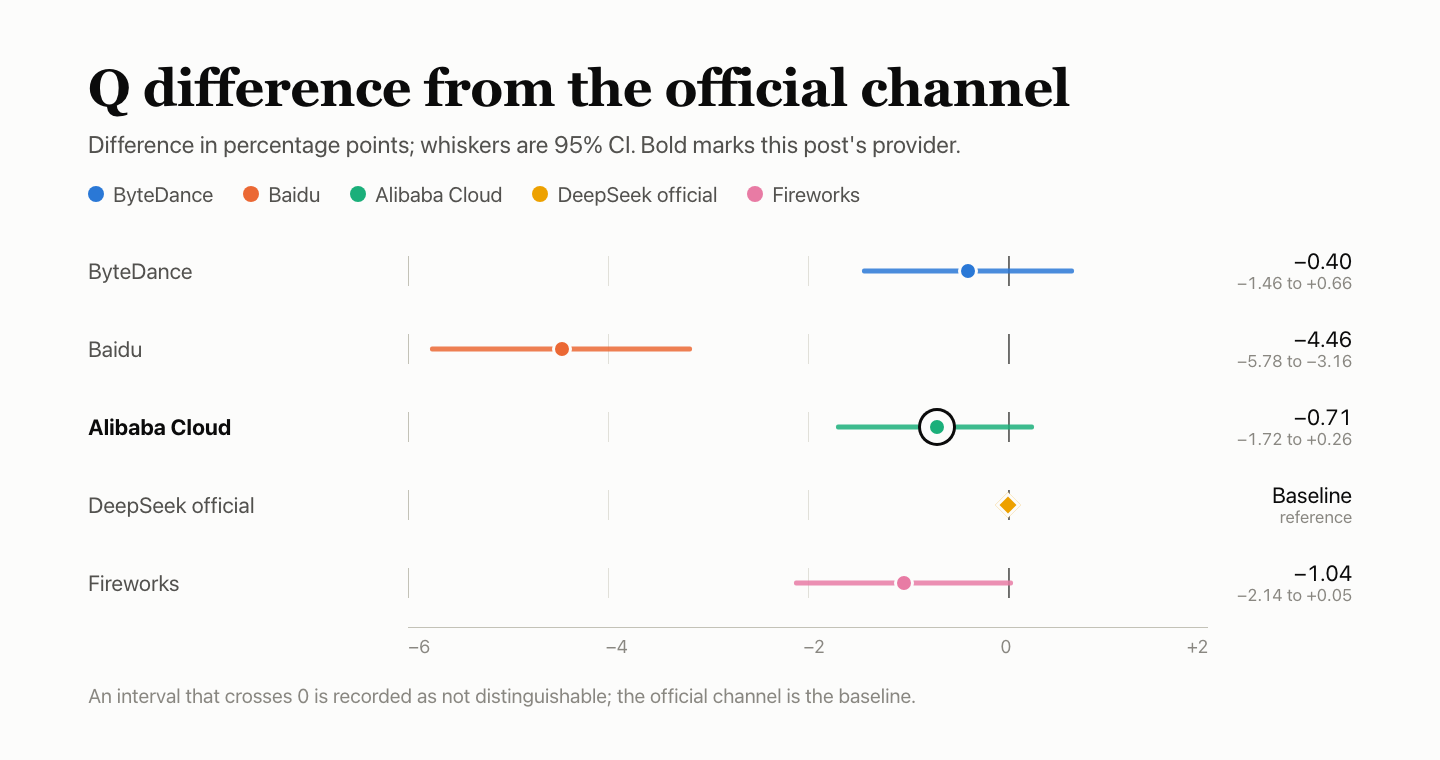
- 回答质量:Q 41.75。BFCL 87.00%、HLE 13.29%、AA-LCR 53.60%。与官方渠道相比,相差 −0.71 个百分点,95% 区间为 −1.72 至 +0.26,因此无法区分二者。
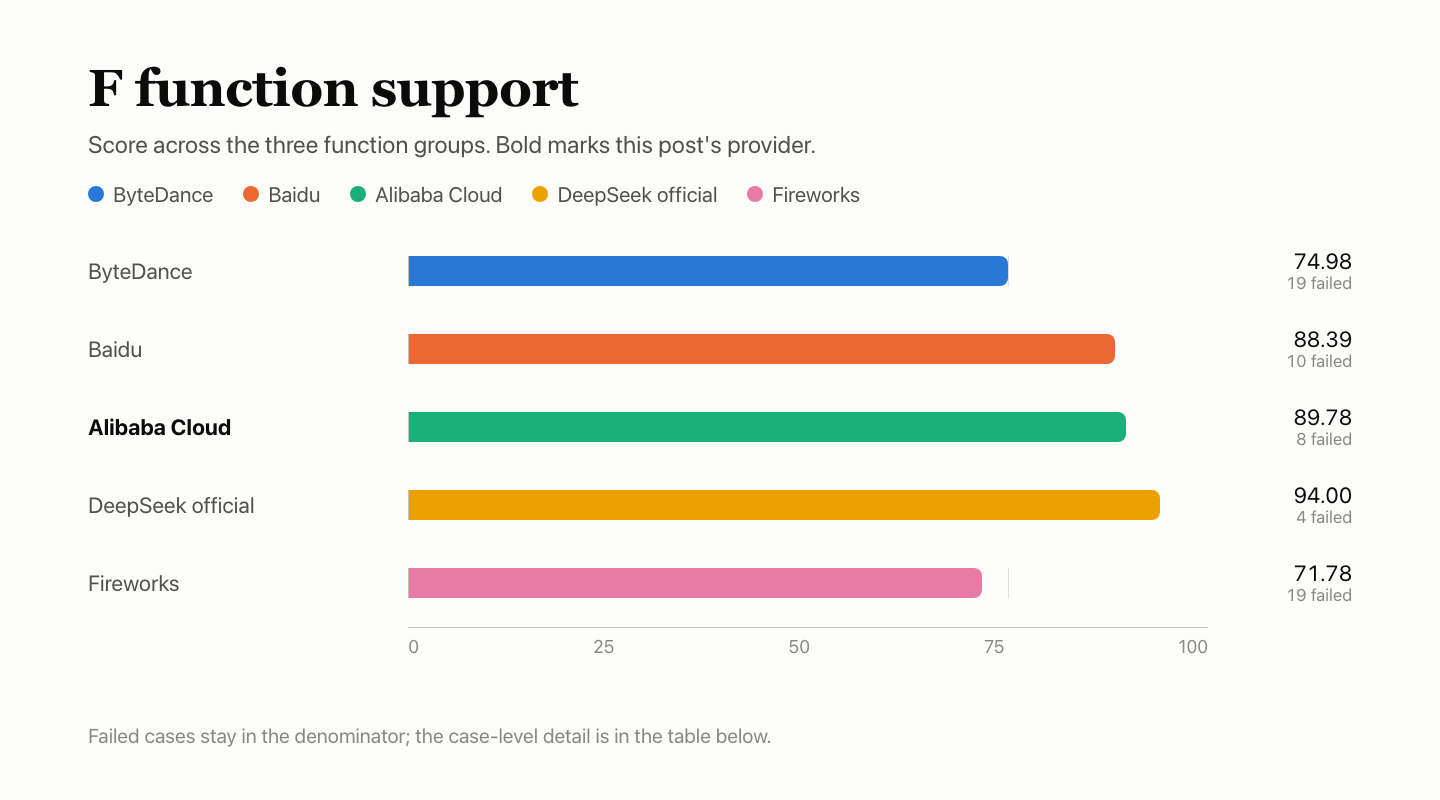
- 功能支持:F 89.78。分母中的 177 项检查有 155 项通过。无效工具 schema 返回了 503,而非参数错误;上下文溢出未返回文档所述的错误类型;孤立工具结果则返回了 200。
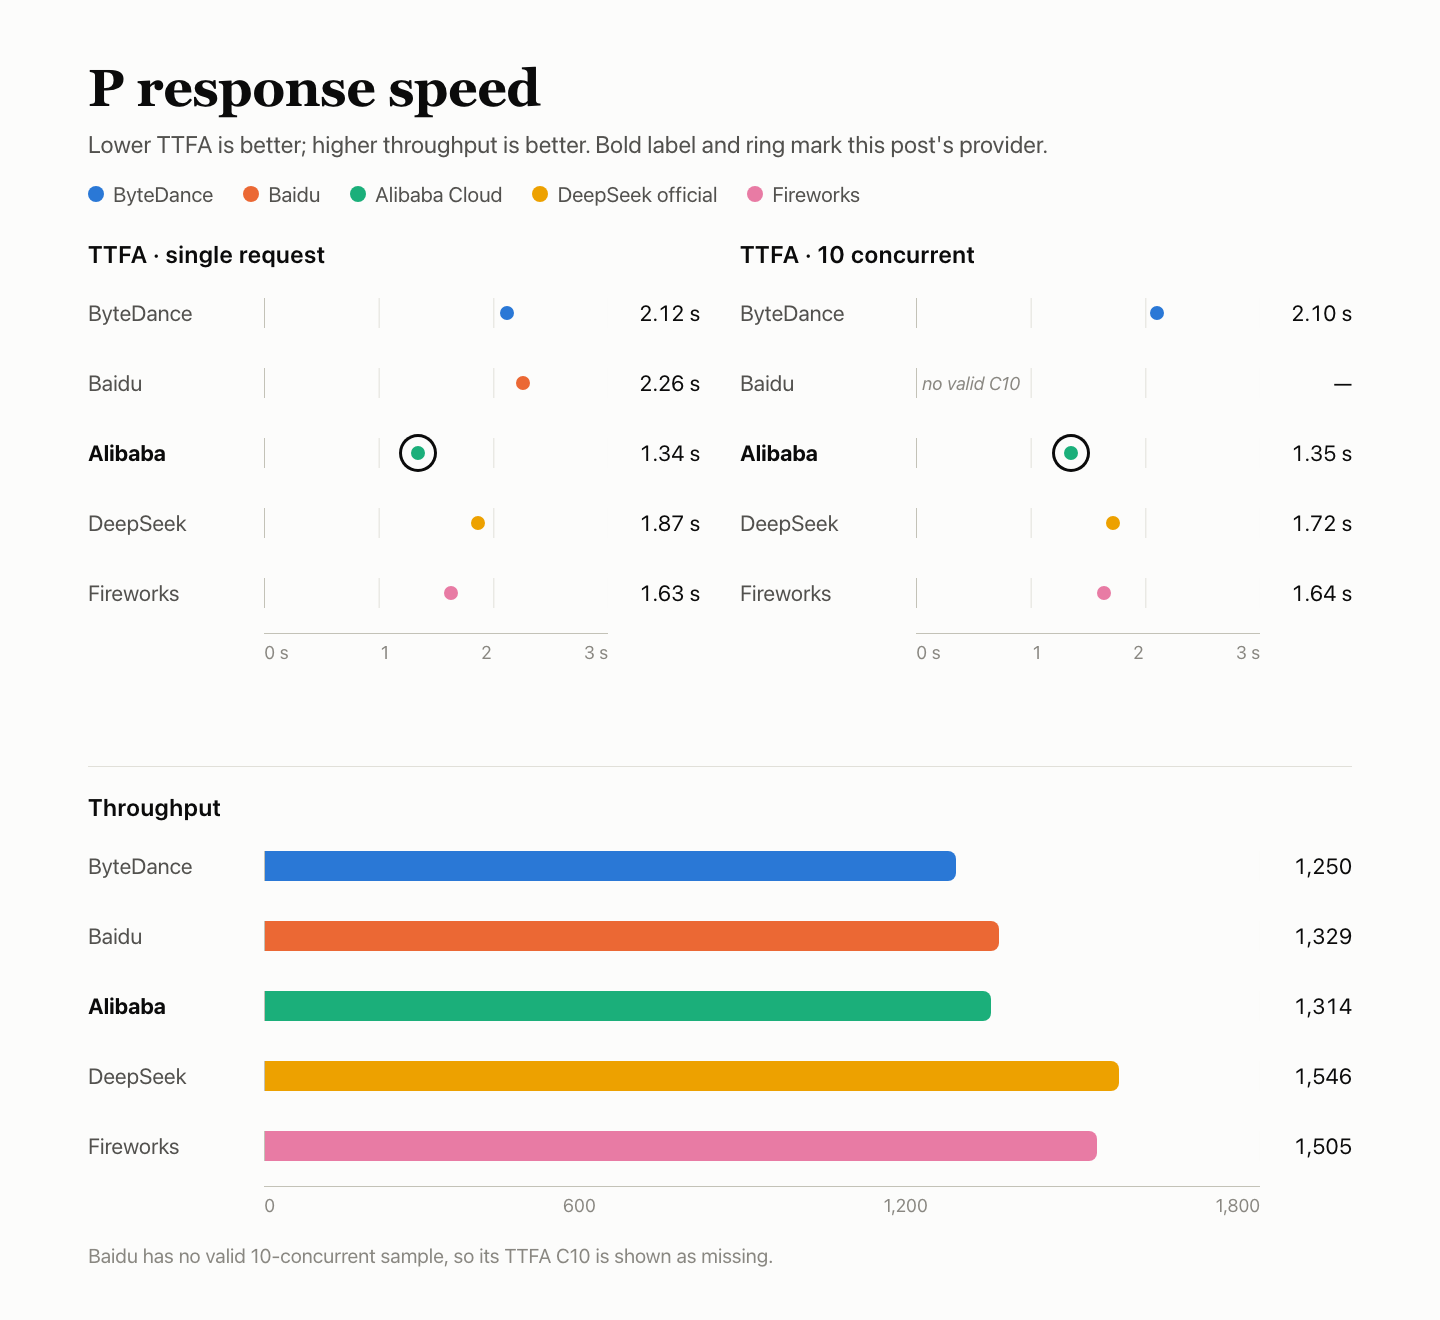
- 响应速度:P 88.58。单并发下首个内容 token 的中位数为 1.34 s,10 并发下为 1.35 s;TPOT 为 4.69 ms,180 个速度测试请求全部有效。
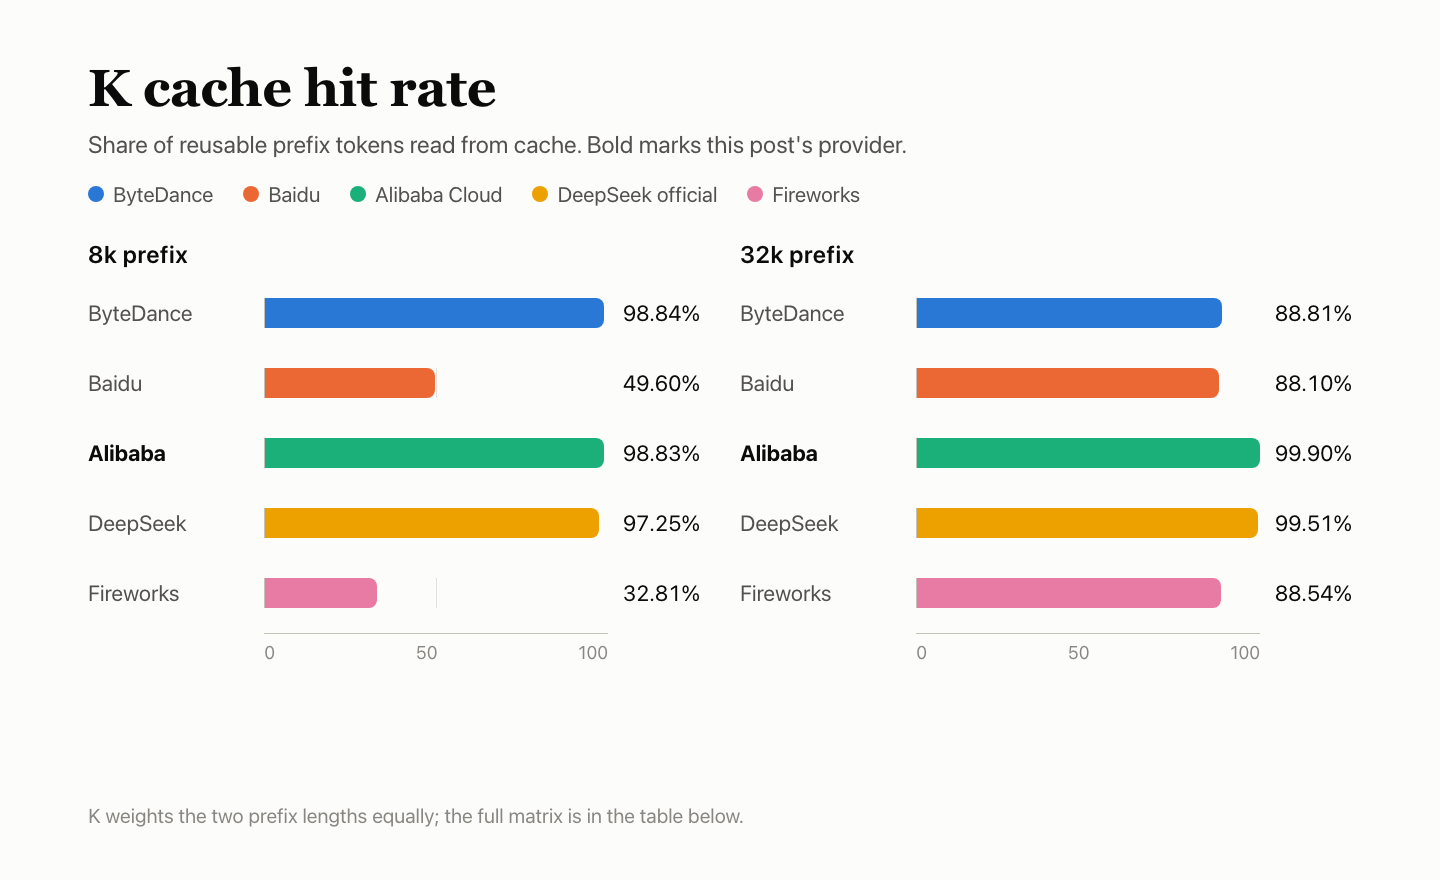
- 缓存:K 99.37。在 8k 和 32k 前缀下的 18 个热请求全部命中,冷请求对照组均未读取缓存。
- 服务稳定性:R 100。300 个专用请求均在首次尝试时成功。
测试设置
测试通过 AIHubMix 进行,方法是选择供应商模型 ID;快速入门文档介绍了接入方式。DeepSeek 的定价页面列出了该模型的公布价格。
| 项目 | 详情 |
|---|---|
| 模型 | DeepSeek V4.1 Flash 1017 |
| 请求的模型 ID | alicloud-deepseek-v4.1-flash-1017 |
| 返回的模型名称 | deepseek-v4.1-flash-1017 |
| 接入路径 | 通过 AIHubMix 选择供应商模型 ID 接入,而非连接到供应商自己的账户 |
| 参数 | 非思考模式,temperature 1.0,max_tokens 16,384,超时 300 s,不自动重试 |
| 关闭思考模式 | 所有请求均使用 reasoning_effort=none |
| 时间 | 2026-11-03 18:07 – 11-04 16:33 UTC+8。五家供应商共用一台 Mac mini、同一网络和账户。 |
| 样本量 | 回答质量:4,250 次问题运行(BFCL 500 × 3 轮、HLE 250 × 10、AA-LCR 25 × 10);功能用例:60 × 3 个时段;速度:单并发 90 次、10 并发 90 次;稳定性:300 次;缓存:30 次(8k 和 32k 前缀,各 3 组) |
Q — 回答质量:41.75
回答质量测试使用了三组问题:500 道 BFCL 问题,每题 3 轮;250 道 HLE 问题,每题 10 轮;以及 25 道 AA-LCR 问题,每题 10 轮。BFCL 按自动规则评分;HLE 和 AA-LCR 由评判模型 deepseek-flash 评估。五家供应商回答了相同的问题,三组结果合并计算为一个准确率。由于问题无法评分,10 个回答被剔除,最终留下 4,240 次可评分的问题运行。
| 任务 | 问题数 | 正确数 | 准确率 | 失败数 |
|---|---|---|---|---|
| BFCL 工具调用 | 500 × 3 | 1,305/1,500 | 87.00% | 0 |
| HLE 高难度问答 | 250 × 10 | 331/2,490 | 13.29% | 8 |
| AA-LCR 长文档推理 | 25 × 10 | 134/250 | 53.60% | 0 |
| 合计 · 95% 区间 39.56%–43.85% | — | 1,770/4,240 | 41.75% | 8 |
服务故障(请求失败或输出被截断)仍计入分母,并按错误计算,不会被剔除。Alibaba Cloud 的 HLE 输出达到 max_tokens 限制并被截断 8 次。
每道 BFCL 问题测试 3 轮;表格展示这 3 轮合并后的结果。
| BFCL 类别 | 通过数 | 通过率 |
|---|---|---|
| simple_python:一个函数,调用及参数正确 | 332/360 | 92.22% |
| multiple:从多个函数中选出正确的函数 | 270/300 | 90.00% |
| parallel:并行多次调用同一个函数 | 273/300 | 91.00% |
| parallel_multiple:并行调用多个不同函数 | 212/240 | 88.33% |
| irrelevance:没有相关函数,不应调用任何函数 | 113/150 | 75.33% |
| ahm_multi_turn:三阶段工具链 | 105/150 | 70.00% |
与其他四家相比
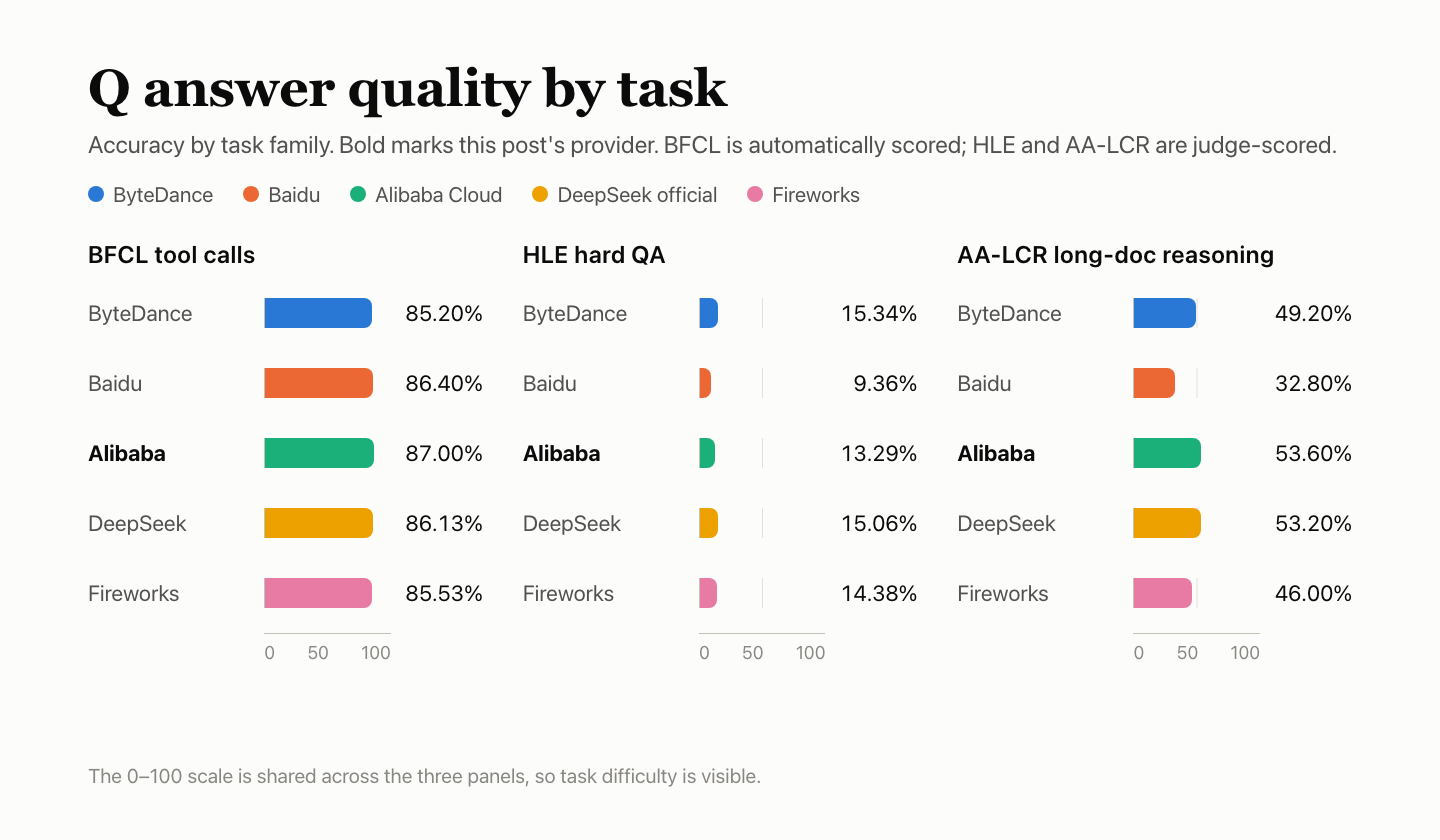
与官方渠道相比:准确率差异以百分点表示,误差线显示 95% 区间;区间跨过 0 即视为没有差异。HLE 和 AA-LCR 的评判模型 deepseek-flash 与被测模型属于同一个 DeepSeek 系列,且未经校准,因此评分可能偏宽松。
F — 功能支持:89.78
功能用例检查接口行为是否符合协议,而非模型回答得好不好。60 个用例分为六组,每组在三个时段各运行一次,共 180 项检查,并根据各供应商文档说明的格式进行判定。不适用、无效或未观察到的检查会从分母中剔除。Alibaba Cloud 在分母中的 177 项检查里通过了 155 项;按组别权重计算,得分为 89.78。
加权得分根据各组权重计算,并非将 177 项检查的通过数简单相加。
| 组别 | 权重 | 通过数 | 排除数 | 组别得分 |
|---|---|---|---|---|
| 流式输出和消息协议 | 20% | 30/30 | — | 100.00 |
| 工具接口 | 20% | 30/30 | — | 100.00 |
| 输出约束和参数 | 20% | 30/30 | — | 100.00 |
| 上下文和状态 | 15% | 26/30 | — | 86.67 |
| 错误和恢复 | 15% | 18/30 | — | 60.00 |
| 计量和缓存协议 | 10% | 21/27 | 3 | 77.78 |
| 总计 · 加权得分 | — | 155/177 | 3 | 89.78 |
时段计数为 3/3,表示该用例在三个时段均失败。
| 失败用例 | 失败时段数 | 原因 |
|---|---|---|
| 上下文溢出(上下文和状态) | 3/3 | 返回了错误,但不是文档所述的上下文长度错误 |
| messages 格式错误(错误和恢复) | 3/3 | 返回 400,响应正文为空,没有结构化错误说明 |
| 工具 schema 无效(错误和恢复) | 3/3 | 应返回参数错误,但实际返回 503 |
| 孤立工具结果(错误和恢复) | 3/3 | 应返回参数错误,但实际返回 200 |
| stream_options 格式错误(错误和恢复) | 3/3 | 返回 400,响应正文为空,没有结构化错误说明 |
| 推理 token 计量(计量和缓存协议) | 3/3 | 未返回推理 token 数量 |
| 工具定义计为输入(计量和缓存协议) | 3/3 | 有工具定义时,报告的输入 token 数量并未高于没有工具定义时 |
| 请求隔离(上下文和状态) | 1/3 | 第一步没有按要求仅回复 STORED,因此无法继续进行隔离检查 |
这些检查从分母中排除,既不计为通过,也不计为失败。
| 状态 | 用例 | 数量 | 原因 |
|---|---|---|---|
| 不适用 | 显式 cache_control | 3 | 已提前登记为此接口不支持 |
messages 格式错误和 stream_options 格式错误这两类用例在五家供应商上均失败:每家都返回 400,且响应正文为空,因此客户端收不到结构化错误说明。五家表现一致,更可能是 AIHubMix 网关层的问题,需要单独调查。推理 token 计量也在五家供应商上均失败,但原因不同:ByteDance 和 Fireworks 在关闭思考模式时仍报告了推理 token;其余三家则未返回推理 token 数量。
与其他四家相比
P — 响应速度:88.58
每个请求携带约 10,000 个输入 token,并要求生成约 1,100 个输出 token。在三个时段中,单并发和 10 并发各发送 30 个请求,共 180 个。每个有效请求均测量首个内容 token 等待时间(TTFA),表格报告中位数。TPOT 根据流式输出分块的时间估算,并非硬件层面的逐 token 计时;吞吐量则为 10 并发下的有效输出 token 数除以批次总耗时。
| 指标 | 结果 |
|---|---|
| 首个内容 token TTFA | 单并发中位数 1.34 s,10 并发中位数 1.35 s |
| 生成速度 TPOT | 单并发 4.63 ms/token,10 并发 4.69 ms/token |
| 有效吞吐量(goodput) | 10 并发 1,313.6 token/s |
| 有效请求数 | 单并发 90/90,10 并发 90/90 |
| 分项得分 | TTFA 59.65,TPOT 100.00,吞吐量 100.00;TTFA 和 TPOT 取两个并发级别中的较低值,权重分别为 35% / 35% / 30%,响应得分为 85.88 |
| P 得分 | 响应得分 85.88,占 80%;缓存 K 99.37,占 20%;总分 88.58 |
与其他四家相比
五家供应商共用同一台机器、网络和账户。三个时段按供应商依次安排,因此各供应商的数据采集时段并未完全重叠,不应过度解读细微差距。
K — 缓存:99.37
每组有五个请求:第一个请求携带约 8k 或 32k token 的固定前缀,为缓存预热;第 2–4 个请求保留此前缀,只更改末尾的问题,分别在 5、30 和 120 秒后发送;第五个请求使用新前缀作为冷请求对照组。三个时段 × 两种长度,共 30 个请求。K 的计算方式是:热请求读取的缓存 token 数量除以按规则应可复用的 token 数量,两种长度各占一半权重;K 占 P 的 20%。矩阵显示的是服务器报告的缓存读取 token 数量。
| 前缀 | 时段 | 预热(请求 1) | 5 s 热请求 | 30 s 热请求 | 120 s 热请求 | 冷请求对照组(请求 5) |
|---|---|---|---|---|---|---|
| 8k | 时段 1 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | 时段 2 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | 时段 3 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 32k | 时段 1 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| 32k | 时段 2 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| 32k | 时段 3 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| 前缀 | 热请求命中数 | 读取的 token 数 | 应可复用数量 | 得分 |
|---|---|---|---|---|
| 8k | 9/9 | 71,424 | 72,270 | 98.83 |
| 32k | 9/9 | 288,000 | 288,279 | 99.90 |
| K(8k 和 32k,各占一半) | 99.37 |
全部 9 个 8k 热请求均命中,每个读取 7,936 个 token;全部 9 个 32k 热请求均命中,每个读取 32,000 个 token。预热请求和冷请求对照组均未读取缓存,因此热请求与冷请求区分明确。
与其他四家相比
R — 服务稳定性:100
300 个请求涵盖四种类型——短文本、10k 长输入、工具调用和多轮历史记录——并在三个时段以单并发发送。只检查首次响应是否有效且完整;不检查回答正确性,也不进行重试。回答质量和速度部分的故障分别计入 Q 和 P,不会在 R 中重复计算。
| 请求类型 | 首次尝试成功数 |
|---|---|
| 短文本 | 120/120 |
| 10k 长输入 | 90/90 |
| 工具调用 | 60/60 |
| 多轮历史记录 | 30/30 |
| 总计 · 95% 区间 98.78%–100% | 300/300 |
首次尝试时,全部 300 个请求均返回了有效且完整的响应。R 仅涵盖这 300 个专用请求,并不意味着整个链路没有失败。95% 区间的下限为 98.78%:即使 300/300 全部成功,失败率也很可能低于 1.22%。
与另外四家相比
R 仅涵盖这 300 个专用请求;答案质量和速度方面的失败记录在 Q 和 P 中,不会在 R 中重复计算。
| 供应商 | 首次尝试成功率 | 95% 区间 |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek 官方 | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
常见问题
Alibaba Cloud 与官方渠道之间 0.37 的总分差距有实际意义吗?
没有。本次测试中,两者无法区分:Q 的差异为 −0.71 个百分点,95% 区间为 −1.72 至 +0.26,其中包含 0;而总分是汇总指标,没有置信区间。
Q 分数由哪些部分组成?
由三组测试组成:BFCL 500 道题 × 3 轮,自动评分;HLE 250 × 10 和 AA-LCR 25 × 10,由裁判模型 deepseek-flash 评分。4,240 次评分题目运行的综合准确率为 41.75%。
为什么 177 项检查中有 155 项通过,F 分数却是 89.78?
该分数按组加权,而不是简单的通过率。错误与恢复得分为 60.00,计量与缓存协议得分为 77.78,而三个协议组的得分均为 100.00。
为什么其他部分有请求失败,R 却报告 100?
R 仅涵盖 300 个专用稳定性请求。答案质量和速度方面的失败记录在 Q 和 P 中,不会在 R 中重复计算。
K 99.37 是缓存命中率吗?
它表示热请求中读取的缓存 token 数量与可复用 token 数量之比,8k 和 32k 各占一半权重。8k 前缀得分为 98.83,32k 前缀得分为 99.90。
首 token 耗时 1.34 秒,是否意味着完整答案会在 1.34 秒内到达?
不是。这是等待首个内容 token 的时间。每个请求约要求输出 1,100 个 token,10 并发时的 TPOT 为每个 token 4.69 ms。
继续阅读:DeepSeek V4.1 Flash 系列
- Alibaba Cloud 的综合 Q 分数与官方基线相差 0.71 个百分点,处于包含 0 的区间内;ByteDance 的评测将同样的对比延伸到工具调用计量:ByteDance 上的 DeepSeek V4.1 Flash:工具调用匹配,计量却不一致。
- Alibaba Cloud 的 180 个速度请求全部有效;Baidu 的评测使用相同的测试框架,其中没有可用渠道影响 Q 和 P:Baidu 上的 DeepSeek V4.1 Flash:没有可用渠道影响 Q 和 P。
- 官方渠道是本文答案质量对比的基线;其自身评测涵盖 F 94.00,以及 15 次无效的单并发探测:官方渠道上的 DeepSeek V4.1 Flash:F 94.00,15 次无效探测。
- Alibaba Cloud 在两种前缀长度下的 9/9 个热请求均命中;Fireworks 的评测涵盖空的停止回复,以及 8k 下 9 次请求中有 3 次缓存命中:Fireworks 上的 DeepSeek V4.1 Flash:空停止回复,3/9 次缓存命中。


