4 серпня 2026 року офіційна сторінка статусу DeepSeek зафіксувала два інциденти деградації продуктивності API.
Перший інцидент тривав 1 годину 18 хвилин, з 02:02 до 03:20 UTC, і вплинув на DeepSeek V4 Flash, V4 Pro та Expert Mode. Другий інцидент тривав 36 хвилин, з 03:43 до 04:20 UTC, і вплинув на API DeepSeek V4 Flash.
Обидва інциденти вже усунено. OpenCode також повідомила, що DeepSeek Flash зіткнувся з проблемами місткості через безприкладний попит. Проте офіційна сторінка статусу DeepSeek лише підтвердила деградацію продуктивності й не опублікувала першопричину.
TL;DR
- Офіційна сторінка статусу DeepSeek зафіксувала два інциденти деградації продуктивності, що вплинули на V4 Flash 4 серпня 2026 року.
- Пряма інтеграція з одним провайдером створює єдину точку відмови, навіть коли та сама модель доступна деінде.
- AIHubMix може повторити запит до тієї самої моделі через кілька каналів провайдерів, коли upstream-маршрут повертає помилку, яку можна повторити.
- Якщо всі канали провайдерів для основної моделі відмовляють, резервна заміна моделі на рівні ключа може перенаправити запит на налаштовані резервні моделі.
- Маршрутизація через кількох провайдерів знижує залежність від однієї кінцевої точки, але не може усунути скорельовані відмови або ризики на рівні шлюзу.
Такі інциденти підкреслюють важливий принцип інфраструктури:
Надійної моделі недостатньо, якщо доступ до неї здійснюється через одну кінцеву точку провайдера.
Одна модель не обов’язково означає одного провайдера
Коли застосунок підключається безпосередньо до одного провайдера, ця кінцева точка стає єдиною точкою відмови.
Якщо у провайдера виникає збій, досягнуто ліміту запитів або стрибок затримки, застосунку нікуди надіслати запит. Користувачі бачать тайм-аути й помилки, навіть коли та сама модель залишається доступною через інші інфраструктурні сервіси.
AIHubMix відокремлює модель від провайдера, який її обслуговує.
Наприклад, DeepSeek V4 Flash доступна через кількох провайдерів на AIHubMix, зокрема DeepSeek, Baidu, DeepInfra та Alibaba Cloud. Застосунки продовжують використовувати одну сумісну з OpenAI кінцеву точку API, а AIHubMix керує доступними upstream-маршрутами.
Це створює два окремі рівні надійності.
Рівень 1: Failover провайдера
Failover провайдера зберігає запитувану модель незмінною, але перемикає інфраструктурного провайдера, що стоїть за нею.
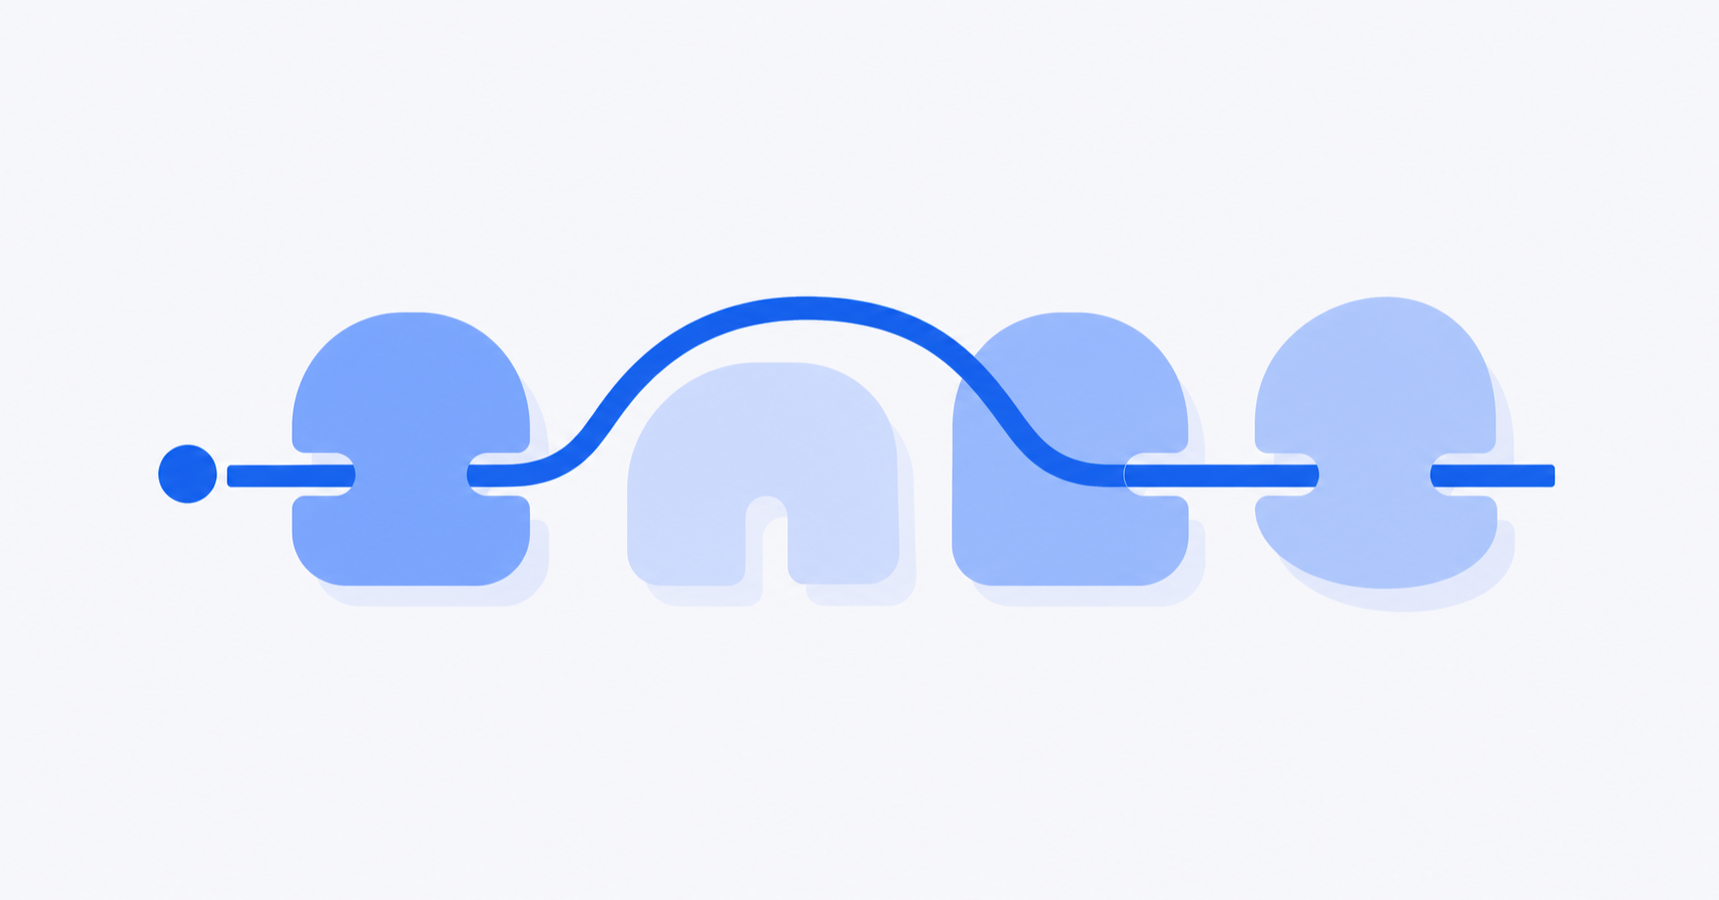
Коли запит до DeepSeek V4 Flash надходить до AIHubMix, шлюз обирає придатний канал провайдера. Якщо цей канал повертає помилку, яку можна повторити, до початку відповіді, AIHubMix може спробувати інший доступний канал для тієї самої моделі.
Шлях запиту може виглядати так:
- Спробувати DeepSeek V4 Flash через Провайдера A.
- Провайдер A повертає тайм-аут, помилку 5xx або помилку місткості, яку можна повторити.
- Спробувати ту саму модель DeepSeek V4 Flash через Провайдера B.
- Продовжувати, доки запит не буде успішним або доки не буде вичерпано всі придатні канали.
Клієнту не потрібно інтегрувати кілька SDK провайдерів, керувати окремими API-ключами або реалізовувати власну логіку повторів.
Це failover на рівні провайдера: змінюється провайдер, а запитувана модель залишається тією самою.
Рівень 2: Резервна модель
Failover провайдера не допоможе, якщо всі доступні провайдери для основної моделі недоступні.
Тому AIHubMix підтримує другий рівень надійності: резервну модель.
Користувачі можуть налаштувати впорядкований список резервних моделей для кожного API-ключа. Після того як усі придатні канали для основної моделі повернули помилку, яку можна повторити, AIHubMix переходить до наступної моделі у списку резервних.
Наприклад:
- Основна:
deepseek-v4-flash - Перша резервна:
gpt-5.4 - Друга резервна:
gemini-3.1-pro-preview
Резервне перемикання виконується всередині шлюзу AIHubMix. Чинним застосункам не потрібно надсилати додаткові параметри маршрутизації або змінювати код клієнта.
Оплата базується на моделі, яка зрештою повернула успішну відповідь. Розробники можуть перевірити поведінку резервного перемикання через заголовки відповіді:
X-Aihubmix-Fallback: trueX-Aihubmix-Model: <final-model>
Повна конфігурація та правила спрацювання описані в AIHubMix Model Mapping and Fallback.
Що може обробити автоматичний failover
Failover провайдера призначений для відновлення після проблем upstream-інфраструктури, таких як:
- Тайм-аути провайдера
- Збої з’єднання
- Відповіді 5xx, які можна повторити
- Ліміти запитів провайдера та помилки місткості
- Тимчасова недоступність upstream-каналу
Коли ці збої виникають до початку відповіді, AIHubMix може прозоро спробувати інший маршрут.
Що failover не може вирішити
Маршрутизація через кількох провайдерів підвищує доступність, але не робить шлюз безпомилковим.
Резервне перемикання не спрацьовує, коли:
- API-ключ користувача AIHubMix недійсний, прострочений або вичерпав квоту
- Сам запит некоректний
- Клієнт роз’єднався або досяг власного тайм-ауту
- Потокова відповідь уже почалася
- Конкретний канал провайдера було явно вибрано
- Збій охоплює всіх провайдерів або сам шлюз
Відмови провайдерів також можуть бути скорельованими. Кілька провайдерів можуть залежати від тієї самої базової інфраструктури, релізу моделі або регіональної мережі. Тому доступність через кількох провайдерів слід вимірювати на реальному трафіку, а не припускати лише з кількості провайдерів.
Чому агрегатор може бути надійнішим за пряму кінцеву точку
Прямий виклик офіційного API дає застосунку один маршрут до моделі.
Багатопровайдерний шлюз дає їх кілька.
Якщо ці маршрути провайдерів виходять з ладу незалежно один від одного, шлюз може обійти деградовану кінцеву точку, не передаючи збій застосунку. Це знижує залежність від будь-якого окремого провайдера і може забезпечити вищу доступність, ніж пряма інтеграція з одним провайдером.
Різниця архітектурна:
- Прямий API: одна модель, один провайдер, один домен відмови
- AIHubMix: одна модель, кілька провайдерів, автоматичний failover
- AIHubMix з резервною моделлю: кілька провайдерів плюс резервні моделі
Мета не в тому, щоб передбачити, який провайдер вийде з ладу наступним. Вона в тому, щоб перетворити інцидент в upstream-сервісі на внутрішню подію маршрутизації, а не на відмову, помітну для клієнта.
Готовність до наступного інциденту у провайдера
DeepSeek V4 Flash відновився, але тимчасові обмеження місткості, ліміти запитів і збої upstream-сервісів є звичайними частинами продуктивної AI-інфраструктури.
Застосункам не слід змінювати код щоразу, коли провайдер стає нестабільним.
Через AIHubMix розробники можуть отримати доступ до кількох провайдерів через один API, автоматично повторювати запит до тієї самої моделі через доступні канали та налаштувати резервні моделі для додаткового рівня захисту.
Переглянути доступні моделі та провайдерів можна на aihubmix.com/models.
Поширені запитання
Що таке мультипровайдерний failover?
Він автоматично повторює запит до тієї самої моделі через інший придатний провайдер, коли поточний маршрут повертає помилку, яку можна повторити.
Чим відрізняється резервна модель?
Failover провайдера зберігає модель незмінною. Резервна модель перемикається на налаштовану резервну лише після того, як усі придатні канали для основної моделі відмовили.
Які збої можуть запустити failover?
Типові причини включають тайм-аути, збої з’єднання, відповіді 5xx, які можна повторити, ліміти запитів і тимчасові помилки місткості до початку відповіді.
Чи гарантує failover відсутність простоїв?
Ні. Скорельовані збої провайдерів, інциденти на рівні шлюзу, помилки, які не можна повторити, і збої після початку потокової передачі все одно можуть дійти до клієнта.
Чи потрібно змінювати код застосунку?
Додаткова логіка маршрутизації не потрібна. Застосунки продовжують використовувати сумісну з OpenAI кінцеву точку AIHubMix, а резервні моделі можна налаштувати на рівні API-ключа.