AIHubMix эксплуатирует собственную глобальную сеть ускорения для трафика API. После оценки сторонних провайдеров ускорения, которые показали недостаточную задержку и стабильность для производственных AI-нагрузок, мы развернули собственные периферийные узлы, систему мониторинга и механизм распределения трафика. В этой статье описаны измеренные результаты и архитектура, которая за ними стоит.
Измеренные результаты
Приведённые ниже показатели получены в ходе непрерывного мониторинга в производственной среде после итераций алгоритма планирования.
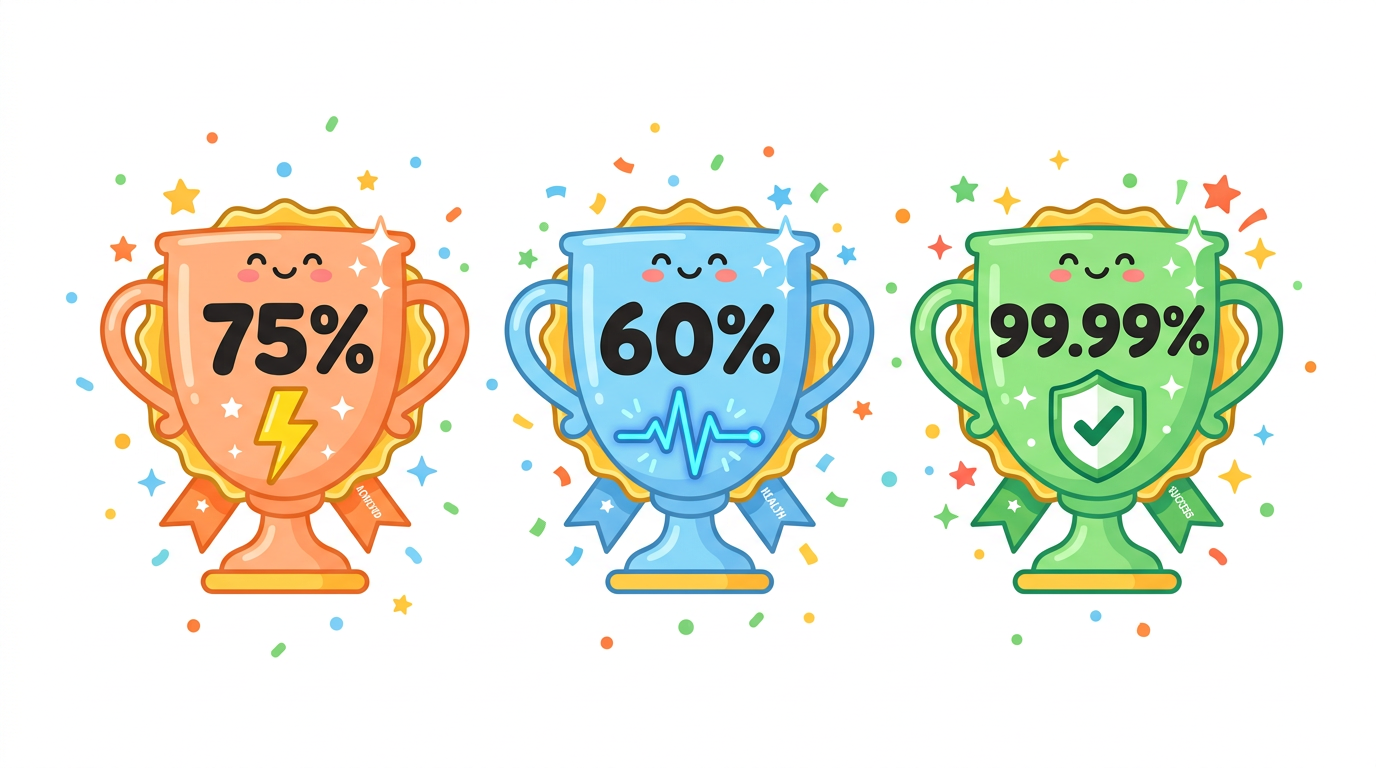
Время отклика снижено на 75%
Сквозная задержка API в среднем снизилась на 75%. В потоковых сценариях это в первую очередь улучшает время до первого токена (TTFT), то есть интервал между отправкой запроса и получением первого выходного токена, который определяет, насколько быстро чат-приложение реагирует на действия пользователя.
Колебания задержки снижены на 60%
Разброс задержки от запроса к запросу уменьшился на 60%. Стабильная задержка важна для производственных приложений: она делает время ответа, видимое пользователю, предсказуемым и снижает количество таймаутов из-за задержек на хвосте распределения.
Доступность сервиса 99,99%
Доступность, измеренная на производственном трафике, достигает 99,99%. Это измеренный показатель, охватывающий все часы работы, включая выходные и праздничные дни.
Архитектура
Собственные периферийные узлы
Сеть работает на выделенных узлах ускорения, развёрнутых в нескольких регионах и не зависящих от какой-либо отдельной линии связи или облачного провайдера. Каждый узел проходит проверку по задержке, потерям пакетов и пиковой нагрузке перед вводом в эксплуатацию; узлы, не соответствующие пороговым значениям, исключаются из пула. Маршрутизация выбирает самый быстрый доступный путь для каждого API-вызова.
Мониторинг состояния с проверками каждую минуту
Распределённые зонды в нескольких регионах каждую минуту выполняют сквозную проверку работоспособности каждого узла по трём параметрам: задержка, доля успешных запросов и стабильность. Вся сеть сканируется каждые 60 секунд, поэтому аномалии узлов обнаруживаются в пределах одного цикла проверки.
Распределение трафика с автоматическим переключением при сбое
Система распределения каждую минуту пересчитывает оценку работоспособности для каждого узла на основе данных зондов за четыре скользящих окна: 1 минута, 5 минут, 15 минут и 1 час. Трафик направляется на узел с лучшей текущей оценкой. Когда узел деградирует, переключение на работоспособный узел занимает миллисекунды и не требует вмешательства человека.
Автоматизированные операции
Управление узлами, оптимизация маршрутов, развёртывание конфигураций, ротация сертификатов и восстановление после сбоев полностью автоматизированы. Устранение инцидентов не зависит от времени реакции дежурной смены: деградировавшие узлы выводятся из ротации системой распределения, как только зонды фиксируют аномалию.
Что это означает для вашего приложения
- Более низкое и стабильное TTFT в потоковых ответах.
- Меньше ошибок таймаута и всплесков задержки на хвосте распределения под нагрузкой.
- Никаких изменений в интеграции: ускорение применяется к стандартным конечным точкам API автоматически.
FAQ
Нужно ли менять интеграцию, чтобы воспользоваться сетью ускорения?
Нет. Ускорение применяется на уровне входа в платформу. Существующие конечные точки API, ключи и форматы запросов работают без изменений.
Как часто проверяется работоспособность узлов?
Распределённые зонды сканируют каждый узел сети каждые 60 секунд, измеряя задержку, долю успешных запросов и стабильность от начала до конца.
Что происходит, когда узел деградирует?
Система распределения каждую минуту пересчитывает оценки работоспособности по четырём скользящим окнам (1 минута, 5 минут, 15 минут, 1 час) и автоматически переводит трафик на работоспособные узлы. Переключение занимает миллисекунды.
Последнее обновление: 2026-06-01