Podłączenie LLM wystarcza, by aplikacja generowała tekst. Nie wystarcza jednak, by agent AI wykonał rzeczywiste zadanie.
Jeśli poprosisz model o podsumowanie dokumentu, który już znajduje się w jego kontekście, sama warstwa modelu wystarczy. Gdy jednak poprosisz go o porównanie dzisiejszych cen konkurencji, wzbogacenie rekordu firmy, sprawdzenie konta w mediach społecznościowych albo wybór najlepszego API do nieznanego zadania, brakująca połowa staje się oczywista: agent potrzebuje niezawodnego sposobu, by połączyć się z systemami zewnętrznymi.
Produkcyjny agent podejmuje zatem dwie odrębne decyzje:
- Który model powinien obsłużyć ten krok?
- Które narzędzie lub API powinno dostarczyć dane albo wykonać działanie?
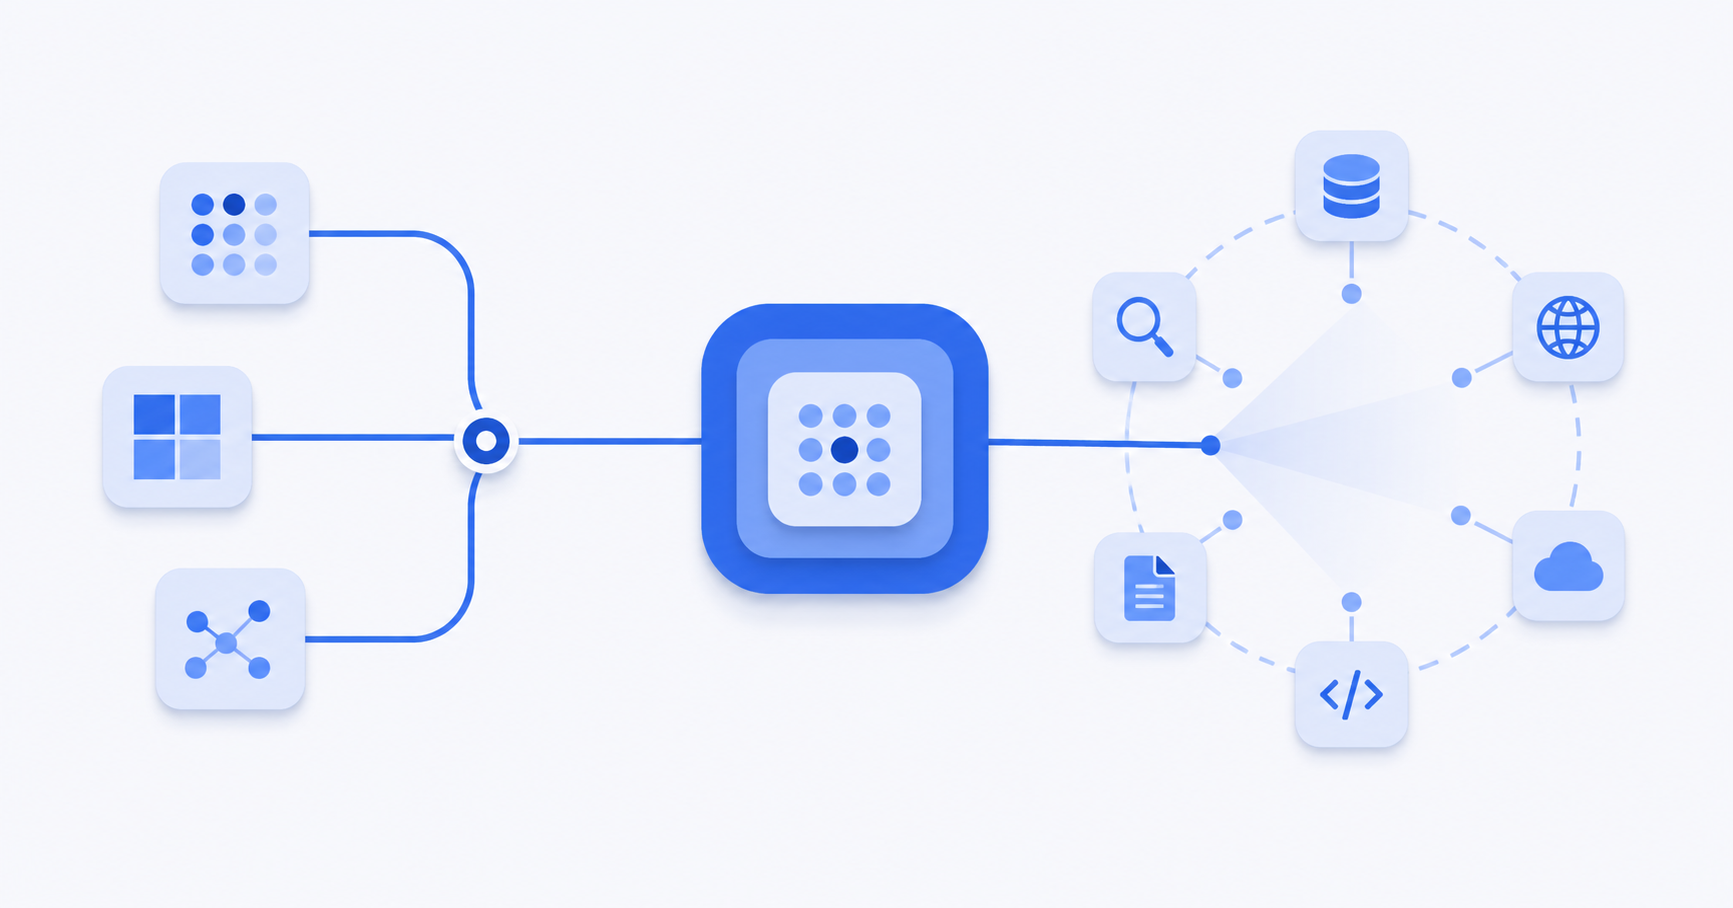
AIHubMix odpowiada na pierwsze pytanie dzięki zunifikowanemu dostępowi do modeli i routingowi modeli w momencie żądania. Monid odpowiada na drugie dzięki wykrywaniu narzędzi w czasie działania, inspekcji schematów i wykonywaniu wywołań płatnych za każde użycie. Produkty działają na różnych warstwach tej samej architektury.
Ujawnienie: Ten artykuł powstał w ramach współpracy redakcyjnej z Monid. AIHubMix to platforma modeli omawiana poniżej, a Monid to platforma narzędzi. Każdą z nich można używać niezależnie.
Dwa problemy routingu wewnątrz agenta AI
Uruchomienie agenta rzadko oznacza jedno jednorodne wywołanie modelu. Agent badawczy może sklasyfikować zapytanie, wyszukać aktualne informacje, wyodrębnić ustrukturyzowane fakty, porównać wyniki i napisać końcową odpowiedź. Każdy z tych kroków wymaga innych możliwości.
To samo dotyczy części poza modelem. Zadanie researchu firmy może wymagać dziś API wyszukiwania, jutro endpointu wzbogacania danych o firmie, a w przyszłym tygodniu narzędzia do automatyzacji przeglądarki. Jeśli każdy model i narzędzie są wpisane na sztywno na etapie budowania, każde nowe zadanie staje się projektem integracyjnym.
Obie warstwy są równoległe:
| Warstwa modelu | Warstwa narzędzi | |
|---|---|---|
| Kluczowa decyzja | Który model powinien odpowiedzieć? | Które API powinno zostać wywołane? |
| Moment wyboru | Dla każdego żądania | Dla każdego zadania, w czasie działania |
| Wejście | Prompt, modalność, wymagania jakości i opóźnienia | Cel, wymagane dane lub działanie, schemat i cena |
| Wyjście | Odpowiedź modelu | Dane zewnętrzne lub wykonana akcja |
| Przykład | AIHubMix | Monid |
To rozdzielenie ma znaczenie. Lepszy model nie zapewni dostępu do danych na żywo, a większy katalog narzędzi nie zrozumie danych, które zwraca. Agent potrzebuje obu możliwości, z jasnym kontraktem między nimi.
Monid przedstawia komplementarny, narzędziowy punkt widzenia w artykule Why an AI Agent Needs Two Integrations. Z perspektywy modelu wniosek architektoniczny jest ten sam: utrzymuj wybór modelu i wybór narzędzia niezależnie, a następnie optymalizuj każdą warstwę pod jej własne zadanie.
Dlaczego jeden stały model staje się drogi w pętli agenta
Używanie jednego modelu do wszystkiego wygląda prosto. W praktyce zmusza jednak każdy krok do przyjęcia tego samego kompromisu między możliwościami, opóźnieniem i ceną.
Rozważmy agenta do badania rynku:
- Klasyfikacja intencji jest krótka i mechaniczna.
- Wybór narzędzi wymaga niezawodnego wykonywania instrukcji.
- Wyodrębnianie pól z zwróconego JSON to przede wszystkim transformacja.
- Końcowy raport może wymagać silniejszego rozumowania i lepszego pisania.
Wysyłanie wszystkich czterech kroków do najbardziej zdolnego modelu marnuje pieniądze na rutynową pracę. Wysyłanie wszystkich czterech do najtańszego modelu może obniżyć jakość jedynego wyniku, który czyta użytkownik. Wraz z rozrastaniem się pętli agenta ten kompromis powtarza się przy każdym wywołaniu.
AIHubMix udostępnia endpoint kompatybilny z OpenAI dla szerokiego katalogu modeli. Istniejąca integracja z OpenAI SDK może wskazywać na AIHubMix po zmianie klucza API i base_url:
from openai import OpenAI

client = OpenAI(
    api_key="<AIHUBMIX_API_KEY>",
    base_url="https://aihubmix.com/v1",
)

response = client.chat.completions.create(
    model="auto:balanced",
    messages=[
        {"role": "user", "content": "Classify this request and propose the next step."}
    ],
)
Ustawienie model na auto przenosi wybór modelu do ścieżki żądania. Router analizuje zadanie i wskazuje odpowiedni model. Sufiks polityki jawnie określa cel optymalizacji:
| Wartość routera | Priorytet | Typowy krok agenta |
|---|---|---|
auto |
Najpierw koszt | Zadania wsadowe i rutynowe transformacje |
auto:balanced |
Możliwości, koszt i opóźnienie | Ogólna praca agenta |
auto:quality_first |
Najpierw możliwości | Złożone rozumowanie i końcowe wyniki |
auto:latency_critical |
Najpierw szybkość | Interaktywne pętle i lekkie planowanie |
Routing nie wiąże się z osobną opłatą. Żądanie jest rozliczane według cennika modelu, który faktycznie je obsłużył. Rozstrzygnięty model i szczegóły routingu są widoczne w odpowiedzi, w tym w nagłówku X-Aihubmix-Router-Resolved-Model, dzięki czemu decyzja pozostaje obserwowalna, a nie staje się czarną skrzynką.
Pełne zachowanie, obsługiwane endpointy, polityki i obecne ograniczenia są opisane w przewodniku AIHubMix LLM Router.
Routing modeli nie daje agentowi danych na żywo
Po skonfigurowaniu routingu modeli agent może wybrać lepszy „mózg” dla każdego kroku. Nadal nie będzie jednak wiedział, co zmieniło się po danych treningowych modelu, nie uzyska dostępu do prywatnego systemu biznesowego ani nie wykona działania w innej aplikacji, dopóki narzędzie nie zapewni tej możliwości.
W tym miejscu wiele projektów agentowych gromadzi kruchy kod. Zespół podłącza jedno API wyszukiwania, potem API do scrapingu, a następnie API do wzbogacania danych. Każda integracja wprowadza kolejne konto, poświadczenia, format żądań, model błędów i relację rozliczeniową. Opisy narzędzi są często kopiowane do system promptu i powoli się dezaktualizują.
Tryb awarii jest niebezpieczny, bo może wyglądać na sukces. Model może wygenerować wiarygodne wywołanie przeciwko przestarzałemu schematowi, otrzymać niepełną odpowiedź i kontynuować tak, jakby zadanie się udało. Inspekcja schematu w czasie działania jest bezpieczniejsza niż proszenie modelu, by pamiętał kontrakt API z treningu lub ze starego promptu.
Warstwa narzędzi powinna zatem odpowiedzieć na trzy pytania przed wykonaniem:
- Które narzędzie może zrealizować ten cel?
- Jaki schemat i cena obowiązują teraz?
- Jaki wynik faktycznie zwróciło wywołanie?
Wykrywanie narzędzi to druga warstwa routingu
Monid zamienia dostęp do narzędzi w przepływ pracy odkrywanie-inspekcja-uruchomienie. Zamiast wymagać od dewelopera przewidzenia każdego API, którego agent może potrzebować, agent może przeszukać katalog w języku naturalnym, sprawdzić kontrakt kandydata i wykonać wybrany endpoint.
Podstawowy przepływ wygląda następująco:
# 1. Find tools that match the goal
monid discover -q "find current product pricing from a public web page"

# 2. Read the selected endpoint's schema and pricing
monid inspect -p PROVIDER_SLUG -e ENDPOINT_PATH

# 3. Execute only after the agent has checked the contract
monid run -p PROVIDER_SLUG -e ENDPOINT_PATH \
  --query '{"url":"https://example.com/product"}'
Wykrywanie i inspekcja pozwalają agentowi porównać opcje, zanim cokolwiek wyda. Wykonanie jest rozliczane zgodnie z modelem cenowym wybranego endpointu. Deweloper utrzymuje jedną integrację, a agent zyskuje dostęp do narzędzi wielu dostawców.
Dla środowisk agentowych, które potrafią odczytać instrukcje konfiguracji, Monid publikuje też maszynowo czytelną umiejętność:
Set up https://monid.ai/SKILL.md
Dokumentacja przepływu pracy Monid szczegółowo wyjaśnia etapy katalogu, inspekcji i wykonania.
Jak obie warstwy współpracują
Brama modeli i warstwa narzędzi powinny pozostać oddzielnymi komponentami z niewielkim, jawnym punktem przekazania:
- Agent otrzymuje cel użytkownika.
- AIHubMix kieruje wywołanie planowania do odpowiedniego modelu.
- Plan wskazuje brakujące informacje lub wymagane działanie zewnętrzne.
- Monid wykrywa kandydackie narzędzia i udostępnia ich schematy oraz ceny.
- Agent wybiera i uruchamia narzędzie w ramach swoich uprawnień i budżetu.
- Narzędzie zwraca fakty lub wynik działania.
- AIHubMix kieruje wywołanie syntezy zgodnie z wymaganą jakością, kosztem lub opóźnieniem.
- Agent zwraca odpowiedź opartą na wyniku narzędzia.
W uproszczonym Pythonie wywołania po stronie modelu mogą pozostać bez zmian, a wynik narzędzia jest wstawiany jako kontekst:
from openai import OpenAI

client = OpenAI(
    api_key="<AIHUBMIX_API_KEY>",
    base_url="https://aihubmix.com/v1",
)

# A fast model is sufficient for a lightweight planning step.
plan = client.chat.completions.create(
    model="auto:latency_critical",
    messages=[
        {
            "role": "user",
            "content": "Plan how to compare the current prices of these products.",
        }
    ],
)

# Your agent uses Monid to discover, inspect, and run an appropriate tool.
# Replace these placeholders with the structured result returned by that call.
tool_result = {
    "source": "<source-url>",
    "data": "<structured-tool-result>",
}

report = client.chat.completions.create(
    model="auto:quality_first",
    messages=[
        {
            "role": "system",
            "content": (
                "Write a concise comparison. Use only the supplied tool result, "
                "preserve source URLs, and state when a value is missing."
            ),
        },
        {"role": "user", "content": str(tool_result)},
    ],
)
Ważny jest nie liczba linii kodu, lecz to, że żaden z tych wyborów nie musi być na stałe osadzony w logice aplikacji. Model może się zmieniać wraz z promptem, a narzędzie wraz z zadaniem.
Kontrolę kosztów trzeba prowadzić na obu warstwach
Koszty modeli i narzędzi używają różnych jednostek, dlatego należy mierzyć je osobno.
Na warstwie modelu rozstrzygnięty model określa cenę za tokeny. AIHubMix sprawia, że ta decyzja jest możliwa do prześledzenia, i pozwala deweloperom wybrać politykę routingu lub ograniczyć modele, do których klucz API ma dostęp. Rutynowe kroki mogą faworyzować koszt lub opóźnienie, a wyniki widoczne dla użytkownika jakość.
Na warstwie narzędzi endpoint może pobierać opłatę za wywołanie lub za wynik. Monid pokazuje ceny podczas inspekcji, przed wykonaniem. Agent może odrzucić endpoint przekraczający budżet, preferować zweryfikowaną opcję albo poprosić o zatwierdzenie przed wyjątkowo kosztowną operacją.
Przydatne produkcyjne mechanizmy kontroli obejmują:
- Listę dozwolonych modeli lub limit ceny dla każdego klucza API.
- Maksymalny budżet wywołań narzędzi na zadanie.
- Listy dozwolonych dostawców lub endpointów dla danych regulowanych.
- Logi łączące decyzję o routingu modelu z wywołaniem narzędzia i końcową odpowiedzią.
- Wyraźne potwierdzenie przed nieodwracalnymi lub wrażliwymi działaniami.
- Walidację wyników, dzięki której dane z narzędzi są traktowane jako niezaufane wejście, a nie jako instrukcje.
Taki podział ułatwia też debugowanie kosztów. Jeśli uruchomienie staje się drogie, logi tokenów pokazują, czy agent zbyt dużo rozumował, a logi narzędzi, czy zbyt dużo pobrał. Rozwiązania są różne, a architektura powinna zachować to rozróżnienie.
Niezawodność wymaga świeżych kontraktów i widocznych decyzji
Dynamiczny wybór nie powinien oznaczać nieprzewidywalnego zachowania.
Po stronie modelu AIHubMix raportuje rozstrzygnięty model i politykę routingu dla każdego żądania. Przyklejanie sesji (session stickiness) może zachować spójność modelu i korzyści z pamięci podręcznej promptów w wieloetapowej pracy, a mechanizm awaryjny może w razie potrzeby przenieść żądanie z niesprawnego modelu.
Po stronie narzędzi agent sprawdza aktualny schemat endpointu przed płatnym wywołaniem. Wyniki wykrywania zawierają informacje potrzebne do porównania kandydatów, a wynik rzeczywistego wywołania staje się jedynym zewnętrznym dowodem przekazywanym do końcowego wygenerowania odpowiedzi.
Razem te mechanizmy tworzą użyteczny ślad audytu:
user goal
  -> routing decision and resolved model
  -> discovered tool candidates
  -> inspected schema and price
  -> selected endpoint and result
  -> final model decision and grounded response
Ten ślad jest cenniejszy niż sam dostęp do wielu modeli czy wielu API. Wyjaśnia, dlaczego agent dokonał każdego wyboru i jakie dowody uzasadniły jego odpowiedź.
Kiedy nie potrzebujesz obu warstw
Nie każdy przepływ pracy korzysta z wyboru w czasie działania.
Jeśli aplikacja wysyła jeden stały prompt do jednego sprawdzonego modelu, bezpośrednie wskazanie tego modelu jest prostsze i bardziej deterministyczne niż routing. Jeśli zaplanowany potok zawsze wywołuje jedno znane API, bezpośrednia integracja z tym API może być czytelniejsza niż dodawanie warstwy wykrywania.
Architektura dwuwarstwowa zyskuje sens wtedy, gdy zmienność jest częścią obciążenia:
- Prompty różnią się na tyle, że najlepszy model zmienia się w zależności od kroku.
- Agenci wykonują wiele wywołań modeli i muszą kontrolować łączny koszt lub opóźnienie.
- Wymaganych narzędzi nie da się w pełni przewidzieć na etapie budowania.
- Dane zewnętrzne muszą być aktualne, a ich źródło musi być widoczne.
- Zespół chce dodawać nowe możliwości bez osobnej integracji z nowym dostawcą dla każdej z nich.
Warstwę modeli, warstwę narzędzi lub obie użyj zgodnie z decyzjami, które Twoja aplikacja faktycznie musi podejmować.
Buduj agenta wokół decyzji, a nie zależności
Produkcyjnego agenta AI nie określa liczba modeli ani API, do których ma dostęp. Określa go to, czy potrafi wybrać odpowiednią możliwość dla bieżącego kroku, działać w ramach budżetu i wyjaśnić, co się wydarzyło.
AIHubMix daje agentowi ujednolicony endpoint modeli oraz routing w czasie żądania, uwzględniający priorytety kosztu, jakości i opóźnienia. Monid zapewnia odkrywanie narzędzi w czasie działania, aktualne schematy, widoczne ceny oraz wykonywanie w zewnętrznych dostawcach.
Jedna warstwa decyduje, jak agent myśli. Druga decyduje, jak agent sprawdza informacje i działa. Utrzymanie tych decyzji osobno daje agenta, który łatwiej rozbudować, obserwować i kontrolować.
Zacznij od szybkiego startu z AIHubMix, a następnie podłącz część narzędziową przez Monid.
FAQ
Czym jest routing modeli dla agentów AI?
Routing modeli wybiera model dla każdego żądania na podstawie czynników takich jak typ zadania, możliwości, koszt i opóźnienie. W AIHubMix ustawienie model na auto lub na politykę, na przykład auto:quality_first, włącza wybór w czasie żądania przy zachowaniu kompatybilnego z OpenAI API.
Dlaczego agent AI potrzebuje narzędzi, skoro LLM ma już wiedzę?
LLM generuje odpowiedzi na podstawie kontekstu, który otrzymuje, oraz tego, czego nauczył się podczas treningu. Bez podłączonego narzędzia nie może niezawodnie znać aktualnych cen, odpytać prywatnej bazy danych ani wykonać zewnętrznej akcji. Narzędzia dostarczają dane na żywo i wykonują działania; model planuje i interpretuje wynik.
Czy brama modeli to to samo co serwer MCP lub platforma narzędzi?
Nie. Brama modeli kieruje żądania wnioskowania do modeli. Serwery MCP i platformy narzędzi udostępniają agentowi zewnętrzne możliwości. Rozwiązują komplementarne problemy integracji i mogą być używane razem.
Czy AIHubMix i Monid można używać niezależnie?
Tak. AIHubMix może kierować wywołania modeli w aplikacjach bez dynamicznych wymagań dotyczących narzędzi. Monid może zapewnić agentom odkrywanie narzędzi, gdy korzystają z innego dostawcy modeli lub innej bramy. Użycie obu jest przydatne, gdy agent potrzebuje wyboru w czasie działania na obu warstwach.
Jak mogę zapewnić, że automatyczny routing będzie możliwy do audytu?
Zapisuj dla każdego zadania rozwiązany model, politykę routingu, kandydata narzędzia, sprawdzoną cenę, wybrany endpoint i zwrócony wynik. AIHubMix udostępnia szczegóły routingu modelu w odpowiedzi, a Monid oddziela odkrywanie i sprawdzanie od wykonania, dzięki czemu decyzję o narzędziu można zarejestrować przed płatnym wywołaniem.