4 sierpnia 2026 roku oficjalna strona statusu DeepSeek zarejestrowała dwa incydenty związane z pogorszeniem wydajności API.
Pierwszy incydent trwał 1 godzinę i 18 minut, od 02:02 do 03:20 UTC, i dotyczył DeepSeek V4 Flash, V4 Pro oraz trybu Expert. Drugi incydent trwał 36 minut, od 03:43 do 04:20 UTC, i dotyczył API DeepSeek V4 Flash.
Oba incydenty zostały już rozwiązane. OpenCode poinformowało również, że DeepSeek Flash miał problemy z pojemnością z powodu bezprecedensowego popytu. Oficjalna strona statusu DeepSeek potwierdziła jedynie pogorszenie wydajności i nie podała przyczyny źródłowej.
TL;DR
- Oficjalna strona statusu DeepSeek zarejestrowała 4 sierpnia 2026 roku dwa incydenty pogorszenia wydajności, dotyczące V4 Flash.
- Bezpośrednia integracja z jednym dostawcą tworzy pojedynczy punkt awarii, nawet jeśli ten sam model jest dostępny gdzie indziej.
- AIHubMix może ponowić żądanie do tego samego modelu w wielu kanałach dostawców, gdy trasa upstream zwróci błąd, który można ponowić.
- Jeśli wszystkie kanały dostawców dla modelu podstawowego zawiodą, fallback modelu na poziomie klucza może przekierować żądanie na skonfigurowane modele zapasowe.
- Routing wielu dostawców zmniejsza zależność od jednego punktu końcowego, ale nie może wyeliminować skorelowanych awarii ani ryzyka na poziomie bramy.
Incydenty takie jak ten podkreślają ważną zasadę infrastruktury:
Niezawodny model nie wystarcza, jeśli jest dostępny tylko przez jeden punkt końcowy dostawcy.
Jeden model nie musi oznaczać jednego dostawcy
Gdy aplikacja łączy się bezpośrednio z jednym dostawcą, jego punkt końcowy staje się pojedynczym punktem awarii.
Jeśli dostawca doświadczy przestoju, osiągnie limit żądań lub wystąpi skok opóźnień, aplikacja nie ma dokąd wysłać żądania. Użytkownicy widzą przekroczenia czasu i błędy, mimo że ten sam model pozostaje dostępny przez inną infrastrukturę dostawców.
AIHubMix oddziela model od dostawcy, który go obsługuje.
Na przykład DeepSeek V4 Flash jest dostępny na AIHubMix u wielu dostawców, w tym DeepSeek, Baidu, DeepInfra i Alibaba Cloud. Aplikacje nadal korzystają z jednego punktu końcowego API zgodnego z OpenAI, podczas gdy AIHubMix zarządza dostępnymi trasami upstream.
Tworzy to dwie odrębne warstwy niezawodności.
Warstwa 1: Failover dostawcy
Failover dostawcy zachowuje żądany model bez zmian, przełączając jedynie infrastrukturę dostawcy, która go obsługuje.
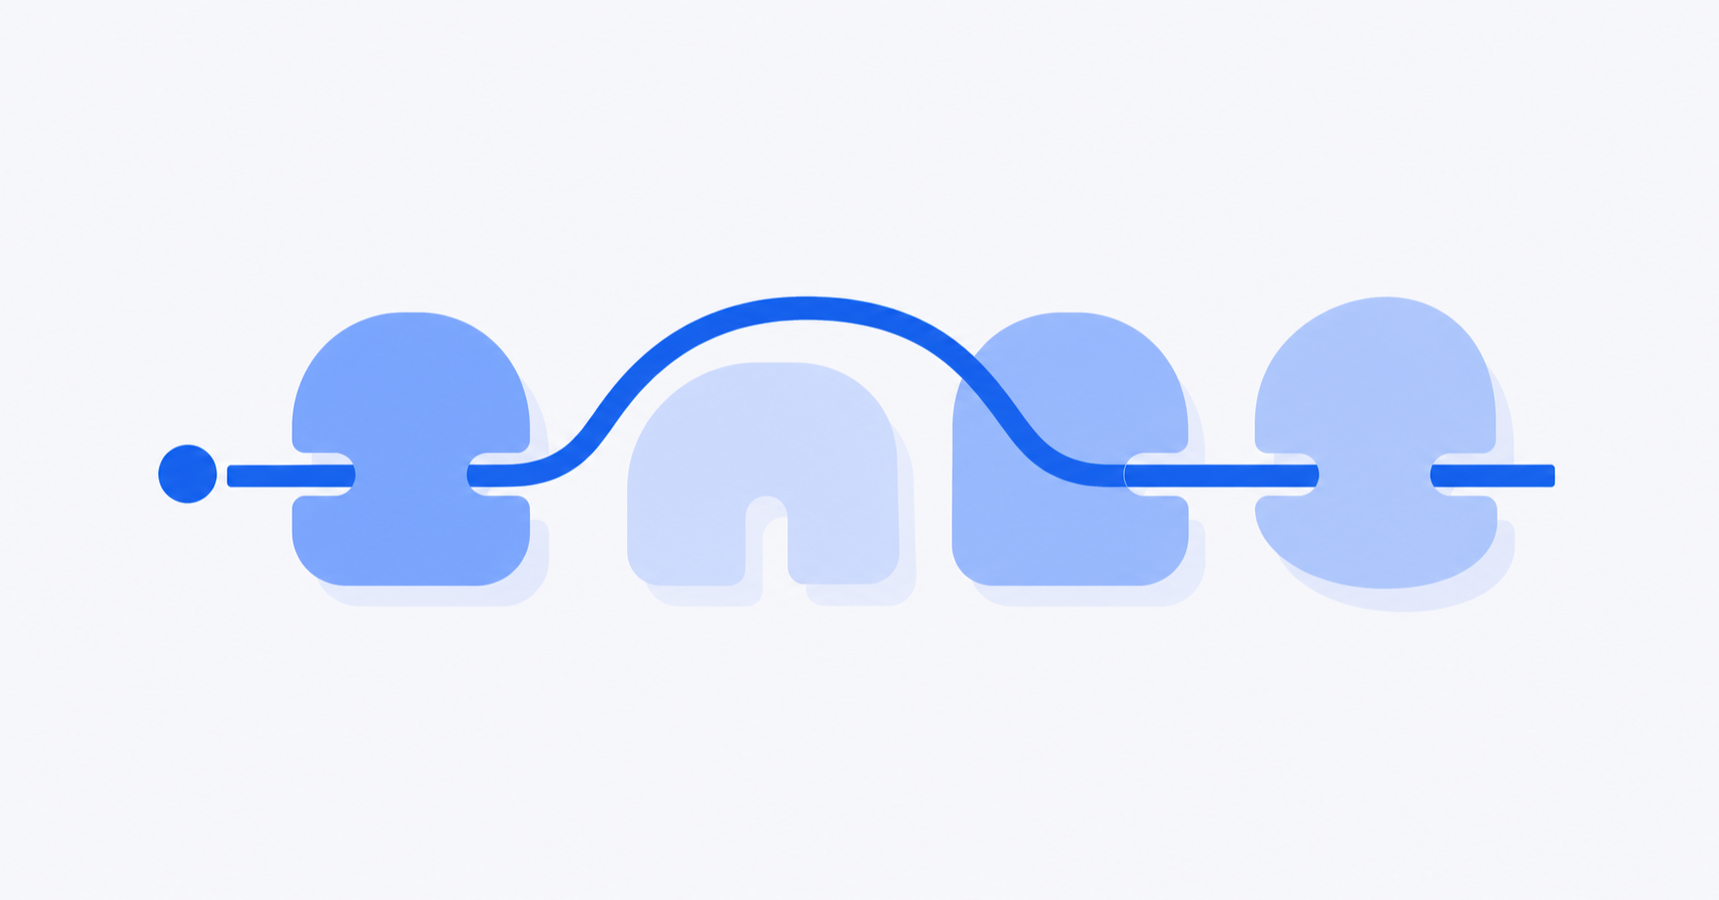
Gdy żądanie dla DeepSeek V4 Flash trafia do AIHubMix, brama wybiera uprawnionego dostawcę. Jeśli ten kanał zwróci błąd, który można ponowić, zanim odpowiedź się rozpocznie, AIHubMix może spróbować innego dostępnego kanału dla tego samego modelu.
Ścieżka żądania może wyglądać następująco:
- Wysłanie żądania do DeepSeek V4 Flash przez dostawcę A.
- Dostawca A zwraca przekroczenie czasu, błąd 5xx lub błąd pojemności, który można ponowić.
- Ponowne wysłanie żądania do tego samego modelu DeepSeek V4 Flash przez dostawcę B.
- Proces trwa, aż żądanie zakończy się sukcesem lub wyczerpie się wszystkie uprawnione kanały.
Klient nie musi integrować wielu SDK dostawców, zarządzać osobnymi kluczami API ani implementować własnej logiki ponawiania.
To failover na poziomie dostawcy: zmienia się dostawca, ale żądany model pozostaje ten sam.
Warstwa 2: Fallback modelu
Failover dostawcy nie pomoże, jeśli każdy dostępny dostawca dla modelu podstawowego jest niedostępny.
Dlatego AIHubMix oferuje drugą warstwę niezawodności: fallback modelu.
Użytkownicy mogą skonfigurować uporządkowaną listę modeli zapasowych dla każdego klucza API. Gdy każdy uprawniony kanał dla modelu podstawowego zwróci błąd, który można ponowić, AIHubMix przechodzi do kolejnego modelu z listy fallback.
Na przykład:
- Model podstawowy:
deepseek-v4-flash - Pierwszy fallback:
gpt-5.4 - Drugi fallback:
gemini-3.1-pro-preview
Fallback jest realizowany wewnątrz bramy AIHubMix. Istniejące aplikacje nie muszą wysyłać dodatkowych parametrów routingu ani zmieniać kodu klienta.
Rozliczenie opiera się na modelu, który ostatecznie zwrócił udaną odpowiedź. Deweloperzy mogą sprawdzić działanie fallbacku w nagłówkach odpowiedzi:
X-Aihubmix-Fallback: trueX-Aihubmix-Model: <final-model>
Pełna konfiguracja i reguły wyzwalania są opisane w dokumentacji AIHubMix Model Mapping and Fallback.
Co może obsłużyć automatyczny failover
Failover dostawcy został zaprojektowany, aby odzyskiwać sprawność po problemach z infrastrukturą upstream, takich jak:
- Przekroczenia czasu u dostawcy
- Błędy połączenia
- Odpowiedzi 5xx, które można ponowić
- Limity żądań dostawcy i błędy pojemności
- Tymczasowa niedostępność kanału upstream
Gdy takie błędy wystąpią przed rozpoczęciem odpowiedzi, AIHubMix może w sposób przezroczysty spróbować innej trasy.
Czego failover nie rozwiąże
Routing wielu dostawców poprawia dostępność, ale nie sprawia, że brama jest nieomylna.
Fallback nie zostanie uruchomiony, gdy:
- Klucz API AIHubMix użytkownika jest nieprawidłowy, wygasł lub wyczerpał limit
- Samo żądanie jest nieprawidłowe
- Klient się rozłączy lub osiągnie własny limit czasu
- Odpowiedź strumieniowa już się rozpoczęła
- Wybrano jawnie konkretny kanał dostawcy
- Awaria dotyczy wszystkich dostawców lub samej bramy
Awarie dostawców mogą być również skorelowane. Wielu dostawców może opierać się na tej samej bazowej infrastrukturze, wydaniu modelu lub regionalnej sieci. Z tego powodu dostępność wielu dostawców należy mierzyć na podstawie rzeczywistego ruchu, a nie zakładać ją wyłącznie na podstawie liczby dostawców.
Dlaczego agregator może być bardziej niezawodny niż bezpośredni punkt końcowy
Wywołanie oficjalnego API bezpośrednio daje aplikacji jedną trasę do modelu.
Brama obsługująca wielu dostawców daje ich kilka.
Jeśli te trasy dostawców zawodzą niezależnie, brama może ominąć zdegradowany punkt końcowy bez ujawniania awarii aplikacji. Zmniejsza to zależność od pojedynczego dostawcy i może zapewnić wyższą dostępność niż bezpośrednia integracja z jednym dostawcą.
Różnica leży w architekturze:
- Bezpośrednie API: jeden model, jeden dostawca, jedna domena awarii
- AIHubMix: jeden model, wielu dostawców, automatyczny failover
- AIHubMix z fallbackiem modelu: wielu dostawców oraz modele zapasowe
Celem nie jest przewidzenie, który dostawca zawiedzie jako następny. Chodzi o to, by incydent po stronie upstream stał się wewnętrznym zdarzeniem routingu, a nie awarią widoczną dla klienta.
Przygotowanie na kolejny incydent dostawcy
DeepSeek V4 Flash już odzyskał sprawność, ale tymczasowe ograniczenia pojemności, limity żądań i awarie upstream są normalną częścią produkcyjnej infrastruktury AI.
Aplikacje nie powinny musieć zmieniać kodu za każdym razem, gdy dostawca staje się niestabilny.
Dzięki AIHubMix deweloperzy mogą korzystać z wielu dostawców przez jedno API, automatycznie ponawiać żądania do tego samego modelu w dostępnych kanałach i skonfigurować modele zapasowe jako dodatkową warstwę ochrony.
Dostępne modele i dostawców znajdziesz na stronie aihubmix.com/models.
FAQ
Czym jest failover między wieloma dostawcami?
Automatycznie ponawia żądanie do tego samego modelu przez innego uprawnionego dostawcę, gdy obecna trasa zwróci błąd, który można ponowić.
Czym różni się fallback modelu?
Failover dostawcy zachowuje model bez zmian. Fallback modelu przełącza na skonfigurowany model zapasowy dopiero wtedy, gdy wszystkie uprawnione kanały dla modelu podstawowego zawiodą.
Jakie błędy mogą uruchomić failover?
Typowe wyzwalacze to przekroczenia czasu, błędy połączenia, odpowiedzi 5xx, które można ponowić, limity żądań i tymczasowe błędy pojemności przed rozpoczęciem odpowiedzi.
Czy failover gwarantuje brak przestojów?
Nie. Skorelowane awarie dostawców, incydenty na poziomie bramy, błędy, których nie można ponowić, oraz awarie po rozpoczęciu strumieniowania nadal mogą dotrzeć do klienta.
Czy muszę zmienić kod aplikacji?
Nie jest wymagana żadna dodatkowa logika routingu. Aplikacje nadal korzystają z punktu końcowego AIHubMix zgodnego z OpenAI, a modele zapasowe można skonfigurować na poziomie klucza API.