Een LLM aansluiten is genoeg om een applicatie tekst te laten genereren. Het is niet genoeg om een AI-agent een taak uit de praktijk te laten voltooien.
Vraag een model om een document samen te vatten dat al in zijn context staat, en de modellaag is voldoende. Vraag het om de concurrentieprijzen van vandaag te vergelijken, een bedrijfsrecord te verrijken, een social account te controleren of de beste API te kiezen voor een onbekende taak, en het ontbrekende deel wordt meteen duidelijk: de agent heeft een betrouwbare manier nodig om externe systemen te bereiken.
Een productie-agent neemt daarom twee afzonderlijke beslissingen:
- Welk model moet deze stap afhandelen?
- Welke tool of API moet de data of actie leveren?
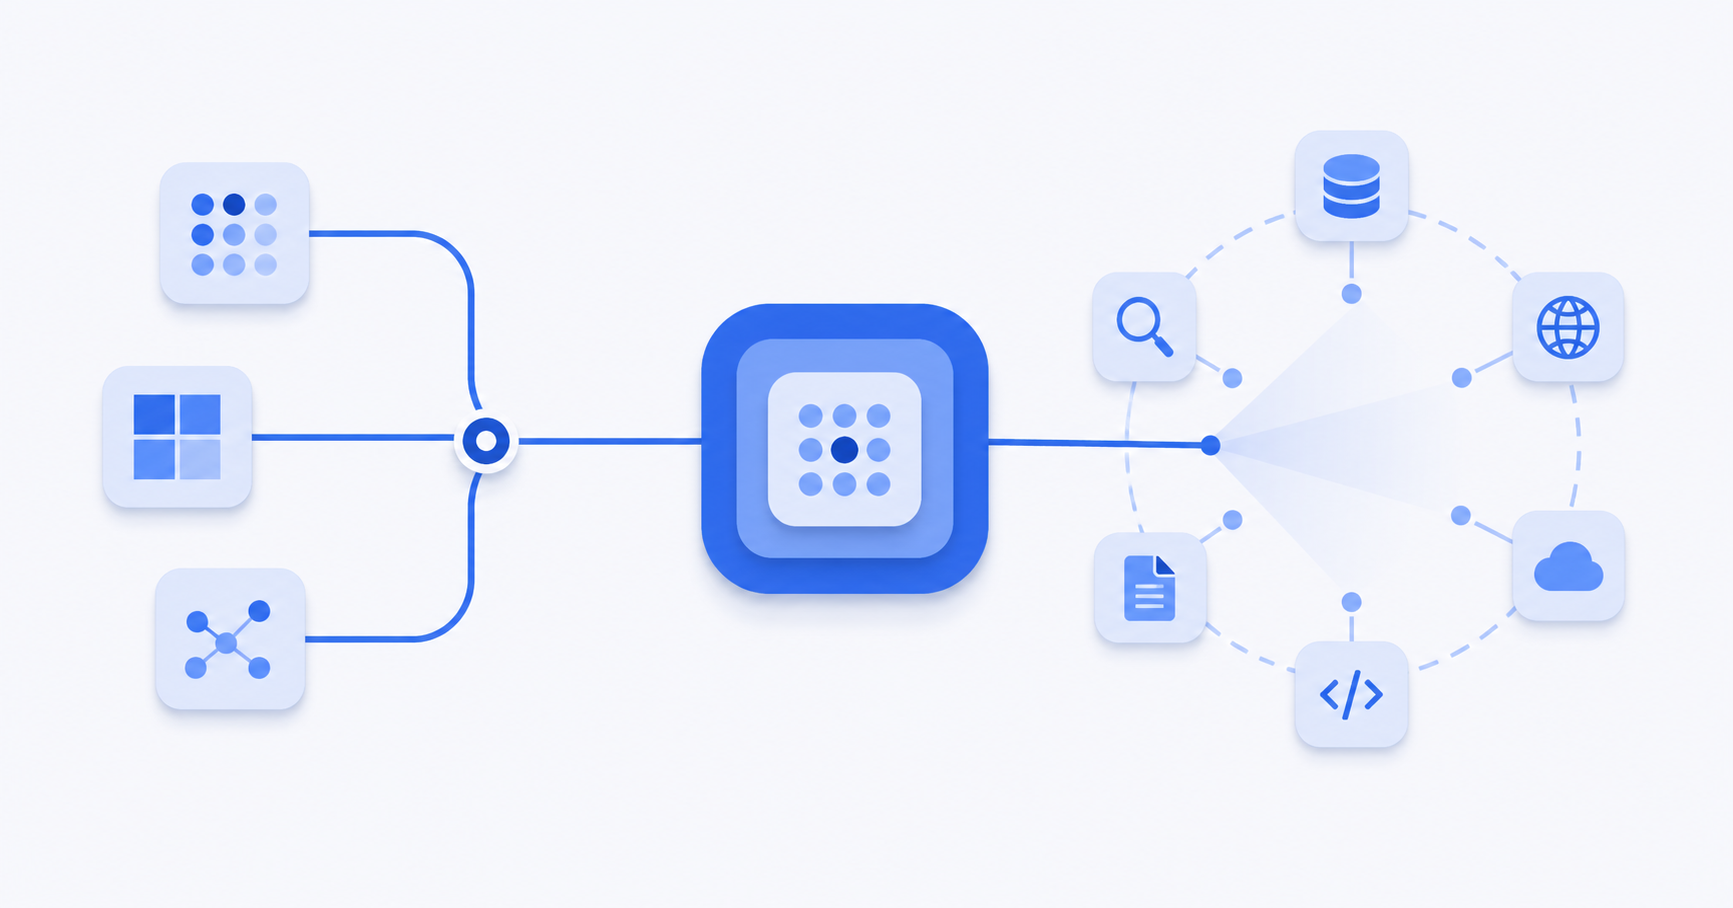
AIHubMix pakt de eerste beslissing aan met uniforme modeltoegang en routering van modellen op het moment van het verzoek. Monid pakt de tweede aan met tool-discovery tijdens runtime, schema-inspectie en betalen-per-aanroep-uitvoering. De producten zitten op verschillende lagen van dezelfde architectuur.
Openbaarmaking: Dit artikel is gemaakt als onderdeel van een contentsamenwerking met Monid. AIHubMix is het modelplatform dat hieronder wordt besproken; Monid is het toolplatform. Elk kan onafhankelijk van het andere worden gebruikt.
De twee routeringsproblemen binnen een AI-agent
Een agentrun bestaat zelden uit één homogene modelaanroep. Een onderzoeksagent kan een verzoek classificeren, actuele informatie zoeken, gestructureerde feiten extraheren, resultaten vergelijken en een definitief antwoord schrijven. Die stappen vereisen verschillende capaciteiten.
Buiten het model geldt hetzelfde. Een bedrijfsonderzoekstaak heeft misschien vandaag een zoek-API nodig, morgen een endpoint voor bedrijfsverrijking en volgende week een tool voor browserautomatisering. Als elk model en elke tool tijdens het bouwen hard is gecodeerd, wordt elke nieuwe taak een integratieproject.
De twee lagen zijn parallel:
| Modellaag | Toollaag | |
|---|---|---|
| Kernbeslissing | Welk model moet antwoorden? | Welke API moet worden aangeroepen? |
| Selectiemoment | Per verzoek | Per taak, tijdens runtime |
| Invoer | Prompt, modaliteit, kwaliteits- en latentiebehoeften | Doel, vereiste data of actie, schema en prijs |
| Uitvoer | Een modelcompletion | Externe data of een uitgevoerde actie |
| Voorbeeld | AIHubMix | Monid |
Deze scheiding is belangrijk. Een beter model kan geen toegang tot live data creëren, en een grotere toolcatalogus kan niet redeneren over de data die hij teruggeeft. De agent heeft beide mogelijkheden nodig, met een duidelijk contract ertussen.
Monid presenteert de aanvullende toolkant in Why an AI Agent Needs Two Integrations. Vanuit de modelkant is de architectuurles hetzelfde: houd modelselectie en toolselectie onafhankelijk van elkaar en optimaliseer vervolgens elke laag voor zijn eigen taak.
Waarom één vast model duur wordt in een agentloop
Eén model overal gebruiken lijkt eenvoudig. In de praktijk dwingt het elke stap om dezelfde afweging te accepteren tussen capaciteit, latentie en prijs.
Neem een marktonderzoeksagent als voorbeeld:
- Intentieclassificatie is kort en mechanisch.
- Toolselectie vereist betrouwbaar opvolgen van instructies.
- Het extraheren van velden uit teruggestuurde JSON is vooral transformatiewerk.
- Het eindrapport kan sterkere redenering en beter schrijfwerk vereisen.
Alle vier de stappen naar het meest capabele model sturen, verspilt geld aan routinewerk. Alle vier naar het goedkoopste model sturen, kan de kwaliteit verlagen van de enige uitvoer die de gebruiker leest. Naarmate een agentloop groeit, wordt die afweging bij elke aanroep herhaald.
AIHubMix biedt een OpenAI-compatibel endpoint over een breed modelcatalogus. Een bestaande OpenAI SDK-integratie kan naar AIHubMix wijzen door alleen de API-sleutel en base_url te wijzigen:
from openai import OpenAI

client = OpenAI(
    api_key="<AIHUBMIX_API_KEY>",
    base_url="https://aihubmix.com/v1",
)

response = client.chat.completions.create(
    model="auto:balanced",
    messages=[
        {"role": "user", "content": "Classify this request and propose the next step."}
    ],
)
Door model op auto te zetten, verschuift de modelselectie naar het verzoekpad. De router analyseert de taak en kiest een geschikt model. Een beleidssuffix maakt het optimalisatiedoel expliciet:
| Routerwaarde | Prioriteit | Typische agentstap |
|---|---|---|
auto |
Eerst kosten | Batchwerk en routinematige transformaties |
auto:balanced |
Capaciteit, kosten en latentie | Algemeen agentwerk |
auto:quality_first |
Eerst capaciteit | Complexe redenering en eindresultaten |
auto:latency_critical |
Eerst snelheid | Interactieve loops en lichtgewicht planning |
Routering brengt geen aparte kosten met zich mee. Het verzoek wordt afgerekend tegen de lijstprijs van het model dat het daadwerkelijk heeft afgehandeld. Het gekozen model en de routeringsdetails worden in het antwoord getoond, inclusief de header X-Aihubmix-Router-Resolved-Model, zodat de beslissing zichtbaar blijft en geen black box wordt.
Het volledige gedrag, de ondersteunde endpoints, beleidsregels en huidige beperkingen staan in de AIHubMix LLM Router-gids.
Modelroutering geeft een agent geen live data
Nadat modelroutering is ingesteld, kan de agent per stap een beter "brein" kiezen. Hij kan nog steeds niet weten wat er is veranderd na de trainingsdata van het model, geen toegang krijgen tot een privé-bedrijfssysteem of een actie uitvoeren in een andere applicatie, tenzij een tool die mogelijkheid levert.
Hier stapelen veel agentprojecten brosse code op. Een team koppelt eerst één zoek-API, dan één scraping-API en vervolgens één verrijkings-API. Elke integratie brengt weer een extra account, credential, verzoekformaat, foutmodel en factureringsrelatie met zich mee. Toolbeschrijvingen worden vaak in een systeemprompt gekopieerd en raken langzaam verouderd.
De faalwijze is gevaarlijk omdat ze succesvol kan lijken. Een model kan een plausibele aanroep doen tegen een verouderd schema, een onvolledig antwoord ontvangen en doorgaan alsof de taak is geslaagd. Schema-inspectie tijdens runtime is veiliger dan het model te laten onthouden welk API-contract het uit de training of uit een oude prompt kent.
De toollaag moet daarom drie vragen beantwoorden voordat er wordt uitgevoerd:
- Welke tool kan aan dit doel voldoen?
- Welk schema en welke prijs gelden nu?
- Welk resultaat heeft de aanroep daadwerkelijk teruggegeven?
Tool-discovery is de tweede routeringslaag
Monid maakt van toegang tot tools een discover-inspect-run-workflow. In plaats van dat de ontwikkelaar vooraf moet voorspellen welke API's een agent nodig kan hebben, kan de agent in natuurlijke taal een catalogus doorzoeken, het contract van een kandidaat inspecteren en het gekozen endpoint uitvoeren.
De basisstroom ziet er als volgt uit:
# 1. Find tools that match the goal
monid discover -q "find current product pricing from a public web page"

# 2. Read the selected endpoint's schema and pricing
monid inspect -p PROVIDER_SLUG -e ENDPOINT_PATH

# 3. Execute only after the agent has checked the contract
monid run -p PROVIDER_SLUG -e ENDPOINT_PATH \
  --query '{"url":"https://example.com/product"}'
Discovery en inspectie laten de agent opties vergelijken voordat hij iets uitgeeft. Uitvoering wordt gefactureerd volgens het prijsmodel van het gekozen endpoint. De ontwikkelaar houdt één integratie, terwijl de agent toegang krijgt tot tools van meerdere providers.
Voor agent-runtimes die installatie-instructies kunnen lezen, publiceert Monid ook een machineleesbare skill:
Set up https://monid.ai/SKILL.md
De Monid-workflowdocumentatie legt de catalogus-, inspectie- en uitvoeringsfasen uitgebreider uit.
Hoe de twee lagen samenwerken
De modelgateway en de toollaag moeten gescheiden componenten blijven, met een kleine, expliciete overdracht:
- De agent ontvangt een doel van de gebruiker.
- AIHubMix routeert een planningsaanroep naar een geschikt model.
- Het plan identificeert ontbrekende informatie of een vereiste externe actie.
- Monid ontdekt kandidaat-tools en toont hun schema's en prijzen.
- De agent selecteert en draait een tool binnen zijn rechten en budget.
- De tool levert feiten of een actieresultaat terug.
- AIHubMix routeert de synthese-aanroep volgens de vereiste kwaliteit, kosten of latentie.
- De agent geeft een antwoord dat is gebaseerd op het toolresultaat.
In vereenvoudigd Python kunnen de modelaanroepen ongewijzigd blijven, terwijl het toolresultaat als context wordt ingevoegd:
from openai import OpenAI

client = OpenAI(
    api_key="<AIHUBMIX_API_KEY>",
    base_url="https://aihubmix.com/v1",
)

# A fast model is sufficient for a lightweight planning step.
plan = client.chat.completions.create(
    model="auto:latency_critical",
    messages=[
        {
            "role": "user",
            "content": "Plan how to compare the current prices of these products.",
        }
    ],
)

# Your agent uses Monid to discover, inspect, and run an appropriate tool.
# Replace these placeholders with the structured result returned by that call.
tool_result = {
    "source": "<source-url>",
    "data": "<structured-tool-result>",
}

report = client.chat.completions.create(
    model="auto:quality_first",
    messages=[
        {
            "role": "system",
            "content": (
                "Write a concise comparison. Use only the supplied tool result, "
                "preserve source URLs, and state when a value is missing."
            ),
        },
        {"role": "user", "content": str(tool_result)},
    ],
)
Het belangrijke detail is niet het aantal regels. Het is dat geen van beide keuzes permanent in de applicatielogica hoeft te worden ingebed. Het model kan veranderen wanneer de prompt verandert, en de tool kan veranderen wanneer de taak verandert.
Kostenbeheersing hoort op beide lagen
Model- en toolkosten gebruiken verschillende eenheden, dus ze moeten afzonderlijk worden gemeten.
Op de modellaag bepaalt het gekozen model de tokenprijs. AIHubMix maakt die beslissing traceerbaar en laat ontwikkelaars een routeringsbeleid kiezen of de modellen beperken die een API-sleutel mag gebruiken. Routinestappen kunnen kosten of latentie laten prevaleren, terwijl gebruikersgerichte resultaten kwaliteit kunnen laten prevaleren.
Op de toollaag kan een endpoint per aanroep of per resultaat kosten in rekening brengen. Monid toont de prijs tijdens inspectie, vóór uitvoering. Een agent kan een endpoint weigeren dat het budget overschrijdt, een geverifieerde optie verkiezen of goedkeuring vragen voordat een ongewoon dure bewerking wordt uitgevoerd.
Nuttige productiecontroles zijn onder meer:
- Een modelallowlist of prijsplafond per API-sleutel.
- Een maximaal budget aan toolaanroepen per taak.
- Allowlists van providers of endpoints voor gereguleerde data.
- Logs die de modelroutingbeslissing koppelen aan de toolaanroep en het uiteindelijke antwoord.
- Expliciete bevestiging vóór onomkeerbare of gevoelige acties.
- Outputvalidatie, zodat tooldata wordt behandeld als onbetrouwbare invoer en niet als instructies.
Deze splitsing maakt kostenanalyse ook eenvoudiger. Als een run duur wordt, laten tokenlogs zien of de agent te veel heeft geredeneerd, terwijl toollogs laten zien of hij te veel heeft opgehaald. De oplossingen verschillen, en de architectuur moet dat onderscheid behouden.
Betrouwbaarheid vereist actuele contracten en zichtbare beslissingen
Dynamische selectie mag niet betekenen dat het gedrag onvoorspelbaar wordt.
Aan de modelkant rapporteert AIHubMix per verzoek het gekozen model en het routeringsbeleid. Sessiestickiness kan modelconsistentie en voordelen van prompt-caching behouden over meerdere beurten heen, terwijl fallback-gedrag indien nodig weg kan bewegen van een ongezond model.
Aan de toolkant inspecteert de agent het huidige endpointschema voordat hij een betaalde aanroep doet. Discovery-resultaten bevatten de informatie die nodig is om kandidaten te vergelijken, en het resultaat van de daadwerkelijke aanroep wordt het enige externe bewijs dat in de uiteindelijke completion wordt doorgegeven.
Samen creëren deze controles een nuttig auditspoor:
user goal
  -> routing decision and resolved model
  -> discovered tool candidates
  -> inspected schema and price
  -> selected endpoint and result
  -> final model decision and grounded response
Dat spoor is waardevoller dan alleen toegang hebben tot veel modellen of veel API's. Het verklaart waarom de agent elke keuze heeft gemaakt en welk bewijs zijn antwoord ondersteunde.
Wanneer je beide lagen niet nodig hebt
Niet elke workflow heeft baat bij keuze tijdens runtime.
Als een applicatie één stabiele prompt naar één getest model stuurt, is het model direct specificeren eenvoudiger en voorspelbaarder dan routeren. Als een geplande pipeline altijd één bekende API aanroept, is het misschien duidelijker die API direct te integreren dan een discovery-laag toe te voegen.
De architectuur met twee lagen is de moeite waard wanneer variatie onderdeel is van de workload:
- Prompts verschillen zoveel dat het beste model per stap verandert.
- Agents voeren meerdere modelaanroepen uit en moeten de cumulatieve kosten of latentie beheersen.
- Vereiste tools kunnen tijdens het bouwen niet volledig worden voorspeld.
- Externe data moet actueel zijn en de bron ervan moet zichtbaar zijn.
- Het team wil mogelijkheden toevoegen zonder voor elke mogelijkheid een nieuwe leverancierintegratie te moeten bouwen.
Gebruik de modellaag, de toollaag of beide, afhankelijk van de beslissingen die je applicatie daadwerkelijk moet nemen.
Bouw de agent rond beslissingen, niet rond afhankelijkheden
Een productie-AI-agent wordt niet bepaald door het aantal modellen of API's waarmee hij verbinding kan maken. Het wordt bepaald door of hij de juiste mogelijkheid voor de huidige stap kan kiezen, binnen een budget kan werken en kan uitleggen wat er is gebeurd.
AIHubMix geeft de agent een uniform modeleindpunt en routering op requestniveau op basis van kosten-, kwaliteits- en latentieprioriteiten. Monid geeft hem tool-discovery tijdens runtime, actuele schema's, zichtbare prijzen en uitvoering bij externe providers.
De ene laag bepaalt hoe de agent denkt. De andere bepaalt hoe hij informatie vindt en handelt. Door die beslissingen gescheiden te houden, ontstaat een agent die makkelijker uit te breiden, te observeren en te beheersen is.
Begin met de AIHubMix-snelstart en koppel daarna de toolkant via Monid.
FAQ
Wat is modelroutering voor AI-agents?
Modelroutering selecteert voor elk verzoek een model op basis van factoren zoals taaktype, capaciteit, kosten en latentie. Met AIHubMix zorgt het instellen van model op auto of een beleid zoals auto:quality_first voor selectie op requestniveau, met behoud van een OpenAI-compatibele API.
Waarom heeft een AI-agent tools nodig als het LLM al kennis heeft?
Een LLM genereert antwoorden op basis van de context die het ontvangt en wat het tijdens de training heeft geleerd. Zonder verbonden tool kan het niet betrouwbaar actuele prijzen kennen, een privédatabase raadplegen of een externe actie uitvoeren. Tools leveren live data en uitvoering; het model plant en interpreteert het resultaat.
Is een modelgateway hetzelfde als een MCP-server of tool-platform?
Nee. Een modelgateway routeert inferentieverzoeken naar modellen. MCP-servers en tool-platforms maken externe mogelijkheden beschikbaar voor een agent. Ze lossen complementaire integratieproblemen op en kunnen samen worden gebruikt.
Kunnen AIHubMix en Monid onafhankelijk van elkaar worden gebruikt?
Ja. AIHubMix kan modelaanroepen routeren voor applicaties zonder dynamische toolvereisten. Monid kan tool-discovery leveren aan agents die een andere modelprovider of gateway gebruiken. Beide gebruiken is nuttig wanneer een agent op beide lagen keuzes moet maken tijdens runtime.
Hoe houd ik automatische routering controleerbaar?
Registreer per taak het gekozen model, het routeringsbeleid, de toolkandidaat, de gecontroleerde prijs, het geselecteerde eindpunt en het teruggegeven resultaat. AIHubMix toont de routeringsdetails in het antwoord, terwijl Monid discovery en inspectie scheidt van uitvoering, zodat de toolbeslissing vóór de betaalde aanroep kan worden vastgelegd.