Gemini 4 Carbon은 새로운 모델 계열이 아닙니다. Gemini 4 Argon에 턴당 더 많은 사고를 적용한 모델이며, 토큰당 가격은 같습니다. 2026년 11월 30일까지 적용되는 도입 가격은 입력 토큰 100만 개당 $2, 출력 토큰 100만 개당 $10이고, 12월 1일부터는 각각 $4와 $20입니다. 어느 모델이 토큰당 더 저렴한지가 핵심 질문은 아닙니다. 두 모델의 가격은 같습니다. 핵심은 첫 응답이 더 늦어지는 대신, 추가 사고가 완료된 작업당 충분한 이점을 제공하는지입니다.
Artificial Analysis의 실시간 수치는 한 종류의 작업에서는 명확한 답을, 다른 종류의 작업에서는 분명한 경고를 제시합니다. Carbon High는 AA Intelligence Index에서 104개 모델 중 4위로 60.03점을 기록해, Argon High의 50.41점을 앞섭니다. 작업당 비용은 $7.76으로 Argon의 $9.95보다 낮고, 완료 시간도 25.6분으로 Argon의 29.0분보다 짧습니다. 하지만 첫 응답 토큰까지 걸리는 시간은 67.1초로, Argon의 40.1초보다 깁니다. 대기열 작업에는 Carbon이 더 나은 모델입니다. 대화형 작업에는 Argon이 더 낫습니다.
이 차이가 이 글의 핵심입니다. 아래에서 달라진 점, 측정 결과, Google 모델 카드의 추가 정보, 12월 1일의 가격 변경, 그리고 Argon을 계속 사용해야 하는 작업을 살펴봅니다.
Argon에서 달라진 점
Google의 모델 카드는 두 모델의 관계를 명확히 설명합니다. “Gemini 4 Carbon은 Gemini 4 Argon을 기반으로 합니다.” AIHubMix에서도 모델 ID는 gemini-4-carbon입니다. Google이 문서화한 컨텍스트 윈도우는 1,048,576토큰입니다. 사고 수준은 낮음, 중간, 높음이며 기본값은 중간입니다. 일반 출력 한도는 65,536토큰입니다. Google의 네이티브 장문 디코딩 경로에서는 입력 토큰을 뺀 최대 1,048,576토큰까지 출력할 수 있으며, 131,072와 262,144가 예시로 제시되어 있습니다. AIHubMix는 현재 Chat Completions만 문서화하고 있으므로, 더 큰 출력 경로가 문서화될 때까지 게이트웨이 요청은 65,536토큰 이하로 유지하세요. 지식 기준일은 2026년 3월입니다. Google은 이 모델을 무료 티어로 제공하지 않습니다.
변경 사항은 Google AI Studio의 안내에 설명되어 있습니다. “Carbon은 철저히 탐색하고 작업을 검증하기 위해 턴마다 더 많은 사고 토큰을 사용하므로 Argon보다 턴당 토큰 사용량과 지연 시간이 늘어납니다.” 이 문장이 이 글에서 다루는 차이 대부분을 설명합니다. 사고량이 늘면 어려운 작업의 성능 상한이 높아지고, 턴당 비용이 증가하며, 첫 토큰을 받기까지의 대기 시간도 길어집니다.
마이그레이션은 간단합니다. “Argon에서 업그레이드할 때 요청 스키마를 변경할 필요가 없습니다.” API 수준에서는 모델 문자열만 바꾸면 됩니다. Google은 “작업에 높은 수준이 필요하지 않다면 thinking_level을 중간(기본값)으로 유지하고, max_output_tokens와 HTTP 시간 제한이 더 긴 추론 과정을 허용하는지 확인하세요”라고 권고합니다.
측정 결과: 더 많은 사고, 더 낮은 작업당 비용
아래 수치는 Artificial Analysis의 실시간 측정값으로, 2026-11-11T05:23Z에 확인했습니다(모델 페이지를 06:01Z에 다시 확인했으며 수치는 동일했습니다). 입력 토큰 100만 개당 $4, 출력 토큰 100만 개당 $20인 일반 가격을 기준으로 합니다.
유용한 비교 기준은 완료 작업당 비용 대비 품질입니다. Carbon이 청구액을 낮추면서 더 높은 지수 점수를 내는지 살펴보는 것입니다. 아래 그래프는 네 가지 모델 구성을 각각 표시합니다.
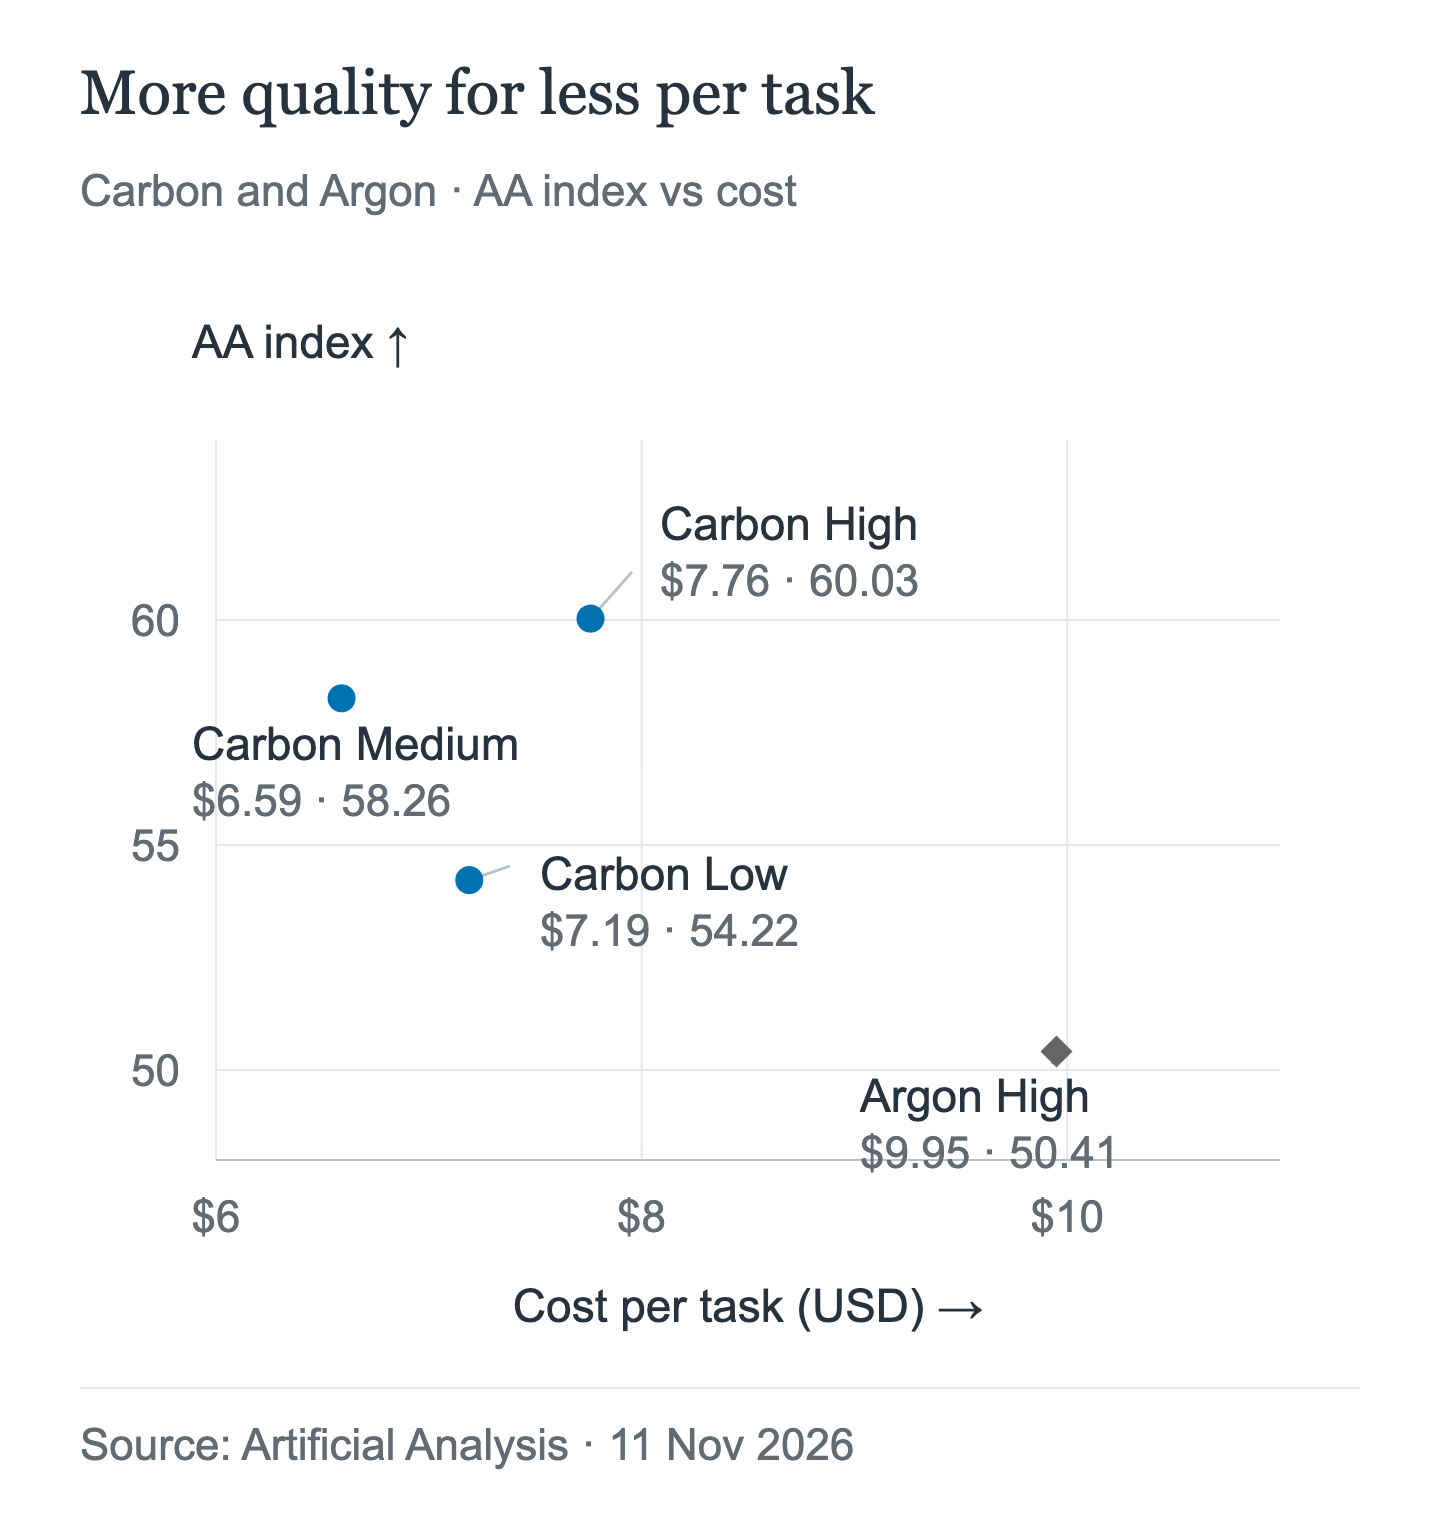
Carbon High는 Argon High보다 위쪽이면서 왼쪽에 있습니다. 이번 측정에서 Carbon Medium은 Carbon 설정 중 작업당 비용이 가장 낮습니다. Low는 비용 최소화가 아니라 지연 시간 단축을 위한 설정입니다. 여기 나온 값은 일반 가격 기준의 AA 작업당 비용이며, AIHubMix 요청 요금이 아닙니다.
| 모델 | AA 지수 | 작업당 $ | 작업당 분 | 첫 토큰까지 | 출력 토큰/초 |
|---|---|---|---|---|---|
| Carbon High | 60.03 | 7.76 | 25.6 | 67.1 s | 80.1 |
| Carbon Medium | 58.26 | 6.59 | 23.3 | 23.2 s | 73.7 |
| Carbon Low | 54.22 | 7.19 | 22.6 | 12.9 s | 63.5 |
| Argon High | 50.41 | 9.95 | 29.0 | 40.1 s | 66.8 |
Carbon High, Medium, Low는 104개 모델 중 각각 4위, 6위, 14위입니다. Argon High는 이들보다 낮은 순위입니다. Carbon High보다 위에 있는 세 항목은 모두 Claude Fable 5.2 구성입니다. “첫 토큰까지”는 첫 응답 토큰을 받을 때까지 걸리는 시간입니다. Carbon High와 Argon High를 비교하면 지수 점수는 9.62점 높고 작업당 비용은 22.0% 저렴하며, 완료 시간은 25.6분 대 29.0분입니다. 반면 첫 응답 토큰까지는 67.1초 대 40.1초가 걸립니다.
지수 점수 차이는 순위표에서 순위를 바꿀 만큼 큽니다. 지연 시간 차이는 사람이 기다릴지 말지를 바꿀 만큼 큽니다. 두 가지 모두 같은 행에서 확인할 수 있습니다.
Artificial Analysis는 Carbon이 “작업당 속도가 눈에 띄게 느리고 출력이 매우 길다”고 평가합니다. 지수 측정에 Carbon은 205 million 토큰을 생성했는데, Argon은 113 million, 측정 대상 모델의 중앙값은 72.8 million이었습니다. 이번 AA 측정에서 출력량이 훨씬 많은데도 작업당 비용은 더 낮았습니다. 정가는 같지만 토큰을 훨씬 더 많이 사용하고도 총 작업 비용은 낮은 것입니다.
이상치 하나는 따로 짚을 필요가 있습니다. Carbon Low는 사고량이 적은데도 작업당 비용이 $7.19로 Medium의 $6.59보다 높습니다. 원인이 무엇이든 Low는 비용 할인 설정이 아니라 지연 시간 단축 설정으로 작동합니다. 따라서 여기에 대량 요청을 라우팅하기 전에 작업당 비용을 측정하세요.
코딩 에이전트 관점
Intelligence Index는 여러 작업의 평균을 냅니다. Coding Agent Index v2는 도구를 사용하는 코딩 에이전트를 같은 테스트 환경에서 처음부터 끝까지 측정하므로 API 고객의 실제 사용 사례에 더 가깝습니다. Carbon High는 4위, Argon High는 11위입니다.
| 순위 | 에이전트 + 모델 | 지수 | 작업당 $ | 작업당 분 | 캐시 적중 |
|---|---|---|---|---|---|
| 4 | Antigravity CLI + Carbon High | 59.4 | 7.74 | 29.8 | 0.95 |
| 11 | Antigravity CLI + Argon High | 53.2 | 11.73 | 34.7 | 0.87 |
에이전트와 테스트 환경은 같고 모델만 다르므로, 이 비교에서는 기반 환경이 아닌 모델의 차이를 확인할 수 있습니다. Carbon은 작업당 비용이 34.0% 낮고 지수 점수는 6.2점 높으며, 완료 시간은 4.9분 짧습니다. 작업당 출력량은 109,031토큰 대 109,236토큰으로 거의 같습니다. 캐시 적중률은 0.95 대 0.87로 더 높고, 입력 사용량은 12.44 million 토큰 대 13.76 million 토큰으로 더 적습니다.
두 가지 주의할 점이 있습니다. Carbon은 이 지수에서 4위입니다. Claude Code와 Opus 5.5 Max가 61.7점으로 1위이며, 그 뒤로 Devin Fusion CLI와 GitHub Copilot Fusion이 따릅니다. 또한 Fable 5.2는 지수에 포함되어 있지 않으므로 이 표로 Carbon과 Fable의 우열을 판단할 수는 없습니다.
Google 모델 카드에서 알 수 있는 것과 알 수 없는 것
Google 모델 카드는 공급업체가 작성한 자료입니다. 2026년 10월 기준의 자체 보고 결과이며, 위에서 살펴본 실시간 데이터와는 다른 시점의 스냅샷입니다. 아래 항목에서는 매번 Google의 Carbon 점수가 더 높습니다.
| 벤치마크 | Carbon | Argon |
|---|---|---|
| AA Index v5.0(공급업체 자료) | 59 | 50 |
| Terminal-Bench 4.0 | 65.2 | 57.1 |
| FrontierSWE 2 | 61.2 | 55.0 |
| OSWorld-2.1 | 81.5 | 74.7 |
| Agents' Last Exam | 77.4 | 69.0 |
AA 항목은 Google이 반올림해 표기한 59점이며, 앞 표의 실시간 측정값 60.03점과 다릅니다. 두 수치는 서로 다른 시점의 스냅샷에서 나온 것이므로 함께 비교해서는 안 됩니다. 모델 카드의 외부 비교 대상은 Fable 5.2가 아니라 Fable 5.1입니다.
유용한 점은 일관성입니다. 성능 향상이 단일 벤치마크에만 나타나는 것은 아닙니다. 한계도 명확합니다. 공급업체 모델 카드는 작업당 비용을 산정하거나 첫 토큰 지연 시간을 측정하지 않으며, 에이전트가 몇 번의 턴을 거칠지도 알려주지 않습니다. 이 자료는 “Carbon이 평균적으로 더 강한 모델”이라는 주장을 뒷받침합니다. 하지만 “Carbon이 우리 작업 흐름에 더 나은 모델”이라는 주장을 뒷받침하지는 않습니다.
가격: 동일한 요금표, 12월 1일에 동일하게 변경
Carbon과 Argon의 요금은 항목별로 같습니다. 두 모델 모두 2026년 11월 30일까지 도입 가격이 적용되며, 12월 1일부터 요금이 두 배로 인상됩니다.
| 모델 | 입력 | 출력 | 캐시 읽기 |
|---|---|---|---|
| Carbon, 도입 가격(11월 30일까지) | $2.00 | $10.00 | $0.10 |
| Carbon, 12월 1일부터 | $4.00 | $20.00 | $0.20 |
| Argon, 도입 가격(11월 30일까지) | $2.00 | $10.00 | $0.10 |
| Argon, 12월 1일부터 | $4.00 | $20.00 | $0.20 |
| Gemini 3.1 Pro Preview(≤200k) | $2.00 | $12.00 | $0.20 |
| Fable 5.2 | $8.00 | $40.00 | $0.20 |
2026년 11월 11일 기준 공식 가격(토큰 100만 개당 USD). Gemini 3.1 Pro Preview는 프롬프트 토큰이 200k를 초과하면 $4/$18/$0.40이며, 저장 비용은 시간당 토큰 100만 개당 $4.50입니다. Fable 5.2의 캐시 쓰기 비용은 5분 보관 시 $10, 1시간 보관 시 $16이며, 배치 요청은 50% 할인됩니다. Carbon과 Argon의 도입 가격은 11월 30일에 종료되며, 두 모델의 모든 요금은 12월 1일부터 두 배가 됩니다.
AIHubMix는 Carbon을 $2/$10/$0.10으로 표시해 Google의 도입 가격과 동일합니다. 이 글에서는 11월 30일 이후 게이트웨이가 청구하는 요금을 가정하지 않습니다. 현재 가격은 모델 페이지에서 확인하세요.
Artificial Analysis에서 측정한 토큰 사용량을 도입 가격으로 다시 계산하면 작업당 대략 Carbon High는 $3.88, Medium은 $3.30, Low는 $3.60, Argon High는 $4.98입니다. 이는 AA 측정값이 아니라 계산으로 추정한 값입니다. 각 작업의 토큰 구성이 그대로 유지된다고 가정한 계산이므로, 실제 결과는 프롬프트와 캐시 적중률에 따라 달라집니다.
토큰당 가격으로 보면 Fable 5.2는 일반 가격에서 Carbon의 두 배, 도입 가격에서는 네 배입니다. 이는 가격 차이일 뿐 품질 우열을 뜻하지 않습니다. 시리즈의 세 번째 글에서 두 모델을 비교합니다.
Carbon이 더 나은 선택이 아닌 경우
Carbon을 선택하지 않을 이유는 성능이 더 나빠서가 아닙니다. Carbon이 제공하는 것, 즉 턴마다 더 많은 사고를 적용하는 기능이 대화형 제품에서 감당하기 어려운 비용이기 때문입니다.
첫 토큰이 늦게 도착합니다. Carbon High는 첫 응답 토큰까지 67.1초를 기다리지만 Argon High는 40.1초가 걸립니다. Medium은 대기 시간을 23.2초로, Low는 12.9초로 줄이지만 두 설정 모두 지수 점수가 낮아집니다. 응답이 도착했을 때 내용이 아무리 좋아도, 1분 동안 멈춰 있는 채팅 인터페이스는 이미 대화의 흐름을 놓친 셈입니다.
Google도 속도가 중요할 때는 Argon을 권합니다. Argon은 “더 빠른 응답과 턴당 더 적은 토큰 사용량”이 필요한 “대화형 코딩, 일상적인 기능 작업, 빠른 프로덕션 작업 흐름”을 위한 모델입니다. 마이그레이션 안내의 권고는 단호합니다. “속도가 중요한 경우 Argon을 계속 사용하세요.” Google의 발표 글도 같은 점을 강조합니다. “Argon은 대부분의 소프트웨어 엔지니어링 및 지식 작업에 여전히 이상적인 선택입니다.”
작업당 비용은 낮아도 턴당 지출은 더 많습니다. 토큰당 가격은 같지만 Carbon은 턴마다 더 많은 사고 토큰을 사용합니다. 턴당 토큰 사용량을 관리하거나 토큰 할당량을 배분하는 팀에는 Carbon이 더 비싼 모델로 느껴집니다. 지수 측정에 Carbon이 205 million 토큰을 사용한 반면 Argon은 113 million 토큰을 사용한 것은 이 효과가 극단적으로 나타난 사례입니다.
Low가 저렴한 선택지는 아닙니다. Carbon Low의 작업당 비용은 $7.19로 Medium의 $6.59보다 높습니다. 완료 작업당 비용을 기준으로 라우팅한다면 Low는 조건을 충족하지 못합니다.
벤치마크 우승으로 시간을 되돌릴 수는 없습니다. Google의 표에서는 OSWorld-2.1과 FrontierSWE 2 모두 Carbon이 앞서지만, 이 결과는 공급업체가 보고한 것이며 첫 토큰까지의 대기 시간을 바꾸지는 않습니다. 벤치마크는 결과를 측정하지만 사용자는 시작을 경험합니다.
지금 전환해야 하는 경우와 Argon을 계속 사용해야 하는 경우
지금 Carbon으로 전환하세요. 공급업체 네이티브 배치 작업이나 백그라운드 에이전트 작업을 실행하는 경우(이 경로는 AIHubMix에서 Carbon용으로 문서화되어 있지 않습니다), 품질 실패로 인한 비용이 실제 처리 시간보다 큰 경우, 요청이 더 긴 타임아웃과 더 큰 출력 예산을 감당할 수 있는 경우, 또는 Carbon을 사용하면 피할 수 있는 재시도에 이미 비용을 지불하고 있는 경우가 이에 해당합니다.
Argon을 계속 사용하세요. 채팅, 자동 완성 또는 사용자가 기다리는 모든 루프를 만드는 경우, 예산이나 할당량을 턴 단위로 측정하는 경우, 또는 제품에서 약 30초 미만의 지연 시간 목표가 중요한 경우가 이에 해당합니다.
두 모델 모두 먼저 테스트하세요. 어느 쪽인지 확신이 서지 않는다면 두 모델에 동일한 실제 요청 20~50개를 보내고, 첫 토큰까지 걸리는 시간과 작업 완료당 비용을 기록한 다음 인덱스가 아니라 그 결과를 기준으로 라우팅하세요. AIHubMix 비교 페이지에서 두 모델 페이지를 나란히 볼 수 있습니다.
AIHubMix를 통해 호출하는 방법
Carbon은 AIHubMix에서 동일한 모델 ID 형식과 문서화된 채팅 완료 엔드포인트를 사용합니다.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-carbon",
    messages=[{"role": "user", "content": "Summarise this incident report and list the follow-ups."}],
    max_tokens=16384,
)

print(response.choices[0].message.content)
엔드포인트는 POST /v1/chat/completions이며, 이는 AIHubMix가 이 모델에 대해 문서화한 유일한 경로입니다. 입력 모달리티로는 텍스트가 명시되어 있습니다. 이미지 및 PDF 입력, Responses API, Anthropic Messages, 네이티브 Gemini 엔드포인트는 AIHubMix의 Carbon용으로 문서화되어 있지 않으므로 지원 여부가 확인되지 않은 것으로 간주하세요. reasoning_effort 매핑도 마찬가지입니다. 게이트웨이가 사고 수준 매개변수를 전달한다고 가정하지 마세요. max_tokens는 표준 출력 한도인 65,536 이내로 유지하세요. 더 높은 한도를 사용하려면 Google의 백그라운드 모드가 필요하며, AIHubMix에서 지원되는지는 확인되지 않았습니다. 이 게시물 작성 시 실제 테스트는 진행하지 않았으므로, 예시는 검증된 응답이 아니라 요청 형식을 보여 줍니다.
자주 묻는 질문
Carbon은 Argon과 가격이 같나요?
네. Google의 공식 요금은 2026년 11월 30일까지 입력 토큰 100만 개당 $2, 출력 토큰 100만 개당 $10로 동일하며, 이후에는 각각 $4와 $20입니다. 캐시 읽기는 각각 $0.10, 이후 $0.20입니다.
Carbon이 Argon보다 낫나요?
Artificial Analysis의 측정 결과에 따르면 품질과 작업 완료당 비용 측면에서는 그렇습니다. Intelligence Index 점수는 60.03 대 50.41이고, 작업당 비용은 $7.76 대 $9.95입니다. 반응성 측면에서는 그렇지 않습니다. Carbon은 첫 응답 토큰이 나오기까지 67.1초가 걸리는 반면 Argon은 40.1초입니다.
Carbon은 작업을 더 빨리 끝내는데 왜 더 느린가요?
응답을 내기까지 더 오래 기다리는 대신 전체 작업은 더 빨리 끝냅니다. 25.6분 대 29.0분입니다. 첫 토큰까지 기다리는 시간과 전체 작업 시간은 서로 다른 측정값이며, 두 지표는 상반된 결과를 보여 줍니다.
요청을 변경해야 하나요?
아니요. Google에 따르면 Argon에서 업그레이드할 때 스키마를 변경할 필요가 없습니다. 모델 문자열만 gemini-4-carbon으로 바꾸면 됩니다. 더 긴 사고 시간을 감당할 수 있도록 출력 한도와 HTTP 타임아웃을 늘리세요.
Carbon Low는 왜 Medium보다 작업당 비용이 더 많이 드나요?
Artificial Analysis가 측정한 비용은 Low가 $7.19, Medium이 $6.59였습니다. Low는 할인 설정이 아니라 지연 시간 설정으로 보고, 대량 요청을 보내기 전에 작업당 비용을 측정하세요.
Artificial Analysis에서 Carbon의 순위는 몇 위인가요?
Intelligence Index에서 Claude Fable 5.2 구성 세 가지에 이어 4위입니다. Google의 모델 카드에는 같은 지표가 반올림된 59로 표시되어 있지만, 실시간 수치는 60.03이므로 두 수치를 혼용해서는 안 됩니다.
Carbon은 무료 티어에서 사용할 수 있나요?
아니요. Google은 Gemini 4 Carbon을 무료 티어로 제공하지 않으므로 유료 API 요금제나 AIHubMix 같은 게이트웨이를 통해 이용해야 합니다.
계속 읽기: Gemini 4 Carbon 시리즈
- 이 글을 읽고 Carbon을 사용해 보기로 했지만 첫 요청이 실패했다면, 마이그레이션 가이드에서 사고 과정이 길어지면서 달라지는 400 오류, 타임아웃 설정, 출력 한도를 확인할 수 있습니다. Gemini 4 Carbon API 마이그레이션: 400 오류, 타임아웃 및 출력 한도.
- Carbon이 에이전트 코딩에 충분한 모델인지, 아니면 Fable 5.2의 프리미엄이 그만한 가치가 있는지 궁금하다면, 세 번째 글에서 같은 측정 수치를 Fable 5.2와 나란히 비교합니다. Gemini 4 Carbon vs Fable 5.2: 에이전트 코딩에는 어떤 모델이 적합할까요?.
출처
- Google AI Studio, Gemini 4 Carbon: 새로운 기능
- Google DeepMind, Gemini 4 Carbon 모델 카드
- Google AI Studio, Gemini API 요금
- Artificial Analysis, Gemini 4 Carbon
- AIHubMix, Gemini 4 Carbon