AIHubMix gestisce una rete globale di accelerazione costruita internamente per il traffico API. Dopo aver valutato i fornitori terzi di accelerazione e aver riscontrato che latenza e stabilità non erano sufficienti per i carichi di lavoro AI in produzione, abbiamo implementato nodi edge propri, un sistema di monitoraggio e una pianificazione del traffico interna. Questo articolo descrive i risultati misurati e l'architettura alla base di essi.
Risultati misurati
I dati seguenti provengono dal monitoraggio continuo in produzione, dopo aver iterato sull'algoritmo di pianificazione.
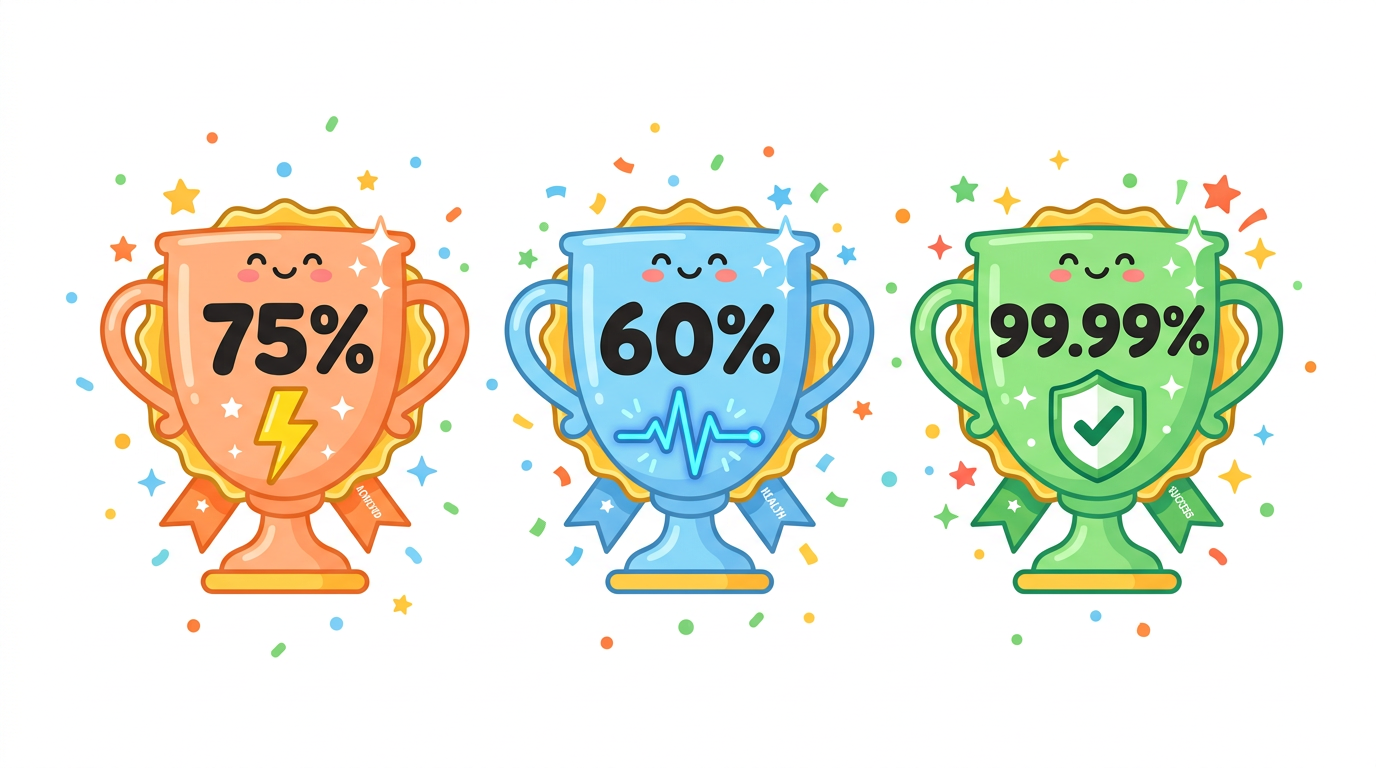
Latenza di risposta ridotta del 75%
La latenza API end-to-end è diminuita in media del 75%. Negli scenari di streaming questo migliora soprattutto il tempo al primo token (TTFT), ovvero l'intervallo tra l'invio di una richiesta e la ricezione del primo token di output, che determina quanto reattiva risulti un'applicazione di chat.
Fluttuazione della latenza ridotta del 60%
La varianza della latenza da una richiesta all'altra è diminuita del 60%. La coerenza della latenza è importante per le applicazioni in produzione: mantiene prevedibili i tempi di risposta percepiti dagli utenti e riduce i timeout dovuti alla latenza delle code.
Disponibilità del servizio al 99,99%
La disponibilità misurata sul traffico di produzione raggiunge il 99,99%. Si tratta di un dato misurato su tutte le ore, inclusi i fine settimana e i giorni festivi.
Architettura
Nodi edge costruiti internamente
La rete funziona su nodi di accelerazione dedicati distribuiti in più regioni, indipendenti da una singola linea o da un singolo fornitore cloud. Ogni nodo supera i benchmark di latenza, perdita di pacchetti e carico di picco prima di entrare in produzione; i nodi che non rispettano le soglie vengono rimossi dal pool. Il routing seleziona il percorso disponibile più veloce per ogni chiamata API.
Monitoraggio dello stato con sonde a livello di minuto
Sonde distribuite in più regioni eseguono ogni minuto un controllo dello stato end-to-end su ogni nodo, coprendo tre dimensioni: latenza, tasso di successo e stabilità. L'intera rete viene scansionata ogni 60 secondi, quindi le anomalie dei nodi vengono rilevate entro un ciclo di sonda.
Pianificazione del traffico con failover automatico
Il sistema di pianificazione ricalcola ogni minuto un punteggio di salute per ogni nodo, basato sui dati delle sonde su quattro finestre scorrevoli: 1 minuto, 5 minuti, 15 minuti e 1 ora. Il traffico viene instradato verso il nodo con il punteggio attuale migliore. Quando un nodo peggiora, il failover verso un nodo sano si completa in millisecondi, senza intervento umano.
Operazioni automatizzate
Gestione dei nodi, ottimizzazione dei percorsi, distribuzione delle configurazioni, rotazione dei certificati e ripristino dai guasti sono tutti automatizzati. La gestione degli incidenti non dipende dai tempi di risposta della reperibilità: i nodi degradati vengono rimossi dalla rotazione dal sistema di pianificazione non appena le sonde rilevano l'anomalia.
Cosa significa per la tua applicazione
- TTFT più basso e più costante nelle risposte in streaming.
- Meno errori di timeout e meno picchi di latenza delle code sotto carico.
- Nessuna modifica all'integrazione: l'accelerazione si applica automaticamente agli endpoint API standard.
FAQ
Devo modificare la mia integrazione per beneficiare della rete di accelerazione?
No. L'accelerazione si applica al livello di ingresso della piattaforma. Endpoint API, chiavi e formati delle richieste esistenti funzionano invariati.
Con quale frequenza viene verificato lo stato dei nodi?
Le sonde distribuite scansionano ogni nodo della rete ogni 60 secondi, misurando latenza, tasso di successo e stabilità end-to-end.
Cosa succede quando un nodo peggiora?
Il sistema di pianificazione ricalcola i punteggi di salute ogni minuto a partire da quattro finestre scorrevoli (1 minuto, 5 minuti, 15 minuti, 1 ora) e sposta automaticamente il traffico verso i nodi sani. Il failover si completa in millisecondi.
Ultimo aggiornamento: 2026-06-01