Die Anbindung eines LLM reicht aus, damit eine Anwendung Text generiert. Für einen KI-Agenten, der eine reale Aufgabe erledigt, reicht sie jedoch nicht aus.
Wenn Sie ein Modell bitten, ein Dokument zusammenzufassen, das bereits in seinem Kontext liegt, genügt die Modellschicht. Bitten Sie es jedoch, die heutigen Preise von Wettbewerbern zu vergleichen, einen Unternehmensdatensatz anzureichern, ein Social-Media-Konto zu prüfen oder die beste API für eine unbekannte Aufgabe auszuwählen, wird die fehlende Hälfte offensichtlich: Der Agent braucht einen zuverlässigen Weg zu externen Systemen.
Ein produktiver Agent trifft daher zwei getrennte Entscheidungen:
- Welches Modell soll diesen Schritt übernehmen?
- Welches Tool oder welche API soll die Daten liefern oder die Aktion ausführen?
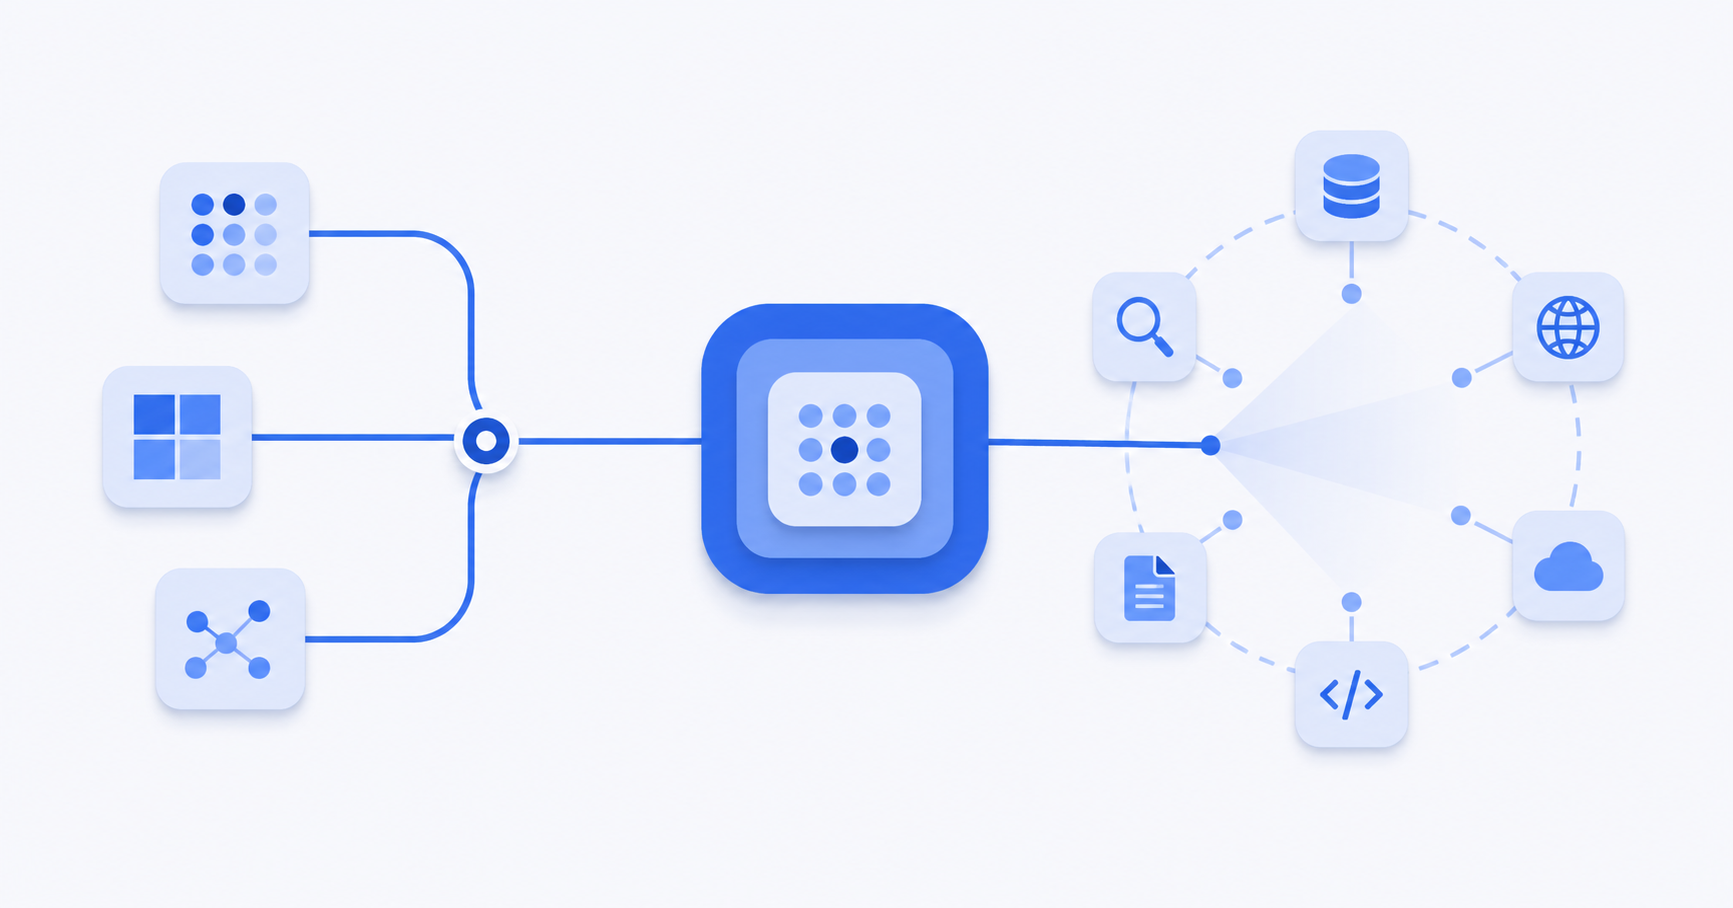
AIHubMix löst die erste Entscheidung mit einheitlichem Modellzugriff und Routing auf Anfrageebene. Monid löst die zweite mit Tool-Erkennung zur Laufzeit, Schema-Prüfung und Ausführung mit Abrechnung pro Aufruf. Die Produkte sitzen auf unterschiedlichen Ebenen derselben Architektur.
Hinweis: Dieser Artikel entstand im Rahmen einer Content-Kooperation mit Monid. AIHubMix ist die Modellplattform, die unten besprochen wird; Monid ist die Tool-Plattform. Beide lassen sich unabhängig voneinander nutzen.
Die zwei Routing-Probleme innerhalb eines KI-Agenten
Ein Agentenlauf besteht selten aus einem einzigen, gleichartigen Modellaufruf. Ein Recherche-Agent kann eine Anfrage klassifizieren, aktuelle Informationen suchen, strukturierte Fakten extrahieren, Ergebnisse vergleichen und eine finale Antwort verfassen. Diese Schritte erfordern unterschiedliche Fähigkeiten.
Das gilt auch außerhalb des Modells. Eine Unternehmensrecherche benötigt heute vielleicht eine Such-API, morgen einen Endpunkt zur Unternehmensanreicherung und nächste Woche ein Werkzeug zur Browserautomatisierung. Wenn jedes Modell und jedes Tool zur Build-Zeit fest einprogrammiert ist, wird jede neue Aufgabe zu einem eigenen Integrationsprojekt.
Die beiden Schichten sind parallel aufgebaut:
| Modellschicht | Tool-Schicht | |
|---|---|---|
| Kernentscheidung | Welches Modell soll antworten? | Welche API soll aufgerufen werden? |
| Zeitpunkt der Auswahl | Pro Anfrage | Pro Aufgabe, zur Laufzeit |
| Eingabe | Prompt, Modalität, Qualitäts- und Latenzanforderungen | Ziel, benötigte Daten oder Aktion, Schema und Preis |
| Ausgabe | Eine Modell-Vervollständigung | Externe Daten oder eine ausgeführte Aktion |
| Beispiel | AIHubMix | Monid |
Diese Trennung ist wichtig. Ein besseres Modell kann keinen Zugriff auf Live-Daten schaffen, und ein größerer Tool-Katalog kann die zurückgelieferten Daten nicht selbst auswerten. Der Agent braucht beide Fähigkeiten, verbunden durch einen klaren Vertrag zwischen ihnen.
Monid stellt die ergänzende Tool-seitige Sicht in Why an AI Agent Needs Two Integrations dar. Von der Modellseite aus ist die architektonische Lehre dieselbe: Modellauswahl und Tool-Auswahl unabhängig voneinander halten und jede Schicht für ihre eigene Aufgabe optimieren.
Warum ein festes Modell in einer Agentenschleife teuer wird
Ein einziges Modell für alles zu verwenden, wirkt einfach. In der Praxis zwingt es jeden Schritt, denselben Kompromiss zwischen Leistungsfähigkeit, Latenz und Preis hinzunehmen.
Betrachten wir einen Marktrecherche-Agenten:
- Die Absichtsklassifizierung ist kurz und mechanisch.
- Die Tool-Auswahl erfordert zuverlässiges Befolgen von Anweisungen.
- Das Extrahieren von Feldern aus zurückgelieferten JSON-Daten ist überwiegend Transformation.
- Der finale Bericht kann stärkeres logisches Denken und besseres Schreiben erfordern.
Alle vier Schritte an das leistungsstärkste Modell zu schicken, verschwendet Geld für Routinearbeit. Alle vier an das günstigste Modell zu schicken, kann dagegen die Qualität der einzigen Ausgabe mindern, die der Nutzer liest. Mit wachsender Agentenschleife wiederholt sich dieser Kompromiss bei jedem Aufruf.
AIHubMix stellt einen OpenAI-kompatiblen Endpunkt über einen breiten Modellkatalog bereit. Eine bestehende OpenAI-SDK-Integration lässt sich auf AIHubMix umstellen, indem man nur den API-Schlüssel und base_url ändert:
from openai import OpenAI

client = OpenAI(
    api_key="<AIHUBMIX_API_KEY>",
    base_url="https://aihubmix.com/v1",
)

response = client.chat.completions.create(
    model="auto:balanced",
    messages=[
        {"role": "user", "content": "Classify this request and propose the next step."}
    ],
)
Wenn Sie model auf auto setzen, wird die Modellauswahl in den Anfragepfad verlagert. Der Router analysiert die Aufgabe und löst sie auf ein geeignetes Modell auf. Ein Richtlinien-Suffix macht das Optimierungsziel explizit:
| Router-Wert | Priorität | Typischer Agentenschritt |
|---|---|---|
auto |
Kosten zuerst | Batch-Verarbeitung und Routine-Transformationen |
auto:balanced |
Leistungsfähigkeit, Kosten und Latenz | Allgemeine Agentenaufgaben |
auto:quality_first |
Leistungsfähigkeit zuerst | Komplexes logisches Denken und finale Ergebnisse |
auto:latency_critical |
Geschwindigkeit zuerst | Interaktive Schleifen und leichtgewichtige Planung |
Das Routing verursacht keine gesonderte Gebühr. Die Anfrage wird zum Listenpreis des Modells abgerechnet, das sie tatsächlich bearbeitet hat. Das aufgelöste Modell und die Routing-Details werden in der Antwort ausgegeben, einschließlich des Headers X-Aihubmix-Router-Resolved-Model, sodass die Entscheidung nachvollziehbar bleibt und nicht zur Blackbox wird.
Das vollständige Verhalten, die unterstützten Endpunkte, Richtlinien und aktuellen Einschränkungen sind im AIHubMix LLM Router Guide dokumentiert.
Modell-Routing verschafft einem Agenten keine Live-Daten
Nach der Konfiguration des Modell-Routings kann der Agent für jeden Schritt ein besseres „Gehirn“ wählen. Er kann aber weiterhin nicht wissen, was sich nach dem Trainingsdatenstand verändert hat, nicht auf ein privates Unternehmenssystem zugreifen und keine Aktion in einer anderen Anwendung ausführen, sofern kein Tool diese Fähigkeit bereitstellt.
Hier sammelt sich in vielen Agentenprojekten brüchiger Code an. Ein Team bindet zuerst eine Such-API, dann eine Scraping-API und danach eine Anreicherungs-API ein. Jede Integration bringt ein weiteres Konto, weitere Zugangsdaten, ein eigenes Anfrageformat, ein eigenes Fehlermodell und eine eigene Abrechnungsbeziehung mit sich. Tool-Beschreibungen werden oft in einen System-Prompt kopiert und veralten nach und nach.
Der Fehlermodus ist gefährlich, weil er erfolgreich aussehen kann. Ein Modell kann einen plausiblen Aufruf gegen ein veraltetes Schema absetzen, eine unvollständige Antwort erhalten und trotzdem so weitermachen, als sei die Aufgabe erledigt. Eine Schema-Prüfung zur Laufzeit ist sicherer, als vom Modell zu erwarten, dass es einen API-Vertrag aus dem Training oder aus einem alten Prompt im Gedächtnis behält.
Die Tool-Schicht sollte daher vor der Ausführung drei Fragen beantworten:
- Welches Tool kann dieses Ziel erfüllen?
- Welches Schema und welcher Preis gelten jetzt?
- Welches Ergebnis hat der Aufruf tatsächlich zurückgegeben?
Tool-Erkennung ist die zweite Routing-Schicht
Monid macht den Zugriff auf Tools zu einem Ablauf aus Entdecken, Prüfen und Ausführen. Statt dass der Entwickler jede API vorhersagen muss, die ein Agent eventuell braucht, kann der Agent einen Katalog in natürlicher Sprache durchsuchen, den Vertrag eines Kandidaten prüfen und den gewählten Endpunkt ausführen.
Der grundlegende Ablauf sieht so aus:
# 1. Find tools that match the goal
monid discover -q "find current product pricing from a public web page"

# 2. Read the selected endpoint's schema and pricing
monid inspect -p PROVIDER_SLUG -e ENDPOINT_PATH

# 3. Execute only after the agent has checked the contract
monid run -p PROVIDER_SLUG -e ENDPOINT_PATH \
  --query '{"url":"https://example.com/product"}'
Erkennung und Prüfung ermöglichen dem Agenten, Optionen zu vergleichen, bevor er etwas ausgibt. Die Ausführung wird gemäß dem Preismodell des gewählten Endpunkts abgerechnet. Der Entwickler behält eine einzige Integration, während der Agent Zugriff auf Tools mehrerer Anbieter erhält.
Für Agentenlaufzeiten, die Setup-Anleitungen lesen können, veröffentlicht Monid außerdem einen maschinenlesbaren Skill:
Set up https://monid.ai/SKILL.md
Die Monid-Workflow-Dokumentation erläutert die Stufen Katalog, Prüfung und Ausführung ausführlicher.
Wie die beiden Schichten zusammenarbeiten
Das Modell-Gateway und die Tool-Schicht sollten getrennte Komponenten mit einer kleinen, klar definierten Übergabe bleiben:
- Der Agent erhält ein Nutzerziel.
- AIHubMix leitet einen Planungsaufruf an ein geeignetes Modell weiter.
- Der Plan identifiziert fehlende Informationen oder eine erforderliche externe Aktion.
- Monid findet passende Tools und stellt deren Schemas und Preise bereit.
- Der Agent wählt ein Tool aus und führt es innerhalb seiner Berechtigungen und seines Budgets aus.
- Das Tool liefert Fakten oder ein Aktionsergebnis zurück.
- AIHubMix leitet den Syntheseaufruf entsprechend den erforderlichen Anforderungen an Qualität, Kosten oder Latenz weiter.
- Der Agent gibt eine Antwort zurück, die auf dem Tool-Ergebnis beruht.
In vereinfachtem Python können die modellseitigen Aufrufe unverändert bleiben, während das Tool-Ergebnis als Kontext eingefügt wird:
from openai import OpenAI

client = OpenAI(
    api_key="<AIHUBMIX_API_KEY>",
    base_url="https://aihubmix.com/v1",
)

# A fast model is sufficient for a lightweight planning step.
plan = client.chat.completions.create(
    model="auto:latency_critical",
    messages=[
        {
            "role": "user",
            "content": "Plan how to compare the current prices of these products.",
        }
    ],
)

# Your agent uses Monid to discover, inspect, and run an appropriate tool.
# Replace these placeholders with the structured result returned by that call.
tool_result = {
    "source": "<source-url>",
    "data": "<structured-tool-result>",
}

report = client.chat.completions.create(
    model="auto:quality_first",
    messages=[
        {
            "role": "system",
            "content": (
                "Write a concise comparison. Use only the supplied tool result, "
                "preserve source URLs, and state when a value is missing."
            ),
        },
        {"role": "user", "content": str(tool_result)},
    ],
)
Entscheidend ist nicht die Zahl der Zeilen. Entscheidend ist, dass keine der beiden Entscheidungen dauerhaft in die Anwendungslogik eingebettet werden muss. Das Modell kann sich mit dem Prompt ändern, und das Tool kann sich mit der Aufgabe ändern.
Kostenkontrollen gehören auf beide Schichten
Modell- und Tool-Kosten verwenden unterschiedliche Einheiten und sollten daher getrennt gemessen werden.
Auf der Modellebene bestimmt das aufgelöste Modell die Token-Preise. AIHubMix macht diese Entscheidung nachvollziehbar und ermöglicht Entwicklern, eine Routing-Richtlinie zu wählen oder die Modelle einzuschränken, die ein API-Schlüssel nutzen darf. Routinemäßige Schritte können Kosten oder Latenz bevorzugen, während nutzerseitige Ergebnisse die Qualität bevorzugen können.
Auf der Tool-Ebene kann ein Endpunkt pro Aufruf oder pro Ergebnis berechnen. Monid zeigt die Preise bei der Prüfung vor der Ausführung an. Ein Agent kann einen Endpunkt ablehnen, der sein Budget überschreitet, eine verifizierte Option bevorzugen oder vor einem ungewöhnlich teuren Vorgang eine Freigabe anfordern.
Nützliche Kontrollen im Produktivbetrieb umfassen:
- Eine Modell-Allowlist oder eine Preisobergrenze für jeden API-Schlüssel.
- Ein maximales Tool-Aufruf-Budget pro Aufgabe.
- Anbieter- oder Endpunkt-Allowlists für regulierte Daten.
- Protokolle, die die Routing-Entscheidung des Modells mit dem Tool-Aufruf und der finalen Antwort verknüpfen.
- Ausdrückliche Bestätigung vor unumkehrbaren oder sensiblen Aktionen.
- Ausgabevalidierung, damit Tool-Daten als nicht vertrauenswürdige Eingabe behandelt werden und nicht als Anweisungen.
Diese Trennung erleichtert auch die Fehlersuche bei Kosten. Wenn ein Lauf teuer wird, zeigen die Token-Protokolle, ob der Agent zu viel gedacht hat, und die Tool-Protokolle, ob er zu viele Daten abgerufen hat. Die Lösungen sind unterschiedlich, und die Architektur sollte diese Unterscheidung bewahren.
Zuverlässigkeit erfordert aktuelle Verträge und nachvollziehbare Entscheidungen
Dynamische Auswahl sollte kein unvorhersehbares Verhalten bedeuten.
Auf der Modellseite meldet AIHubMix für jede Anfrage das aufgelöste Modell und die Routing-Richtlinie. Session-Stickiness kann bei mehrstufigen Arbeitsabläufen die Modellkonsistenz und die Vorteile des Prompt-Caches bewahren, während ein Fallback-Verhalten bei Bedarf von einem fehlerhaften Modell weg umleiten kann.
Auf der Tool-Seite prüft der Agent das aktuelle Endpunkt-Schema, bevor er einen kostenpflichtigen Aufruf tätigt. Die Erkennungsergebnisse enthalten die Informationen, die zum Vergleich der Kandidaten nötig sind, und das Ergebnis des tatsächlichen Aufrufs wird als einziger externer Beleg in die finale Vervollständigung übernommen.
Zusammen ergeben diese Kontrollen einen nützlichen Prüfpfad:
user goal
  -> routing decision and resolved model
  -> discovered tool candidates
  -> inspected schema and price
  -> selected endpoint and result
  -> final model decision and grounded response
Dieser Pfad ist wertvoller als der bloße Zugriff auf viele Modelle oder viele APIs. Er erklärt, warum der Agent jede Entscheidung getroffen hat und welche Belege seine Antwort stützen.
Wann Sie nicht beide Schichten brauchen
Nicht jeder Workflow profitiert von einer Auswahl zur Laufzeit.
Wenn eine Anwendung einen stabilen Prompt an ein einziges, getestetes Modell sendet, ist es einfacher und deterministischer, dieses Modell direkt festzulegen, statt zu routen. Ruft eine geplante Pipeline immer dieselbe bekannte API auf, ist deren direkte Integration oft klarer als eine zusätzliche Erkennungsschicht.
Die zweischichtige Architektur lohnt sich, wenn Vielfalt Teil der Arbeitslast ist:
- Die Prompts unterscheiden sich so stark, dass sich das beste Modell von Schritt zu Schritt ändert.
- Agenten führen mehrere Modellaufrufe aus und müssen die kumulierten Kosten oder die Latenz unter Kontrolle halten.
- Die benötigten Tools lassen sich zur Build-Zeit nicht vollständig vorhersagen.
- Externe Daten müssen aktuell sein, und ihre Quelle muss sichtbar sein.
- Das Team möchte Funktionen hinzufügen, ohne für jede einzelne eine neue Anbieterintegration aufsetzen zu müssen.
Nutzen Sie die Modellebene, die Tool-Ebene oder beide, je nachdem, welche Entscheidungen Ihre Anwendung tatsächlich treffen muss.
Den Agenten um Entscheidungen statt um Abhängigkeiten aufbauen
Ein produktionsreifer KI-Agent wird nicht dadurch definiert, wie viele Modelle oder APIs er erreichen kann. Entscheidend ist, ob er für den aktuellen Schritt die richtige Fähigkeit auswählen, innerhalb eines Budgets arbeiten und nachvollziehbar erklären kann, was passiert ist.
AIHubMix stellt dem Agenten einen einheitlichen Modell-Endpunkt und zur Anfragezeit ein Routing bereit, das Kosten, Qualität und Latenz berücksichtigt. Monid bietet ihm Tool-Erkennung zur Laufzeit, aktuelle Schemas, transparente Preise und die Ausführung bei externen Anbietern.
Eine Ebene bestimmt, wie der Agent denkt. Die andere bestimmt, wie er Informationen beschafft und handelt. Wenn diese Entscheidungen getrennt bleiben, entsteht ein Agent, der sich leichter erweitern, beobachten und steuern lässt.
Beginnen Sie mit dem AIHubMix-Schnellstart und binden Sie anschließend die Tool-Seite über Monid an.
FAQ
Was ist Model Routing für KI-Agenten?
Model Routing wählt für jede Anfrage ein Modell anhand von Faktoren wie Aufgabentyp, Fähigkeit, Kosten und Latenz aus. Mit AIHubMix ermöglicht die Einstellung model auf auto oder einer Richtlinie wie auto:quality_first die Auswahl zur Anfragezeit, während die OpenAI-kompatible API erhalten bleibt.
Warum braucht ein KI-Agent Tools, wenn das LLM bereits über Wissen verfügt?
Ein LLM erzeugt Antworten aus dem Kontext, den es erhält, und aus dem, was es während des Trainings gelernt hat. Ohne angebundenes Tool kann es aktuelle Preise nicht zuverlässig kennen, keine private Datenbank abfragen und keine externe Aktion ausführen. Tools liefern Live-Daten und führen Aktionen aus; das Modell plant und interpretiert das Ergebnis.
Ist ein Model Gateway dasselbe wie ein MCP-Server oder eine Tool-Plattform?
Nein. Ein Model Gateway leitet Inferenzanfragen an Modelle weiter. MCP-Server und Tool-Plattformen stellen einem Agenten externe Fähigkeiten zur Verfügung. Sie lösen komplementäre Integrationsprobleme und können zusammen verwendet werden.
Können AIHubMix und Monid unabhängig voneinander verwendet werden?
Ja. AIHubMix kann Modellaufrufe für Anwendungen weiterleiten, die keine dynamischen Tool-Anforderungen haben. Monid kann Agenten Tool-Erkennung bereitstellen, auch wenn diese einen anderen Modellanbieter oder ein anderes Gateway nutzen. Beide gemeinsam zu verwenden ist sinnvoll, wenn ein Agent auf beiden Ebenen zur Laufzeit wählen muss.
Wie bleibt automatisches Routing nachvollziehbar?
Protokollieren Sie für jede Aufgabe das aufgelöste Modell, die Routing-Richtlinie, den Tool-Kandidaten, den geprüften Preis, den gewählten Endpunkt und das zurückgegebene Ergebnis. AIHubMix zeigt die Details zum Model Routing in der Antwort an, während Monid Erkennung und Prüfung von der Ausführung trennt, sodass die Tool-Entscheidung vor dem kostenpflichtigen Aufruf erfasst werden kann.