Am 4. August 2026 verzeichnete die offizielle Statusseite von DeepSeek zwei API-Vorfälle mit beeinträchtigter Leistung.
Der erste Vorfall dauerte 1 Stunde und 18 Minuten, von 02:02 bis 03:20 UTC, und betraf DeepSeek V4 Flash, V4 Pro und Expert Mode. Der zweite Vorfall dauerte 36 Minuten, von 03:43 bis 04:20 UTC, und betraf die DeepSeek V4 Flash API.
Beide Vorfälle sind inzwischen behoben. OpenCode meldete außerdem, dass DeepSeek Flash aufgrund beispielloser Nachfrage unter Kapazitätsproblemen litt. Die offizielle Statusseite von DeepSeek bestätigte jedoch lediglich eine beeinträchtigte Leistung und veröffentlichte keine Ursache.
TL;DR
- Die offizielle Statusseite von DeepSeek verzeichnete am 4. August 2026 zwei Vorfälle mit beeinträchtigter Leistung, die V4 Flash betrafen.
- Eine direkte Anbindung an einen einzelnen Provider schafft einen Single Point of Failure, selbst wenn dasselbe Modell auch anderswo verfügbar ist.
- AIHubMix kann dieselbe Modellanfrage über mehrere Provider-Kanäle wiederholen, wenn eine vorgelagerte Route einen wiederholbaren Fehler zurückgibt.
- Schlagen alle Provider-Kanäle des primären Modells fehl, kann der schlüsselbezogene Modell-Fallback die Anfrage auf konfigurierte Ersatzmodelle umleiten.
- Multi-Provider-Routing verringert die Abhängigkeit von einem einzelnen Endpunkt, kann aber korrelierte Ausfälle oder Risiken auf Gateway-Ebene nicht vollständig ausschließen.
Vorfälle wie dieser verdeutlichen ein wichtiges Infrastrukturprinzip:
Ein zuverlässiges Modell reicht nicht aus, wenn es nur über einen einzelnen Provider-Endpunkt erreichbar ist.
Ein Modell muss nicht zwingend einen Provider bedeuten
Wenn eine Anwendung direkt mit einem einzelnen Provider verbunden ist, wird dieser Endpunkt zum Single Point of Failure.
Wenn der Provider einen Ausfall erleidet, das Ratenlimit erreicht oder einen Latenzsprung verzeichnet, hat die Anwendung keine Alternative, an die sie die Anfrage senden könnte. Nutzer sehen Timeouts und Fehler, selbst wenn dasselbe Modell über andere Infrastruktur-Provider weiterhin verfügbar ist.
AIHubMix trennt das Modell vom Provider, der es bereitstellt.
So ist DeepSeek V4 Flash etwa auf AIHubMix über mehrere Provider verfügbar, darunter DeepSeek, Baidu, DeepInfra und Alibaba Cloud. Anwendungen nutzen weiterhin einen einzigen OpenAI-kompatiblen API-Endpunkt, während AIHubMix die verfügbaren vorgelagerten Routen verwaltet.
Dadurch entstehen zwei unterschiedliche Zuverlässigkeitsebenen.
Ebene 1: Provider-Failover
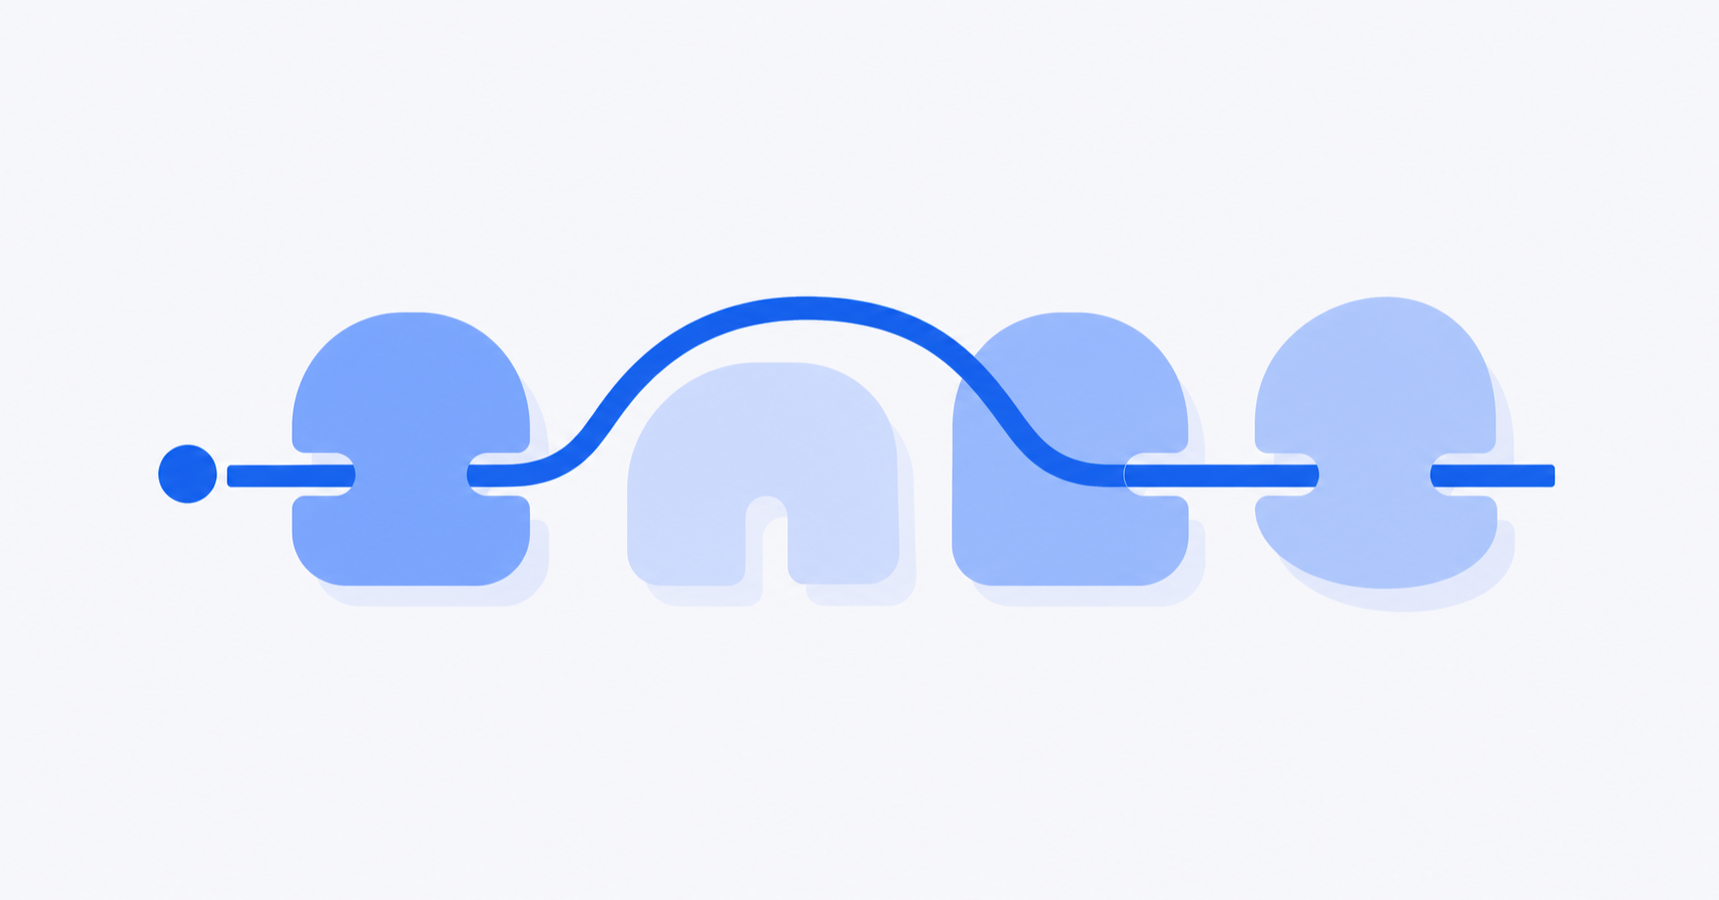
Beim Provider-Failover bleibt das angefragte Modell unverändert, während der dahinterliegende Infrastruktur-Provider gewechselt wird.
Wenn eine Anfrage für DeepSeek V4 Flash bei AIHubMix eingeht, wählt das Gateway einen geeigneten Provider-Kanal aus. Gibt dieser Kanal einen wiederholbaren Fehler zurück, bevor die Antwort beginnt, kann AIHubMix einen anderen verfügbaren Kanal für dasselbe Modell versuchen.
Der Anfragepfad kann so aussehen:
- DeepSeek V4 Flash über Provider A anfragen.
- Provider A gibt einen Timeout, einen 5xx-Fehler oder einen wiederholbaren Kapazitätsfehler zurück.
- Dasselbe DeepSeek-V4-Flash-Modell über Provider B anfragen.
- Dieser Vorgang wird fortgesetzt, bis die Anfrage erfolgreich ist oder alle geeigneten Kanäle ausgeschöpft sind.
Der Client muss keine mehreren Provider-SDKs einbinden, keine separaten API-Schlüssel verwalten und keine eigene Wiederholungslogik implementieren.
Dies ist Failover auf Provider-Ebene: Der Provider wechselt, das angefragte Modell bleibt gleich.
Ebene 2: Modell-Fallback
Ein Provider-Failover hilft nicht, wenn alle verfügbaren Provider für das primäre Modell ausgefallen sind.
AIHubMix bietet deshalb eine zweite Zuverlässigkeitsebene: den Modell-Fallback.
Nutzer können für jeden API-Schlüssel eine geordnete Liste von Ersatzmodellen konfigurieren. Nachdem alle geeigneten Kanäle für das primäre Modell einen wiederholbaren Fehler zurückgegeben haben, wechselt AIHubMix zum nächsten Modell in der Fallback-Liste.
Zum Beispiel:
- Primär:
deepseek-v4-flash - Erster Fallback:
gpt-5.4 - Zweiter Fallback:
gemini-3.1-pro-preview
Der Fallback wird innerhalb des AIHubMix-Gateways ausgeführt. Bestehende Anwendungen müssen keine zusätzlichen Routing-Parameter senden oder ihren Client-Code ändern.
Die Abrechnung richtet sich nach dem Modell, das schließlich die erfolgreiche Antwort liefert. Entwickler können das Fallback-Verhalten über die Antwort-Header überprüfen:
X-Aihubmix-Fallback: trueX-Aihubmix-Model: <final-model>
Die vollständige Konfiguration und die Auslöseregeln sind in AIHubMix Model Mapping and Fallback dokumentiert.
Was das automatische Failover abfangen kann
Das Provider-Failover ist darauf ausgelegt, sich von vorgelagerten Infrastrukturproblemen zu erholen, etwa:
- Provider-Timeouts
- Verbindungsfehler
- Wiederholbare 5xx-Antworten
- Ratenlimits von Providern und Kapazitätsfehler
- Vorübergehende Nichtverfügbarkeit eines vorgelagerten Kanals
Treten diese Fehler auf, bevor die Antwort beginnt, kann AIHubMix transparent eine andere Route versuchen.
Was Failover nicht lösen kann
Multi-Provider-Routing verbessert die Verfügbarkeit, macht ein Gateway aber nicht unfehlbar.
Ein Fallback wird nicht ausgelöst, wenn:
- der AIHubMix-API-Schlüssel des Nutzers ungültig, abgelaufen oder ohne Kontingent ist
- die Anfrage selbst ungültig ist
- der Client die Verbindung trennt oder sein eigenes Timeout erreicht
- eine Streaming-Antwort bereits begonnen hat
- ein bestimmter Provider-Kanal ausdrücklich ausgewählt wurde
- der Fehler alle Provider oder das Gateway selbst betrifft
Provider-Ausfälle können auch korreliert sein. Mehrere Provider können von derselben zugrunde liegenden Infrastruktur, demselben Modellrelease oder demselben regionalen Netzwerk abhängen. Deshalb sollte die Verfügbarkeit mehrerer Provider anhand echten Traffics gemessen und nicht allein aus der Anzahl der Provider abgeleitet werden.
Warum ein Aggregator zuverlässiger sein kann als ein direkter Endpunkt
Wer eine offizielle API direkt aufruft, hat für die Anwendung genau einen Weg zum Modell.
Ein Multi-Provider-Gateway bietet mehrere Wege.
Fallen diese Provider-Routen unabhängig voneinander aus, kann das Gateway einen beeinträchtigten Endpunkt umgehen, ohne den Fehler der Anwendung offenzulegen. Dies verringert die Abhängigkeit von einem einzelnen Provider und kann eine höhere Verfügbarkeit bieten als eine direkte Einzel-Provider-Anbindung.
Der Unterschied liegt in der Architektur:
- Direkte API: ein Modell, ein Provider, eine Fehlerdomäne
- AIHubMix: ein Modell, mehrere Provider, automatisches Failover
- AIHubMix mit Modell-Fallback: mehrere Provider plus Ersatzmodelle
Ziel ist nicht, vorherzusagen, welcher Provider als Nächstes ausfällt. Ziel ist, einen vorgelagerten Vorfall zu einem internen Routing-Ereignis zu machen statt zu einem Ausfall, den Kunden bemerken.
Auf den nächsten Provider-Vorfall vorbereitet sein
DeepSeek V4 Flash hat sich wieder erholt, doch vorübergehende Kapazitätsengpässe, Ratenlimits und Ausfälle vorgelagerter Dienste sind normale Bestandteile produktiver KI-Infrastruktur.
Anwendungen sollten nicht jedes Mal den Code ändern müssen, wenn ein Provider instabil wird.
Mit AIHubMix können Entwickler über eine einzige API auf mehrere Provider zugreifen, dasselbe Modell automatisch über verfügbare Kanäle erneut versuchen und Ersatzmodelle für eine zusätzliche Schutzebene konfigurieren.
Verfügbare Modelle und Provider finden Sie unter aihubmix.com/models.
FAQ
Was ist Multi-Provider-Failover?
Es wiederholt die Anfrage automatisch für dasselbe Modell über einen anderen geeigneten Provider, wenn die aktuelle Route einen wiederholbaren Fehler zurückgibt.
Worin unterscheidet sich der Modell-Fallback?
Beim Provider-Failover bleibt das Modell unverändert. Der Modell-Fallback wechselt erst dann zu einem konfigurierten Ersatzmodell, wenn alle geeigneten Kanäle für das primäre Modell fehlschlagen.
Welche Fehler können ein Failover auslösen?
Typische Auslöser sind Timeouts, Verbindungsfehler, wiederholbare 5xx-Antworten, Ratenlimits und vorübergehende Kapazitätsfehler, bevor eine Antwort beginnt.
Garantiert Failover null Ausfallzeit?
Nein. Korrelierte Provider-Ausfälle, Vorfälle auf Gateway-Ebene, nicht wiederholbare Fehler sowie Fehler nach Beginn des Streamings können den Client trotzdem erreichen.
Muss ich meinen Anwendungscode ändern?
Es ist keine zusätzliche Routing-Logik erforderlich. Anwendungen nutzen weiterhin den OpenAI-kompatiblen Endpunkt von AIHubMix, während Ersatzmodelle auf API-Schlüssel-Ebene konfiguriert werden können.