
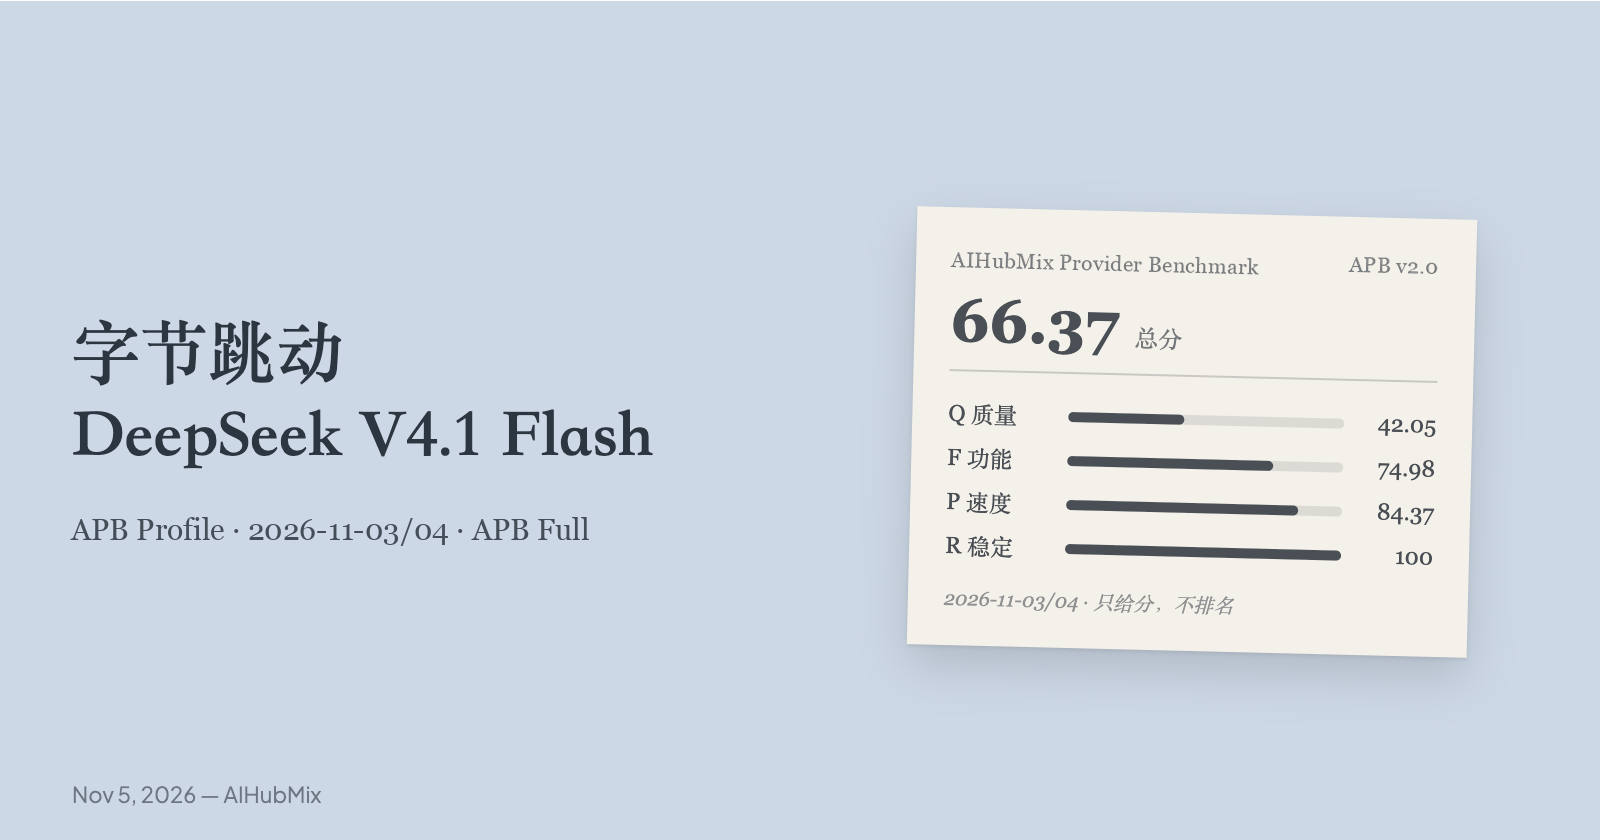
2026-11-03/04,透過 AIHubMix 使用 APB Full 套件,在五家供應商上測試了 DeepSeek V4.1 Flash 1017:每次使用相同的問題、參數和請求指令碼。這份 APB Profile 僅涵蓋 ByteDance 的測試結果,並逐節呈現。
以下數據是分數,不是排名,也不是供應商推薦。先列出 Q、F、P、K 和 R;整體分數是摘要指標,不是認證,也沒有信賴區間。評分規則詳見 AIHubMix Provider Benchmark Standard v2.0。
五家供應商的分數
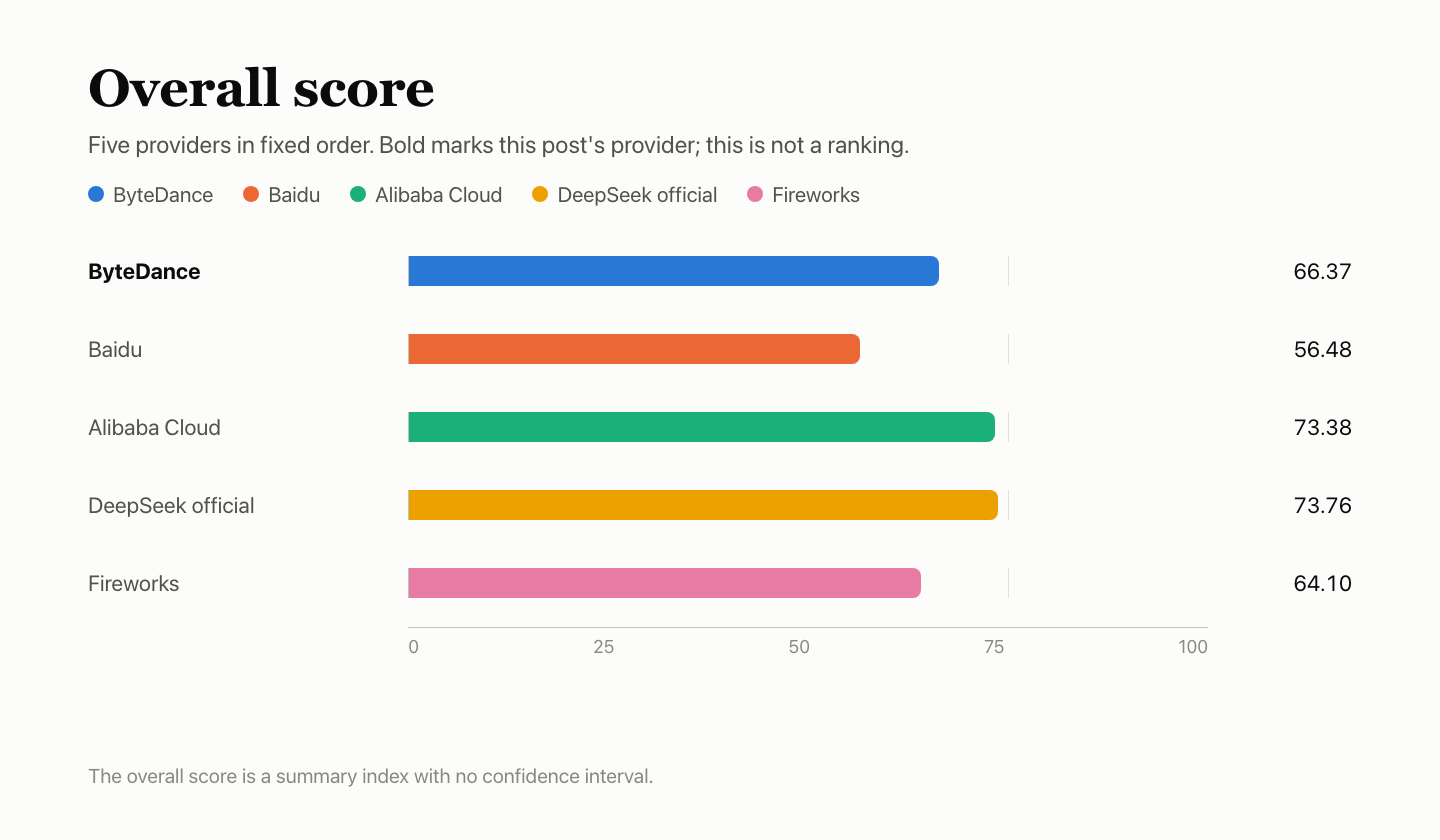
粗體標示本文介紹的供應商。供應商順序固定,並非排名。K 是 P 的子分數,占 P 的 20%。整體分數是沒有信賴區間的摘要指標。DeepSeek 官方管道和 Alibaba Cloud 相差 0.37,無法區分。
快速總覽
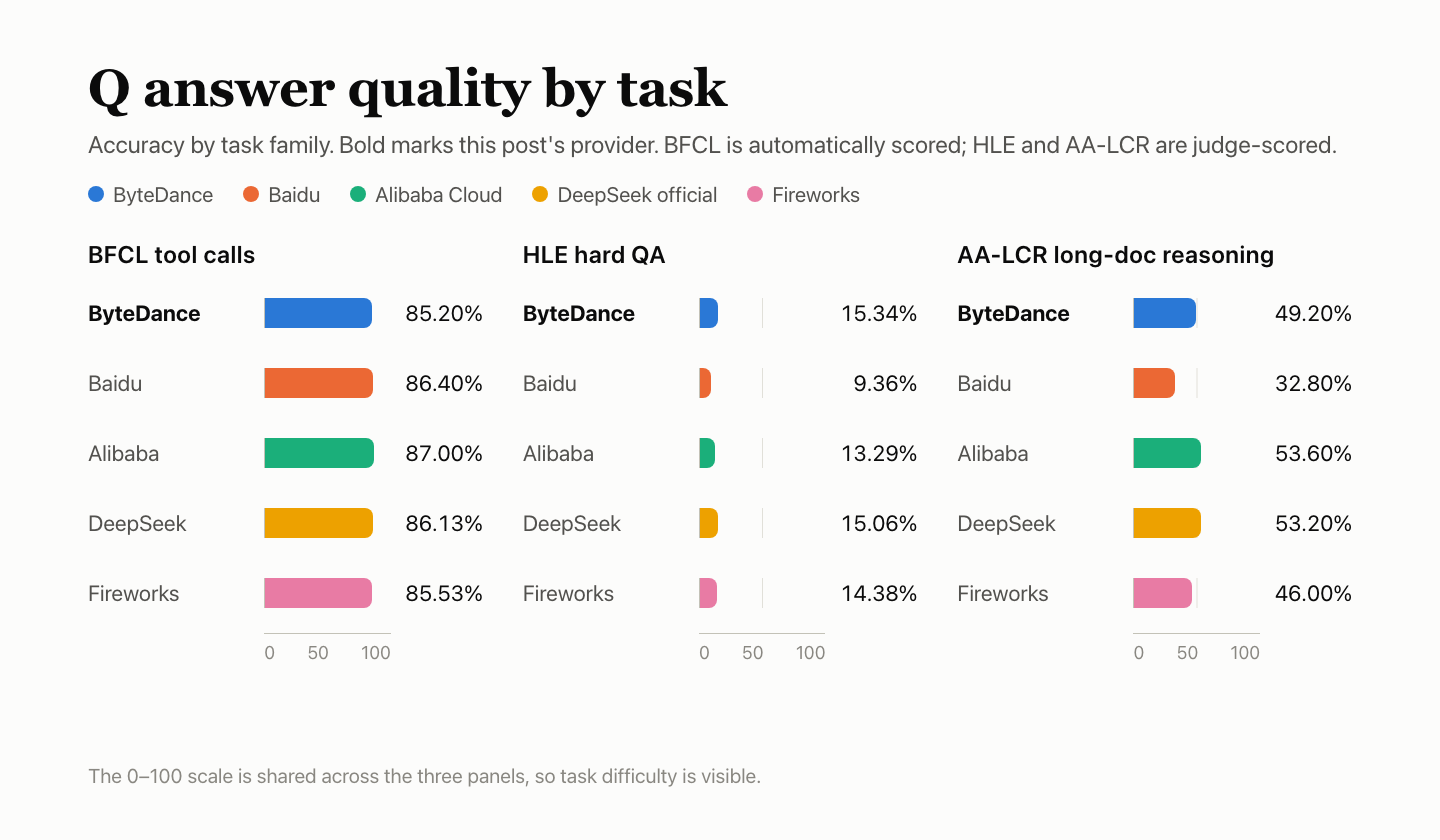
- Q 42.05。 BFCL 85.20%、HLE 15.34%、AA-LCR 49.20%。與官方管道相差 −0.40 個百分點,95% 區間為 −1.46 至 +0.66:無法區分。AA-LCR 有 28 次請求失敗,全都發生在視窗 1,並計為答錯。
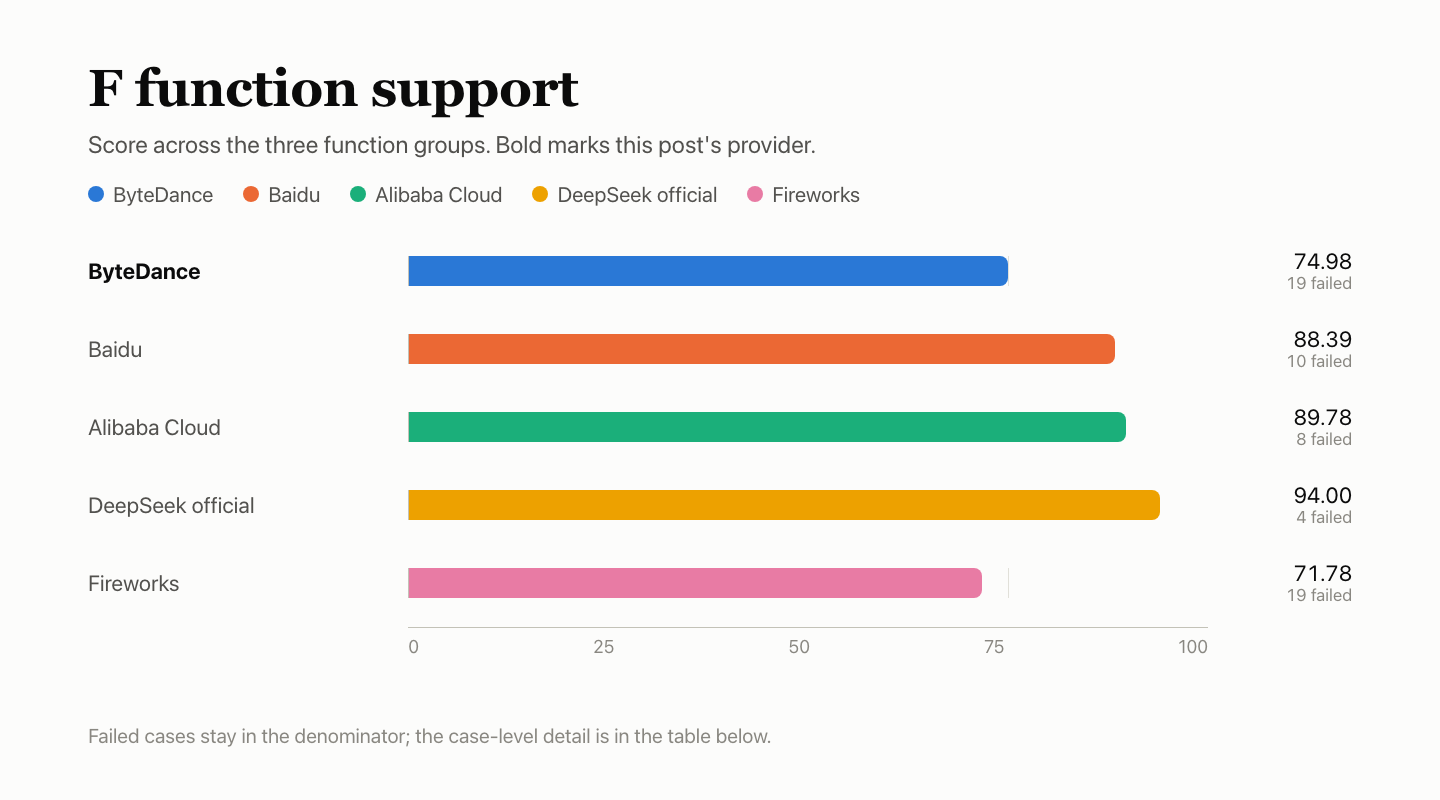
- F 74.98。 174 項計分檢查中有 124 項通過。
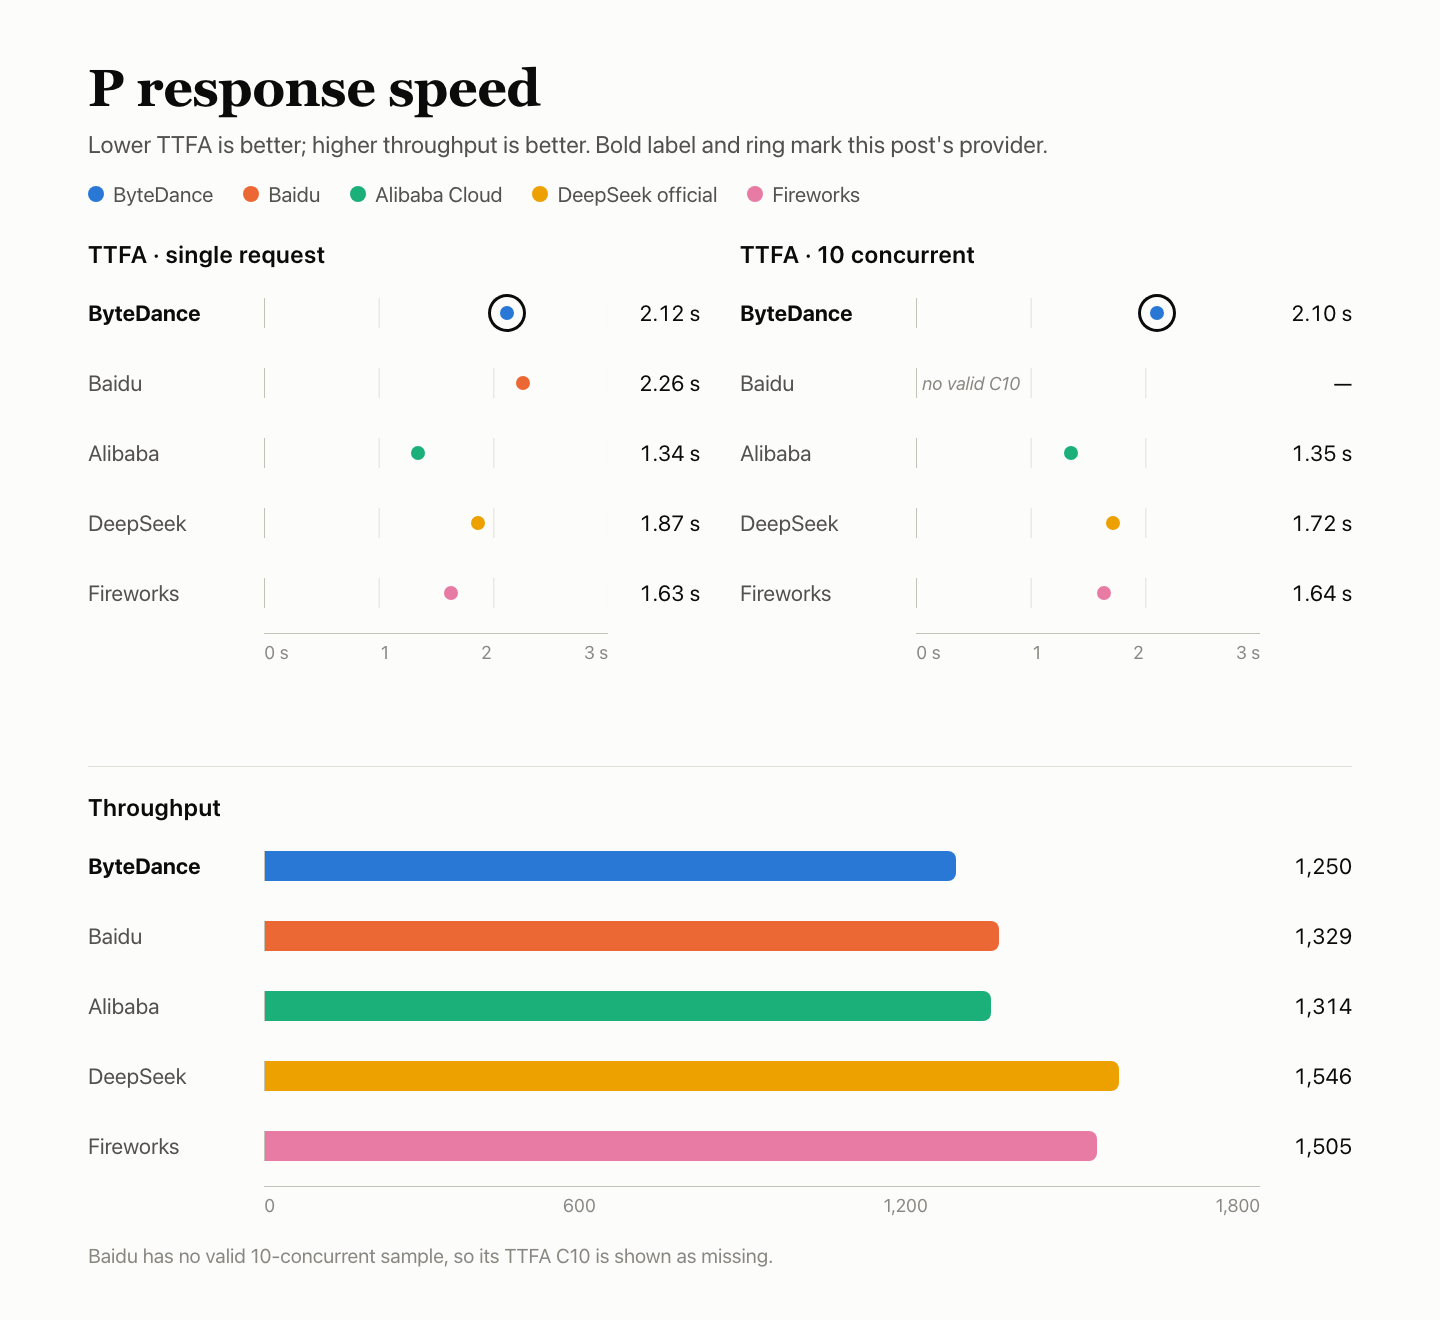
reasoning_effort=none並不會關閉思考模式。10k token 輸入回報為 10,026 tokens(原生計數為 10,000);8-token 輸入則回報為 34。 - P 84.37。 第一個本文 token:單一併發的中位數為 2.12 s,10 路併發為 2.10 s;TPOT 為 3.43 ms/token;180 次速度請求全數有效。
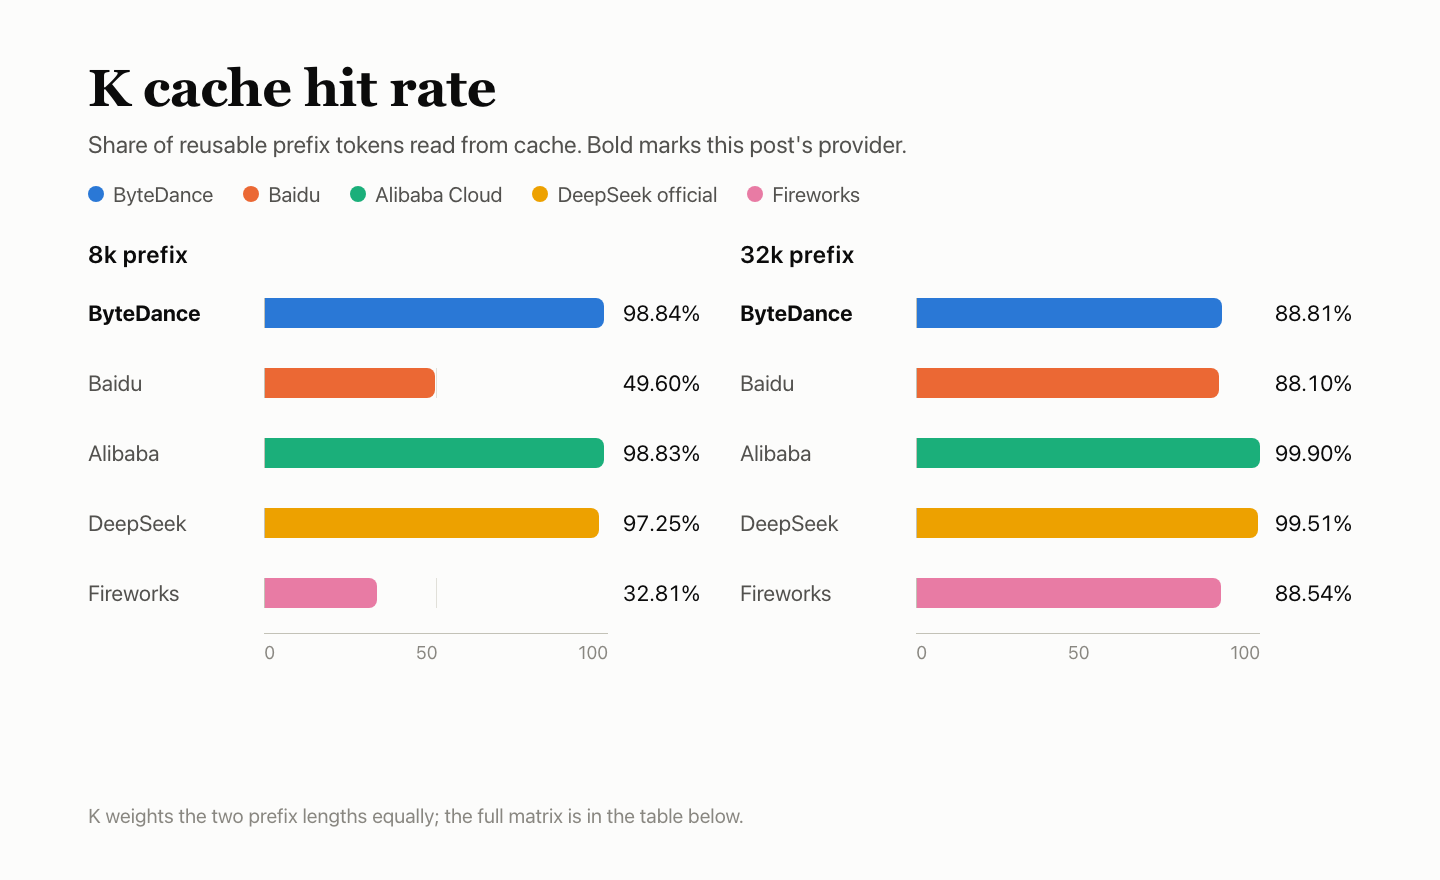
- K 93.83。 8k 熱請求命中 9/9;32k 命中 8 次,另有一次請求在 300 s 截止時間內未完成。
- R 100。 專用的 300 次請求全都首次嘗試即成功。
測試設定
| 項目 | 詳細資料 |
|---|---|
| 模型 | DeepSeek V4.1 Flash 1017 |
| 請求的模型 ID | doubao-deepseek-v4.1-flash-1017 |
| 回傳的模型名稱 | deepseek-v4-1-flash-261017 |
| 存取路徑 | 透過 AIHubMix 使用供應商專屬的模型 ID,並非直接連線至供應商帳戶 |
| 參數 | 非思考模式,temperature 1.0,max_tokens 16,384,timeout 300 s,不自動重試 |
| 關閉思考模式 | 答案品質、速度、快取和穩定性請求使用原生 thinking.type=disabled(對此供應商而言,reasoning_effort=none 不會關閉思考模式);函式案例則保留 reasoning_effort=none,以檢查參數是否生效 |
| 時間 | 2026-11-03 18:07 – 11-04 16:33 UTC+8;五家供應商共用一台 Mac mini、一個網路和一個帳戶 |
| 樣本數 | 答案品質 4,250 個問題實例(BFCL 500 × 3、HLE 250 × 10、AA-LCR 25 × 10);函式 60 個案例 × 3 個視窗;速度:單一併發 90 次、10 路併發 90 次;穩定性 300 次;快取 30 次(8k 和 32k 前綴各三組) |
請求使用 AIHubMix 的 快速入門路徑,搭配供應商專屬的 ID;參數則依照 DeepSeek 的 API 文件設定。其他供應商 ID 列於模型頁面。
Q — 答案品質:42.05
答案品質測試包含三個套件:500 個 BFCL 問題,每題測試 3 輪;250 個 HLE 問題,每題測試 10 輪;25 個 AA-LCR 問題,每題測試 10 輪。BFCL 依自動化規則評分;HLE 和 AA-LCR 則由模型 deepseek-flash 評判。五家供應商收到的問題完全相同,三個套件合併計算為一項準確率。由於 10 個答案所對應的問題無法評分,因此予以排除,最後共計 4,240 個已評分問題實例。
| 套件 | 問題數 | 答對數 | 準確率 | 失敗數 |
|---|---|---|---|---|
| BFCL 工具呼叫 | 500 × 3 | 1,278/1,500 | 85.20% | 0 |
| HLE 高難度 QA | 250 × 10 | 382/2,490 | 15.34% | 7 |
| AA-LCR 長文件推理 | 25 × 10 | 123/250 | 49.20% | 28 |
| 合計 · 95% 區間 39.70%–44.33% | — | 1,783/4,240 | 42.05% | 35 |
服務失敗——請求失敗或輸出遭截斷——仍計入分母,並視為答錯。HLE 輸出有 7 次達到 max_tokens 上限;AA-LCR 有 28 次請求失敗,全都發生在視窗 1。BFCL 由系統自動評分;HLE 和 AA-LCR 則由評審模型評分。
每個 BFCL 問題回答 3 次;表格加總了這 3 輪的結果。
| BFCL 類別 | 通過數 | 通過率 |
|---|---|---|
| simple_python — 單一函式,呼叫和引數正確 | 329/360 | 91.39% |
| multiple — 從多個函式中選擇一個 | 268/300 | 89.33% |
| parallel — 多次呼叫同一個函式 | 271/300 | 90.33% |
| parallel_multiple — 呼叫多個不同函式 | 207/240 | 86.25% |
| irrelevance — 沒有相關函式,不應呼叫 | 102/150 | 68.00% |
| ahm_multi_turn — 三階段工具鏈 | 101/150 | 67.33% |
與其他四家比較
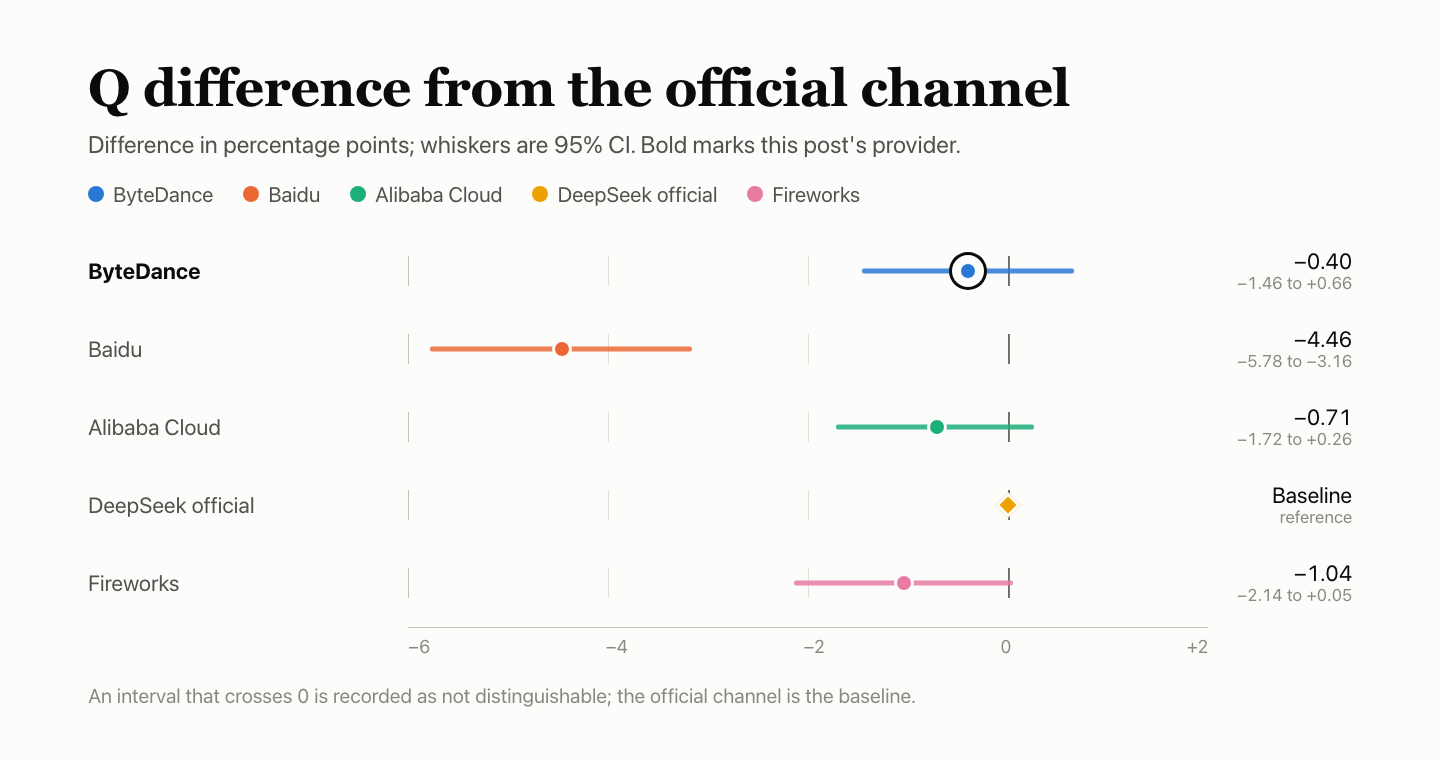
與官方管道的差異,以百分點表示;鬚線顯示 95% 區間。若區間跨過 0,則記為無法區分。HLE 和 AA-LCR 的評審模型 deepseek-flash 與受測模型同屬 DeepSeek 家族,且未經校準,因此判斷可能偏寬鬆。
F — 函式支援:74.98
函式套件只檢查介面行為是否符合通訊協定,不評估模型回答得好不好。六組共 60 個案例,每個視窗執行一次,共 180 項檢查,並依各供應商文件記載的格式進行判定。不適用、無效或未觀察到的檢查會從分母中排除。ByteDance 在 174 項計分檢查中通過 124 項,依各組權重計算後得分為 74.98。
加權分數依各組權重計算;並非通過項目數除以 174。
| 組別 | 權重 | 通過數 | 排除數 | 組別分數 |
|---|---|---|---|---|
| 串流與訊息通訊協定 | 20% | 23/27 | 3 | 85.19 |
| 工具介面 | 20% | 30/30 | — | 100.00 |
| 輸出限制與參數 | 20% | 24/30 | — | 80.00 |
| 上下文與狀態 | 15% | 14/30 | — | 46.67 |
| 錯誤與復原 | 15% | 21/30 | — | 70.00 |
| 計量與快取通訊協定 | 10% | 12/27 | 3 | 44.44 |
| 合計 · 加權分數 | — | 124/174 | 6 | 74.98 |
「失敗視窗數」表示 3 個視窗中有幾個未通過檢查。
| 失敗案例 | 失敗視窗數 | 原因 |
|---|---|---|
| 推理內容不應混入回答內容 — 串流與訊息通訊協定 | 3/3 | 設定 reasoning_effort=none 後,仍回傳了思考內容 |
| 思考設定生效 — 輸出限制與參數 | 3/3 | 設定 reasoning_effort=none 後,仍回傳了思考內容 |
| 取樣多樣性 — 輸出限制與參數 | 3/3 | temperature 設為 0 和 1 時,輸出差異不夠大,低於預先登錄的門檻 |
| 10k 長輸入 — 上下文與狀態 | 3/3 | 輸入回報為 10,026 tokens;原生計數應為 10,000 |
| 未超過上下文限制 — 上下文與狀態 | 3/3 | 輸入回報為 10,026 tokens;原生計數應為 10,000 |
| 32k 長輸入 — 上下文與狀態 | 3/3 | 輸入回報為 10,026 tokens;原生計數應為 10,000 |
| 100k 長輸入 — 上下文與狀態 | 3/3 | 輸入回報為 10,026 tokens;原生計數應為 10,000 |
| 超出上下文限制 — 上下文與狀態 | 3/3 | 上游連線失敗或逾時 (1);應回傳參數錯誤,實際回傳 200 (2) |
| 12 輪對話紀錄 — 上下文與狀態 | 1/3 | 上游連線失敗或逾時 |
| messages 格式錯誤 — 錯誤與復原 | 3/3 | 回傳 400,但內文為空;沒有結構化錯誤說明 |
| 無對應呼叫的工具結果 — 錯誤與復原 | 3/3 | 應回傳參數錯誤,實際回傳 200 |
| stream_options 格式錯誤 — 錯誤與復原 | 3/3 | 回傳 400,但內文為空;沒有結構化錯誤說明 |
| 思考 token 計量 — 計量與快取通訊協定 | 3/3 | 關閉思考模式後仍回報思考 token |
| 原生輸入計數 — 計量與快取通訊協定 | 3/3 | 回報 34 tokens;原生計數應為 8 |
| 工具定義計入輸入 — 計量與快取通訊協定 | 3/3 | 不含工具的對照請求,其輸入計數已與原生計數不符 |
| 快取前後的輸入計數一致 — 計量與快取通訊協定 | 3/3 | 重複使用相同前綴時,回報的輸入 token 數與原生計數不符 |
| 串流與非串流的輸入計數一致 — 計量與快取通訊協定 | 3/3 | 兩者都回報 34 tokens;原生計數應為 8 |
| 精確文字輸出 — 串流與訊息通訊協定 | 1/3 | 本文末尾多了一個句點,不符合要求的精確文字 |
這些檢查會從分母中排除,不計為通過或失敗。
| 狀態 | 案例 | 數量 | 原因 |
|---|---|---|---|
| 未觀察到 | 串流停止序列 | 3 | 前一個步驟之後未送出此請求;無法判定 |
| 不適用 | 明確指定 cache_control | 3 | 事先登記為此介面不支援 |
messages 格式錯誤和 stream_options 格式錯誤這兩個案例在五家供應商上都失敗:兩者皆回傳 400,但內文為空,因此用戶端無法取得結構化錯誤說明。五家都發生的失敗較可能出現在 AIHubMix 閘道層,需另行調查。五家在思考 token 計量上也都未通過,但原因不同:ByteDance 和 Fireworks 在關閉思考模式後仍回報思考 token;另外三家則未回傳思考 token 計數。
與其他四家比較
P — 回應速度:84.37
每次請求都包含約 10,000 個輸入 token,並要求產生約 1,100 個 token 的本文。在三個視窗中,每個視窗分別以單一併發和 10 路併發執行 30 次請求:總計 180 次。
| 指標 | 結果 |
|---|---|
| 等待第一個本文 token(TTFA) | 單一併發中位數 2.12 s;10 路併發中位數 2.10 s |
| 生成速度(TPOT) | 單一併發為 3.43 ms/token;10 路併發為 3.41 ms/token |
| 有效輸出量 | 10 路併發時為 1,250.0 token/s |
| 有效請求 | 單一併發 90/90;10 路併發 90/90 |
| 組成分數 | TTFA 48.59、TPOT 100.00、有效輸出量 100.00;TTFA 和 TPOT 採用兩個級別中較低者;權重為 35% / 35% / 30%;回應分數 82.00 |
| P 分數 | 回應分數 82.00,占 80%;快取 K 93.83,占 20%;總分 84.37 |
TPOT 是根據串流區塊估算,並非在硬體上逐 token 測量。有效輸出量是以 10 路併發執行時的有效輸出 token 數除以批次耗時。
與其他四家比較
五家共用同一台機器、網路和帳戶。三個視窗按供應商依序排程,因此資料收集時段並未完全重疊;不宜過度解讀細微差異。
K — 快取:93.83
每組會送出五次請求。第一次請求包含約 8k 或 32k token 的固定前綴,並用來建立快取。第 2–4 次請求保留前綴,只更換最後的問題,分別間隔 5 s、30 s 和 120 s。第五次使用新的前綴作為冷快取對照。三個視窗各測兩種長度,每組五次請求,共 30 次。K 是熱請求的快取讀取 token 數除以依規則應可重用的 token 數,兩種長度採相同權重;K 占 P 的 20%。
| 前綴 | 視窗 | 種子請求 | +5 s | +30 s | +120 s | 冷快取對照 |
|---|---|---|---|---|---|---|
| 8k | 視窗 1 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | 視窗 2 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | 視窗 3 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 32k | 視窗 1 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| 32k | 視窗 2 | 0 | 32,000 | 32,000 | 失敗 | 0 |
| 32k | 視窗 3 | 0 | 32,000 | 32,000 | 32,000 | 0 |
數值為伺服器回報的快取讀取 token 數。
9 次 8k 熱請求全數命中,每次讀取 7,936 個 token。9 次 32k 熱請求中有 8 次命中,每次讀取 32,000 個 token;有 1 次請求失敗。兩種長度以相同權重計算後,K 為 93.83。冷請求不會讀取快取,因此熱請求與冷請求可清楚區分。失敗的請求是視窗 2 中 32k 組的第 4 次請求,等待至 300 s 截止時間仍未完成。
與其他四家相比
R — 服務穩定性:100
300 次請求分為四種類型——短文本、長輸入、工具呼叫和多輪對話歷史,並在三個視窗中以單一併發執行。只有第一次嘗試就返回有效且完整回應的請求才算成功;不檢查答案正確性,也不重試。答案品質和速度部分的失敗會計入 Q 和 P,不會再次計入 R。
| 請求類型 | 首次嘗試成功率 |
|---|---|
| 短文本 | 120/120 |
| 10k 長輸入 | 90/90 |
| 工具呼叫 | 60/60 |
| 多輪對話歷史 | 30/30 |
| 總計 · 95% 信賴區間 98.78%–100% | 300/300 |
300 次請求都在首次嘗試時返回有效且完整的回應。R = 100 僅描述這 300 次專門測試的請求,不代表整個測試流程沒有失敗。95% 信賴區間的下限為 98.78%:300 次成功只能說明失敗率很可能低於 1.22%。
與其他四家相比
R 僅涵蓋這 300 次專門測試的請求;答案品質和速度部分的失敗會記錄在 Q 和 P 中,不會再次計入 R。
| 供應商 | 首次嘗試成功率 | 95% 信賴區間 |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek 官方 | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
常見問題
reasoning_effort=none 是否真的沒有關閉思考模式?
是。在三個視窗中,使用 reasoning_effort=none 的請求仍會傳回思考內容,因此這項檢查 3 次全數未通過。答案品質、速度、快取和穩定性請求則改用原生的 thinking.type=disabled 開關。函式測試刻意保留 reasoning_effort=none,用來測試這個參數是否生效。
BFCL 準確率為 85.20%,為什麼 Q 只有 42.05?
Q 合併了三組難度差異很大的測試。BFCL 答對 1,500 題中的 1,278 題,HLE 答對 2,490 題中的 382 題,AA-LCR 則答對 250 題中的 123 題。合計而言,4,240 個計分題目中答對 1,783 題,準確率為 42.05%。HLE 的 15.34% 拉低了合併後的數值。
Q 的 35 次服務失敗有計入分數嗎?
有。請求失敗和輸出遭截斷都會保留在分母中,並視為答錯。7 個 HLE 答案因達到 max_tokens 而遭截斷;28 次 AA-LCR 請求失敗,且全部發生在視窗 1。
為什麼輸入 token 計數很重要?
因為計費應與模型原生計數一致。10k-token 輸入被回報為 10,026 個 token(原生計數為 10,000),而 8-token 輸入則被回報為 34 個。未使用工具的控制請求也已出現差異,而且串流與非串流都回報 34 個。5 項計費檢查有 3 項未通過。
32k 快取結果是未命中還是請求失敗?
是請求失敗。9 次 32k 熱請求中有 8 次命中,並讀取 32,000 個 token。未命中的那次是視窗 2 中的第 4 次請求,等待至 300 s 截止時間仍未完成。8k 組則有 9 次全數命中,每次讀取 7,936 個 token。
ByteDance 的答案品質與官方管道有可區分的差異嗎?
沒有。合併後的準確率比官方管道低 0.40 個百分點,95% 信賴區間為 −1.46 至 +0.66。區間包含 0,因此兩者無法區分。這僅描述本批測試結果,不代表排名。
繼續閱讀:DeepSeek V4.1 Flash 系列
- 本文 Q 的基準值採用官方管道;官方管道本身的測試結果,包括 15 次無效的單一併發探測,請見 官方管道上的 DeepSeek V4.1 Flash:94.00 F、15 次無效探測。
- Baidu 是唯一一家 Q 信賴區間低於官方管道的供應商;造成該結果的管道失敗詳見 Baidu 上的 DeepSeek V4.1 Flash:沒有可用管道達到 Q 和 P。
- Alibaba Cloud 的快取數據可與本文回報的 93.83 一併參考:Alibaba Cloud 上的 DeepSeek V4.1 Flash:首 token 1.34s、快取 99.37。
- Fireworks 也出現本文提到的思考模式和 token 計數失敗,另外還有空白的停止回覆:Fireworks 上的 DeepSeek V4.1 Flash:空白停止回覆、快取命中 3/9。


