只接入一个大语言模型,足以让应用生成文本,但还不足以让 AI 智能体完成真实世界的任务。
如果让模型总结已经在其上下文中的文档,只需要模型层就够了。但如果要求它比较今天的竞争对手价格、丰富某家公司的记录、检查某个社交账号,或为一项陌生任务选择最合适的 API,那么缺失的另一半就很明显了:智能体需要一种可靠的方式来访问外部系统。
因此,生产环境中的智能体需要做出两个相互独立的决策:
- 这一步应该由哪个模型处理?
- 应该由哪个工具或 API 提供数据或执行操作?
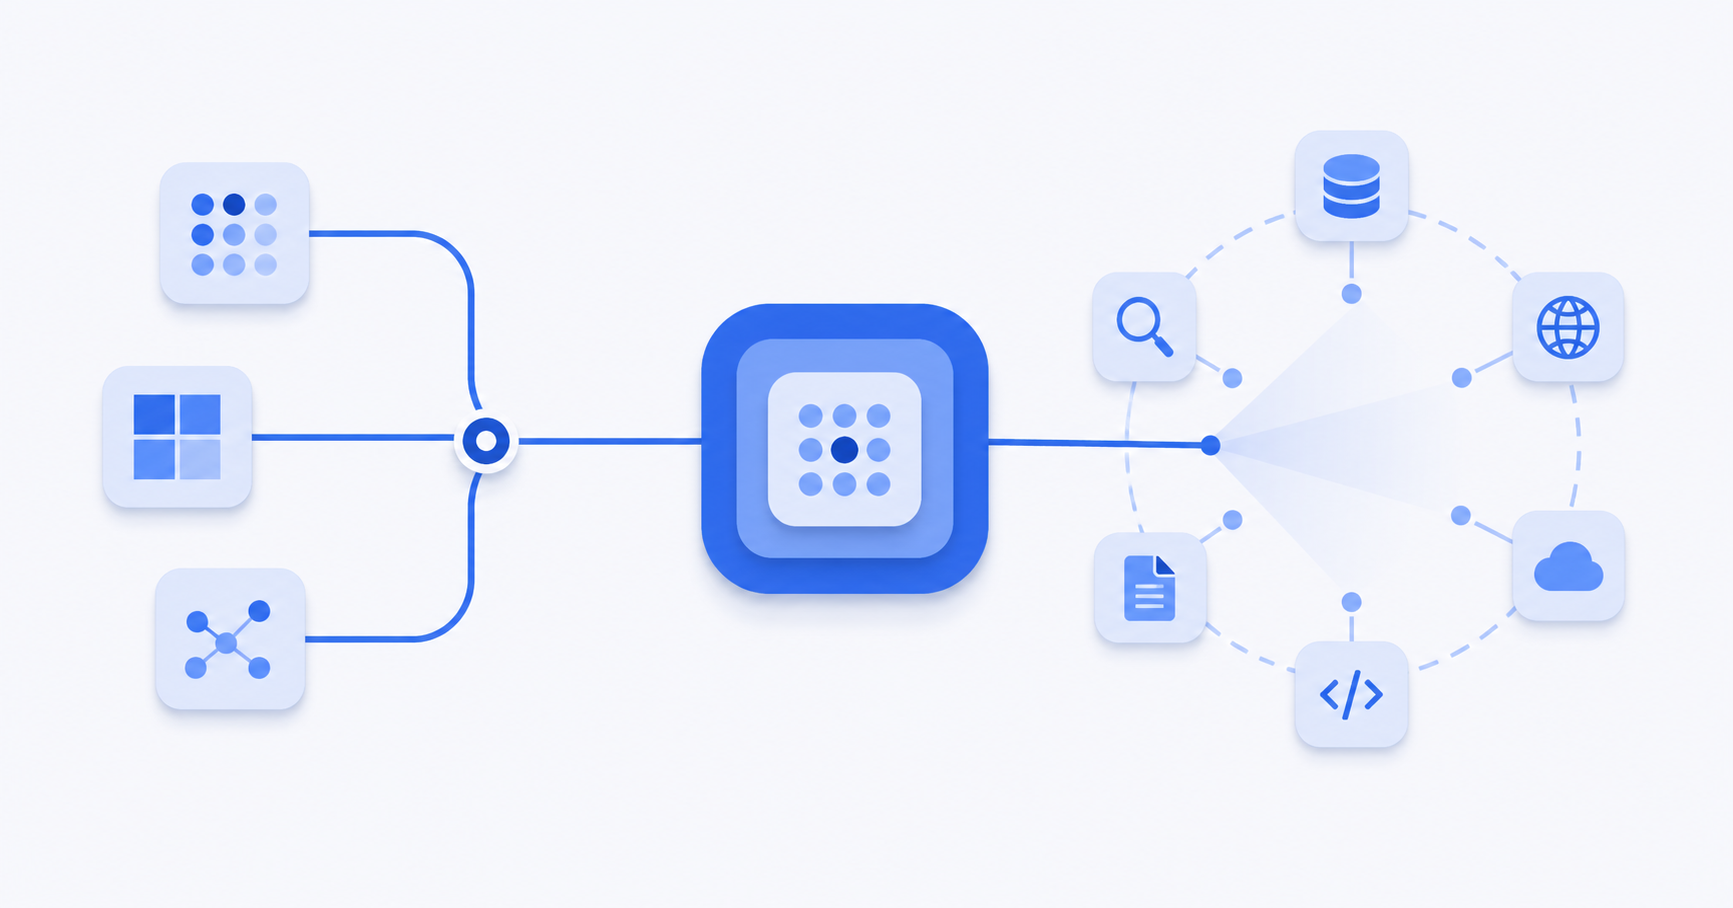
AIHubMix 通过统一的模型访问和请求级模型路由解决第一个决策;Monid 通过运行时工具发现、Schema 检查和按调用付费的执行解决第二个决策。两个产品位于同一架构的不同层级。
披露说明:本文是与 Monid 合作内容的一部分。AIHubMix 是下文讨论的模型平台,Monid 是工具平台。两者均可独立使用。
AI 智能体内部的两个路由问题
一次智能体运行很少只是一次同质的模型调用。一个研究型智能体可能需要先对请求进行分类,再搜索最新信息、提取结构化事实、比较结果,最后撰写最终答案。这些步骤需要不同的能力。
模型之外的情况也是如此。一项公司调研任务今天可能需要搜索 API,明天需要公司信息补全接口,下周又需要浏览器自动化工具。如果每个模型和工具都在构建时硬编码,那么每个新任务都会变成一个集成项目。
这两个层级是并行的:
| 模型层 | 工具层 | |
|---|---|---|
| 核心决策 | 应该由哪个模型回答? | 应该调用哪个 API? |
| 选择时机 | 每次请求时 | 每个任务,在运行时 |
| 输入 | 提示词、模态、质量和延迟需求 | 目标、所需数据或操作、Schema 和价格 |
| 输出 | 一次模型补全结果 | 外部数据或已执行的操作 |
| 示例 | AIHubMix | Monid |
这种分离很重要。更好的模型无法让系统获得实时数据,而更大的工具目录也无法对其返回的数据进行推理。智能体需要两种能力,并在两者之间建立清晰的契约。
Monid 在为什么 AI 智能体需要两种集成一文中介绍了互补的工具侧视角。从模型侧来看,架构上的结论是相同的:保持模型选择与工具选择相互独立,然后分别针对各自的任务进行优化。
为什么在智能体循环中固定使用一个模型会变得昂贵
处处使用同一个模型看起来很简单。但实际上,这会迫使每个步骤都接受同一种在能力、延迟和价格之间的权衡。
以一个市场调研智能体为例:
- 意图分类简短且机械。
- 工具选择需要可靠的指令遵循能力。
- 从返回的 JSON 中提取字段,主要是数据转换工作。
- 最终报告可能需要更强的推理能力和更好的写作水平。
如果把这四个步骤都交给能力最强的模型,就会在日常性工作上浪费钱;如果都交给最便宜的模型,又可能降低用户唯一会阅读的输出质量。随着智能体循环不断增长,这种折中会在每一次调用中重复出现。
AIHubMix 提供一个与 OpenAI 兼容的端点,覆盖广泛的模型目录。现有的 OpenAI SDK 集成只需更改 API 密钥和 base_url,即可指向 AIHubMix:
from openai import OpenAI

client = OpenAI(
    api_key="<AIHUBMIX_API_KEY>",
    base_url="https://aihubmix.com/v1",
)

response = client.chat.completions.create(
    model="auto:balanced",
    messages=[
        {"role": "user", "content": "Classify this request and propose the next step."}
    ],
)
将 model 设置为 auto,即可把模型选择移入请求路径。路由器会分析任务,并将其解析为合适的模型。策略后缀则明确了优化目标:
| 路由策略 | 优先级 | 典型智能体步骤 |
|---|---|---|
auto |
成本优先 | 批量任务和日常转换工作 |
auto:balanced |
能力、成本与延迟 | 通用型智能体工作 |
auto:quality_first |
能力优先 | 复杂推理和最终交付物 |
auto:latency_critical |
速度优先 | 交互式循环和轻量级规划 |
路由本身不产生额外费用。请求按实际处理该请求的模型的标价计费。解析出的模型和路由详情会在响应中显示,包括 X-Aihubmix-Router-Resolved-Model 响应头,因此路由决策可被观察,而不会成为黑盒。
完整的行为说明、支持的端点、策略以及当前限制,均记录在 AIHubMix LLM 路由器指南中。
模型路由无法为智能体提供实时数据
配置模型路由后,智能体可以为每个步骤选择更合适的“大脑”。但除非工具提供相应能力,它仍然无法知道模型训练数据之后发生了哪些变化、无法访问私有业务系统,也无法在其他应用中执行操作。
许多智能体项目正是在这里积累起脆弱的代码。团队先接入一个搜索 API,再接入一个抓取 API,然后又接入一个信息补全 API。每次集成都会引入新的账户、凭证、请求格式、错误模型和计费关系。工具描述往往被复制到系统提示词中,并逐渐过时。
这种失败模式很危险,因为它看起来可能是成功的。模型可能会针对过时的 Schema 发出一个看似合理的调用,收到不完整的响应,然后仍然像任务已经成功一样继续执行。与其让模型记住来自训练数据或旧提示词中的 API 契约,不如在运行时检查 Schema 更加安全。
因此,工具层应在执行前回答三个问题:
- 哪个工具可以满足这一目标?
- 当前适用的 Schema 和价格是什么?
- 这次调用实际返回了什么结果?
工具发现是第二个路由层
Monid 将工具访问变成一个“发现—检查—运行”的工作流。开发者无需预先预测智能体可能需要的每一个 API,智能体可以用自然语言搜索目录、检查候选工具的契约,然后执行所选端点。
基本流程如下:
# 1. Find tools that match the goal
monid discover -q "find current product pricing from a public web page"

# 2. Read the selected endpoint's schema and pricing
monid inspect -p PROVIDER_SLUG -e ENDPOINT_PATH

# 3. Execute only after the agent has checked the contract
monid run -p PROVIDER_SLUG -e ENDPOINT_PATH \
  --query '{"url":"https://example.com/product"}'
发现和检查让智能体能够在花费任何费用之前比较各个选项。执行则按所选端点的计费模式收费。开发者只需保留一个集成,智能体就能访问多个服务商的工具。
对于能够读取设置说明的智能体运行时,Monid 还提供了一个机器可读的 Skill:
Set up https://monid.ai/SKILL.md
Monid 工作流文档更详细地解释了目录、检查和执行这几个阶段。
两层如何协同工作
模型网关和工具层应保持为独立组件,并通过一个小而明确的交接点相互配合:
- 智能体接收用户目标。
- AIHubMix 将规划调用路由到合适的模型。
- 规划结果会识别缺失的信息或所需的外部操作。
- Monid 发现候选工具,并展示其 Schema 和价格。
- 智能体在其权限和预算范围内选择并运行工具。
- 工具返回事实或操作结果。
- AIHubMix 根据所需的质量、成本或延迟,路由综合调用。
- 智能体返回一个以工具结果为依据的答案。
在简化的 Python 示例中,模型侧的调用可以保持不变,同时将工具结果作为上下文插入:
from openai import OpenAI

client = OpenAI(
    api_key="<AIHUBMIX_API_KEY>",
    base_url="https://aihubmix.com/v1",
)

# A fast model is sufficient for a lightweight planning step.
plan = client.chat.completions.create(
    model="auto:latency_critical",
    messages=[
        {
            "role": "user",
            "content": "Plan how to compare the current prices of these products.",
        }
    ],
)

# Your agent uses Monid to discover, inspect, and run an appropriate tool.
# Replace these placeholders with the structured result returned by that call.
tool_result = {
    "source": "<source-url>",
    "data": "<structured-tool-result>",
}

report = client.chat.completions.create(
    model="auto:quality_first",
    messages=[
        {
            "role": "system",
            "content": (
                "Write a concise comparison. Use only the supplied tool result, "
                "preserve source URLs, and state when a value is missing."
            ),
        },
        {"role": "user", "content": str(tool_result)},
    ],
)
关键不在于代码行数,而在于两种选择都不需要永久嵌入应用逻辑中。提示词变化时模型可以更换,任务变化时工具也可以更换。
成本控制应同时作用于两个层级
模型成本和工具成本使用不同的计量单位,因此应分别进行衡量。
在模型层,实际解析出的模型决定了 Token 定价。AIHubMix 让这一决策可追溯,并允许开发者选择路由策略,或限制某个 API 密钥可使用的模型。日常步骤可以优先考虑成本或延迟,而面向用户的输出则可以优先考虑质量。
在工具层,端点可能按每次调用或按每个结果收费。Monid 在检查阶段、执行之前就展示价格。智能体可以拒绝超出预算的端点,优先选择经过验证的选项,或在执行异常昂贵的操作前请求批准。
实用的生产环境控制措施包括:
- 为每个 API 密钥设置模型白名单或价格上限。
- 为每个任务设置最大工具调用预算。
- 针对受监管数据,设置服务商或端点白名单。
- 记录日志,将模型路由决策与工具调用及最终答案关联起来。
- 在执行不可逆或敏感操作前,要求明确确认。
- 对输出进行校验,将工具数据视为不可信输入,而不是指令。
这种拆分也让成本调试更容易。如果某次运行变得昂贵,Token 日志可以显示智能体是否推理过度,而工具日志则可以显示它是否获取了过多数据。两者的修复方式不同,架构应当保留这种区分。
可靠性需要新鲜的契约和可见的决策
动态选择不应意味着行为不可预测。
在模型侧,AIHubMix 会报告每个请求所解析出的模型和路由策略。会话粘性可以在多轮工作中保持模型的一致性和提示词缓存的收益,而在必要时,回退机制可以切换离开不健康的模型。
在工具侧,智能体在进行付费调用之前会检查当前端点的 Schema。发现结果包含比较候选工具所需的信息,而实际调用的结果则成为传入最终补全的唯一外部证据。
这些控制措施共同形成一条有用的审计轨迹:
user goal
  -> routing decision and resolved model
  -> discovered tool candidates
  -> inspected schema and price
  -> selected endpoint and result
  -> final model decision and grounded response
这条轨迹比单纯能够访问大量模型或大量 API 更有价值。它能够解释智能体为何做出每个选择,以及哪些证据支撑了它的答案。
何时不需要两层架构
并非每个工作流都能从运行时选择中受益。
如果应用只将一个稳定的提示词发送给一个经过基准测试的模型,那么直接指定该模型比路由更简单、也更具确定性。如果某个定时流水线总是调用一个已知的 API,那么直接集成该 API 可能比增加发现层更清晰。
当工作负载本身具有多样性时,两层架构才会体现其价值:
- 各个步骤的提示词差异足够大,以至于最佳模型会随步骤而变化。
- 智能体会进行多次模型调用,因此需要控制累计成本或延迟。
- 所需工具无法在构建时完全预先确定。
- 外部数据必须是最新的,并且其来源必须可见。
- 团队希望增加新能力,但不希望为每项能力都新增一次供应商集成。
根据应用实际需要做出的决策,选择使用模型层、工具层,或两者同时使用。
围绕决策而非依赖来构建智能体
一个可投入生产的 AI 智能体,并不取决于它能够接入多少模型或 API。关键在于它能否为当前步骤选择合适的能力、在预算范围内运行,并能解释发生了什么。
AIHubMix 为智能体提供统一的模型端点,并可在请求时根据成本、质量和延迟优先级进行路由。Monid 则为其提供运行时工具发现、最新的 schema、可见的定价,以及跨外部服务商的执行能力。
一层决定智能体如何思考,另一层决定它如何获取信息并采取行动。将这两类决策分开,可以让智能体更易于扩展、观测和控制。
先阅读AIHubMix 快速入门,然后通过Monid接入工具端。
常见问题
什么是 AI 智能体的模型路由?
模型路由会根据任务类型、能力、成本和延迟等因素,为每个请求选择合适的模型。使用 AIHubMix 时,将model设为auto,或设为auto:quality_first等策略,即可在保持 OpenAI 兼容 API 的同时,实现请求时选择。
如果 LLM 本身已经具备知识,为什么 AI 智能体还需要工具?
LLM 基于接收到的上下文以及训练期间学到的知识生成回答。如果没有连接工具,它无法可靠地获知当前价格、查询私有数据库或执行外部操作。工具提供实时数据和执行能力,模型则负责规划并解读结果。
模型网关与 MCP 服务器或工具平台是同一回事吗?
不是。模型网关负责将推理请求路由到模型。MCP 服务器和工具平台则向智能体暴露外部能力。它们解决的是互补的集成问题,可以同时使用。
AIHubMix 和 Monid 能否独立使用?
可以。对于没有动态工具需求的应用,AIHubMix 可以单独路由模型调用。Monid 则可以为使用其他模型服务商或网关的智能体提供工具发现能力。当智能体需要在两个层面都进行运行时选择时,同时使用两者会很有帮助。
如何让自动路由保持可审计?
为每个任务记录已解析的模型、路由策略、工具候选项、查询到的价格、所选端点以及返回结果。AIHubMix 会在响应中提供模型路由详情,而 Monid 将发现与检查和执行分开,因此可以在付费调用之前记录工具决策。