2026年8月4日,DeepSeek 官方状态页记录了两起 API 性能降级事件。
这次第一起事件持续了 1 小时 18 分钟,从 UTC 时间 02:02 到 03:20,影响了 DeepSeek V4 Flash、V4 Pro 以及 Expert Mode。第二起事件持续了 36 分钟,从 UTC 时间 03:43 到 04:20,影响了 DeepSeek V4 Flash API。
两起事件现已解决。OpenCode 还报告称,由于需求空前增长,DeepSeek Flash 出现了容量问题。不过,DeepSeek 官方状态页只确认了性能降级,并未公布根本原因。
要点速览
- 2026年8月4日,DeepSeek 官方状态页记录了两起影响 V4 Flash 的性能降级事件。
- 直接对接单一供应商会形成单点故障,即使同一模型在其他地方也可用。
- 当上游路由返回可重试错误时,AIHubMix 可以在多个供应商通道之间对同一模型进行重试。
- 如果主模型的所有供应商通道都失败,按 Key 配置的模型回退可以将请求切换到已配置的备用模型。
- 多供应商路由降低了对单一端点的依赖,但无法消除相关性故障或网关层面的风险。
此类事件凸显了一个重要的基础设施原则:
如果模型只通过单一供应商端点访问,即使它本身很可靠,也还不够。
一个模型不必只对应一个供应商
当应用直接连接某一个供应商时,该端点就成了单点故障。
如果供应商出现宕机、触发速率限制或延迟飙升,应用就无处可发送请求。即使同一模型在其他基础设施供应商处仍可用,用户也会看到超时和错误。
AIHubMix 将模型与提供该模型的供应商分离开来。
例如,DeepSeek V4 Flash 在 AIHubMix 上可通过多个供应商获取,包括 DeepSeek、百度、DeepInfra 和阿里云。应用只需继续使用一个 OpenAI 兼容的 API 端点,AIHubMix 会负责管理可用的上游路由。
这形成了两个相互独立的可靠性层。
第一层:供应商故障切换
供应商故障切换会保持所请求的模型不变,只切换其背后的基础设施供应商。
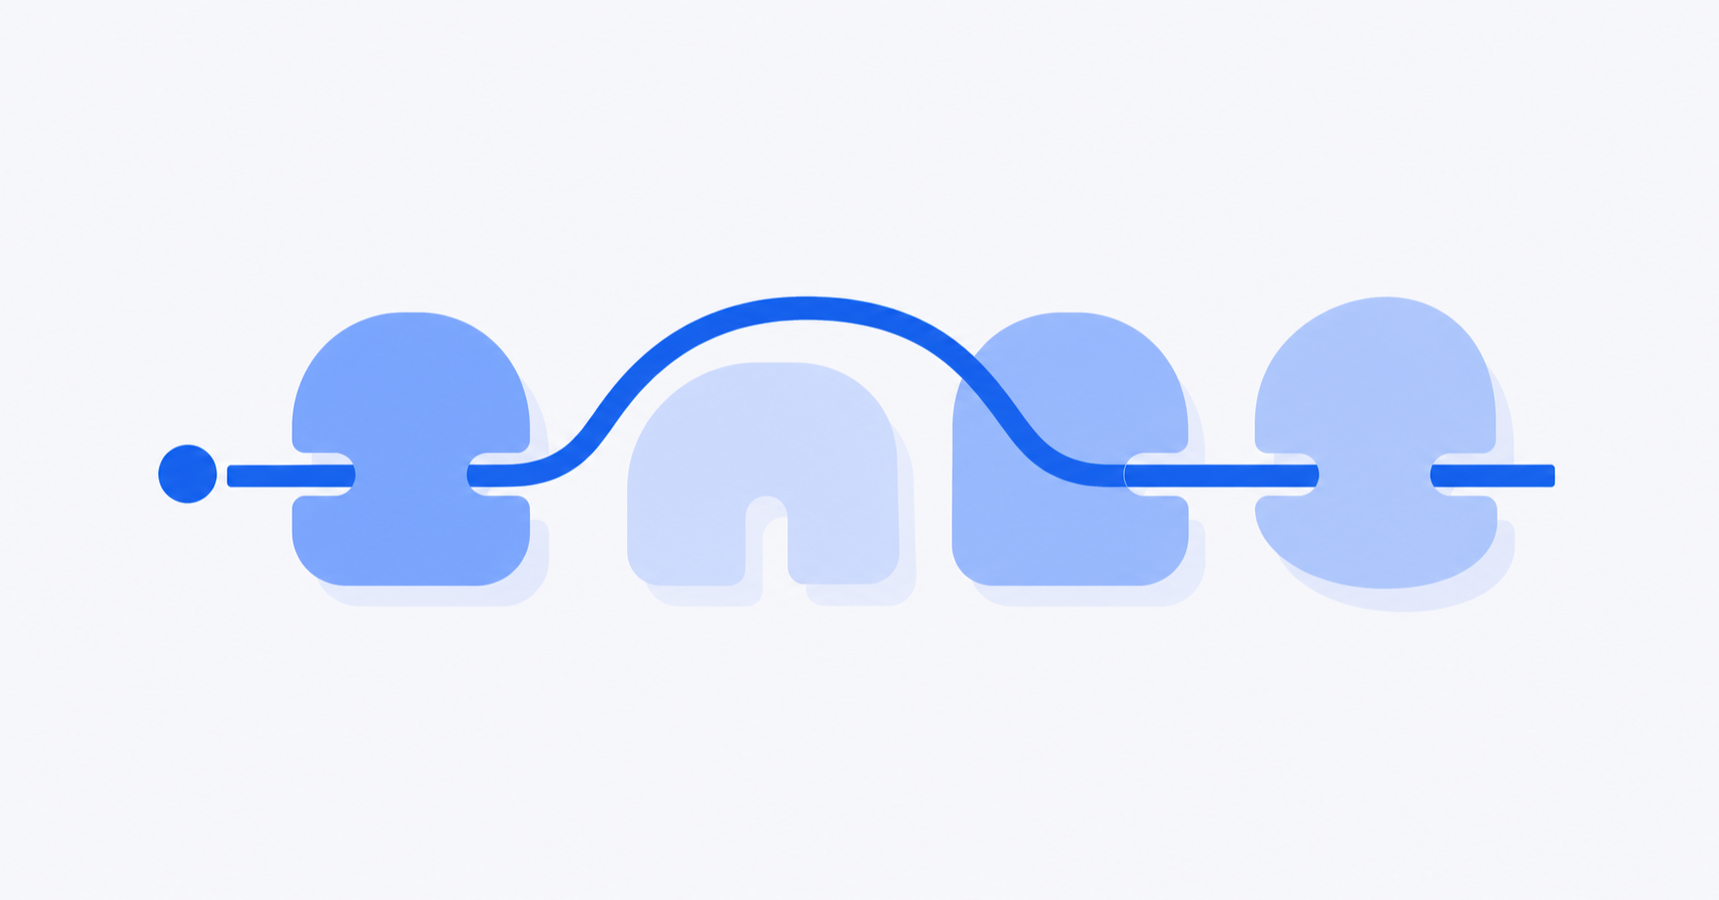
当对 DeepSeek V4 Flash 的请求到达 AIHubMix 时,网关会选择一个符合条件的供应商通道。如果该通道在响应开始前返回可重试错误,AIHubMix 可以尝试同一模型的另一个可用通道。
请求路径可能如下所示:
- 通过供应商 A 调用 DeepSeek V4 Flash。
- 供应商 A 返回超时、5xx 错误或可重试的容量错误。
- 通过供应商 B 调用同一个 DeepSeek V4 Flash 模型。
- 持续尝试,直到请求成功或所有符合条件的通道都已用尽。
客户端无需集成多个供应商的 SDK、管理多组 API 密钥,也无需自行实现重试逻辑。
这就是供应商级故障切换:供应商发生变化,但请求的模型保持不变。
第二层:模型回退
如果主模型的所有可用供应商都不可用,供应商故障切换也无能为力。
因此,AIHubMix 提供了第二个可靠性层:模型回退。
用户可以为每个 API 密钥配置一个有序的备用模型列表。当主模型的每个符合条件的通道都返回了可重试的失败后,AIHubMix 会切换到回退列表中的下一个模型。
例如:
- 主模型:
deepseek-v4-flash - 第一备用模型:
gpt-5.4 - 第二备用模型:
gemini-3.1-pro-preview
回退在 AIHubMix 网关内部完成。现有应用无需发送额外的路由参数,也无需修改客户端代码。
计费依据是最终返回成功响应的模型。开发者可以通过响应头验证回退行为:
X-Aihubmix-Fallback: trueX-Aihubmix-Model: <final-model>
完整的配置和触发规则记录在 AIHubMix 模型映射与回退 文档中。
自动故障切换能处理哪些情况
供应商故障切换旨在从以下上游基础设施问题中恢复:
- 供应商超时
- 连接失败
- 可重试的 5xx 响应
- 供应商速率限制和容量错误
- 上游通道暂时不可用
当这些故障在响应开始前发生时,AIHubMix 可以透明地尝试另一条路由。
故障切换无法解决的问题
多供应商路由提高了可用性,但并不能让网关永不出错。
在以下情况下不会触发回退:
- 用户的 AIHubMix API 密钥无效、已过期或额度已用尽
- 请求本身无效
- 客户端断开连接或达到其自身的超时时间
- 流式响应已经开始
- 明确指定了某个特定的供应商通道
- 故障影响所有供应商或网关本身
供应商故障也可能存在相关性。多个供应商可能依赖相同的底层基础设施、同一模型版本或同一区域网络。因此,多供应商的可用性应通过真实流量来衡量,而不应仅凭供应商数量来推断。
为什么聚合网关可能比直连端点更可靠
直接调用官方 API,应用只有一条通往模型的路由。
多供应商网关则为应用提供了多条路由。
如果这些供应商路由彼此独立地发生故障,网关就可以绕开降级的端点,而不会把故障暴露给应用。这降低了对任何单一供应商的依赖,并可能比直连单一供应商提供更高的可用性。
两者的区别在于架构:
- 直连 API:一个模型、一个供应商、一个故障域
- AIHubMix:一个模型、多个供应商、自动故障切换
- AIHubMix 加模型回退:多个供应商加备用模型
目标不是预测下一个会出故障的供应商,而是让上游故障变成内部的路由事件,而不是面向客户的服务中断。
为下一次供应商故障做好准备
DeepSeek V4 Flash 已经恢复,但临时的容量限制、速率限制和上游中断是生产级 AI 基础设施的常态。
应用不应因为某个供应商变得不稳定,就每次都要修改代码。
借助 AIHubMix,开发者可以通过一个 API 访问多个供应商,在可用通道之间自动重试同一模型,并配置备用模型,获得额外一层保护。
请访问 aihubmix.com/models 浏览可用的模型和供应商。
常见问题
什么是多供应商故障切换?
当当前路由返回可重试的失败时,它会自动通过另一个符合条件的供应商重试同一模型。
模型回退有什么不同?
供应商故障切换保持模型不变。只有当主模型的所有符合条件的通道都失败后,模型回退才会切换到已配置的备用模型。
哪些故障会触发故障切换?
典型的触发条件包括超时、连接失败、可重试的 5xx 响应、速率限制,以及在响应开始前出现的临时容量错误。
故障切换能保证零停机吗?
不能。相关性的供应商故障、网关级事件、不可重试的错误,以及流式响应开始后发生的故障,仍然可能影响到客户端。
我需要修改应用代码吗?
不需要额外的路由逻辑。应用继续使用 AIHubMix 的 OpenAI 兼容端点,备用模型则可以在 API 密钥级别进行配置。