AIHubMix prowadzi własną globalną sieć akceleracji dla ruchu API. Po ocenie dostawców zewnętrznych usług akceleracji i stwierdzeniu, że ich opóźnienia i stabilność są niewystarczające dla produkcyjnych obciążeń AI, wdrożyliśmy własne węzły brzegowe, system monitorowania i harmonogramowanie ruchu. Ten wpis opisuje zmierzone wyniki i architekturę, na której się opierają.
Zmierzone wyniki
Poniższe wartości pochodzą z ciągłego monitoringu produkcyjnego, po iteracjach algorytmu harmonogramowania.
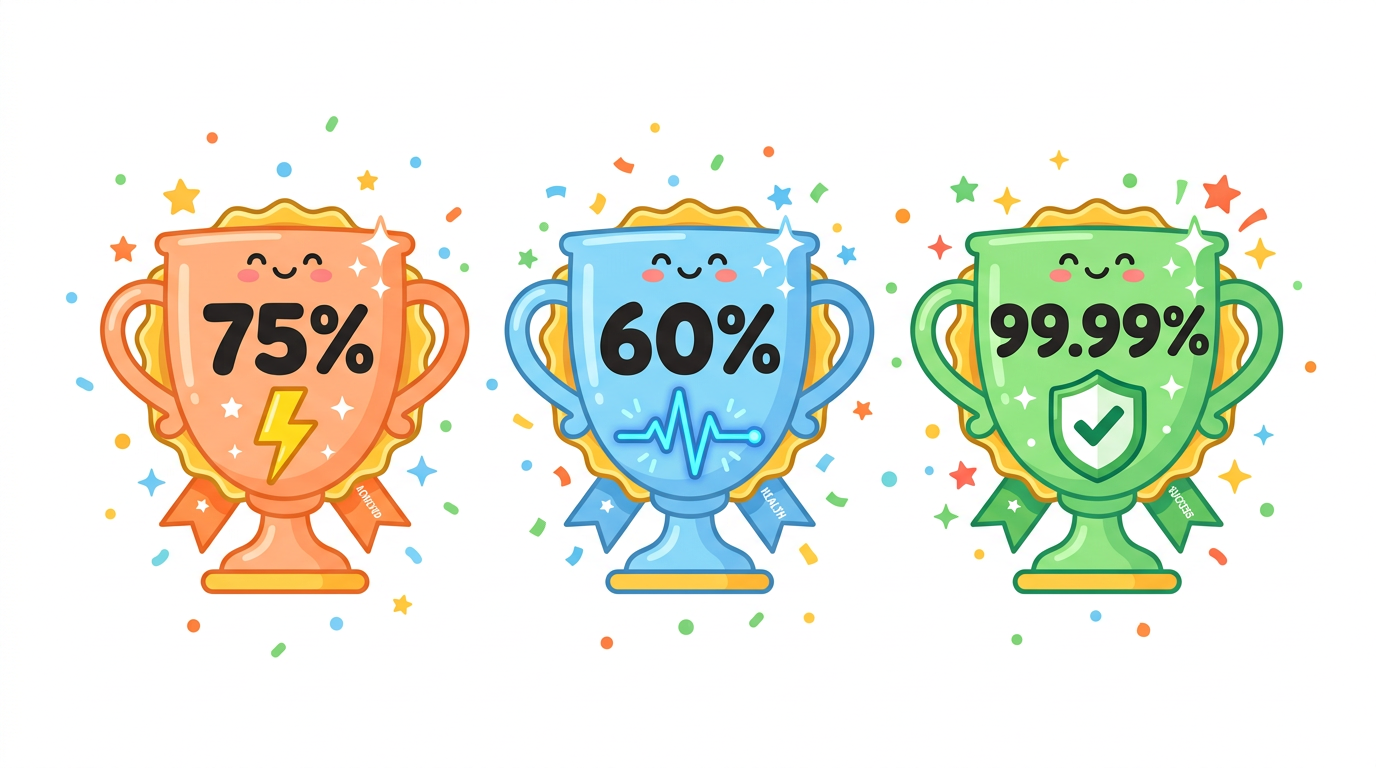
Czas odpowiedzi skrócony o 75%
Całkowite opóźnienie API (end-to-end) spadło średnio o 75%. W scenariuszach strumieniowych przede wszystkim poprawia to czas do pierwszego tokena (TTFT), czyli odstęp między wysłaniem żądania a otrzymaniem pierwszego tokena wyjściowego, który decyduje o tym, jak responsywna wydaje się aplikacja czatu.
Wahania opóźnienia zmniejszone o 60%
Wariancja opóźnienia między kolejnymi żądaniami spadła o 60%. Stabilne opóźnienia są istotne dla aplikacji produkcyjnych: utrzymują przewidywalne czasy odpowiedzi widoczne dla użytkownika i ograniczają przekroczenia czasu wynikające z opóźnień ogonowych.
Dostępność usługi na poziomie 99,99%
Dostępność zmierzona na ruchu produkcyjnym wynosi 99,99%. Jest to wynik zmierzony we wszystkich godzinach, także w weekendy i święta.
Architektura
Własne węzły brzegowe
Sieć działa na dedykowanych węzłach akceleracji rozmieszczonych w wielu regionach, niezależnie od pojedynczego łącza czy dostawcy chmury. Każdy węzeł przechodzi testy opóźnień, utraty pakietów i szczytowego obciążenia, zanim trafi na produkcję; węzły, które nie spełniają progów, są usuwane z puli. Routing wybiera najszybszą dostępną ścieżkę dla każdego wywołania API.
Monitoring stanu z sondowaniem co minutę
Rozproszone sondy w wielu regionach co minutę wykonują kompleksowe sprawdzenie stanu każdego węzła, obejmujące trzy wymiary: opóźnienie, wskaźnik sukcesu i stabilność. Cała sieć jest skanowana co 60 sekund, dzięki czemu anomalie węzłów są wykrywane w obrębie jednego cyklu sondowania.
Harmonogramowanie ruchu z automatycznym przełączaniem awaryjnym
System harmonogramowania co minutę przelicza wynik kondycji dla każdego węzła, na podstawie danych sond z czterech przesuwnych okien: 1 minuty, 5 minut, 15 minut i 1 godziny. Ruch kierowany jest do węzła o najlepszym aktualnym wyniku. Gdy węzeł się pogarsza, przełączenie na zdrowy węzeł następuje w ciągu milisekund, bez interwencji człowieka.
Automatyzacja operacji
Zarządzanie węzłami, optymalizacja tras, wdrażanie konfiguracji, rotacja certyfikatów i odzyskiwanie po awariach są w pełni zautomatyzowane. Obsługa incydentów nie zależy od czasu reakcji dyżurnego: pogorszone węzły są wycofywane z rotacji przez system harmonogramowania, gdy tylko sondy wykryją anomalię.
Co to oznacza dla Twojej aplikacji
- Niższy i bardziej stabilny TTFT w odpowiedziach strumieniowych.
- Mniej błędów przekroczenia czasu i skoków opóźnień ogonowych pod obciążeniem.
- Bez zmian w integracji: akceleracja działa automatycznie na standardowych punktach końcowych API.
FAQ
Czy muszę zmienić integrację, aby skorzystać z sieci akceleracji?
Nie. Akceleracja działa na warstwie wejściowej platformy. Istniejące punkty końcowe API, klucze i formaty żądań działają bez zmian.
Jak często sprawdzany jest stan węzłów?
Rozproszone sondy skanują każdy węzeł w sieci co 60 sekund, mierząc opóźnienie, wskaźnik sukcesu i stabilność end-to-end.
Co się dzieje, gdy węzeł się pogarsza?
System harmonogramowania co minutę przelicza wyniki kondycji z czterech przesuwnych okien (1 minuta, 5 minut, 15 minut, 1 godzina) i automatycznie przenosi ruch do zdrowych węzłów. Przełączenie awaryjne kończy się w ciągu milisekund.
Ostatnia aktualizacja: 2026-06-01