AIHubMix exploiteert een zelfgebouwd wereldwijd versnellingsnetwerk voor API-verkeer. Na de evaluatie van externe versnellingsproviders, waarvan de latentie en stabiliteit onvoldoende bleken voor productie-AI-workloads, hebben we onze eigen edge-nodes, ons monitoringsysteem en onze verkeersverdeling uitgerold. Deze post beschrijft de gemeten resultaten en de architectuur erachter.
Gemeten resultaten
De onderstaande cijfers komen uit continue productiemonitoring, na het itereren op het planningsalgoritme.
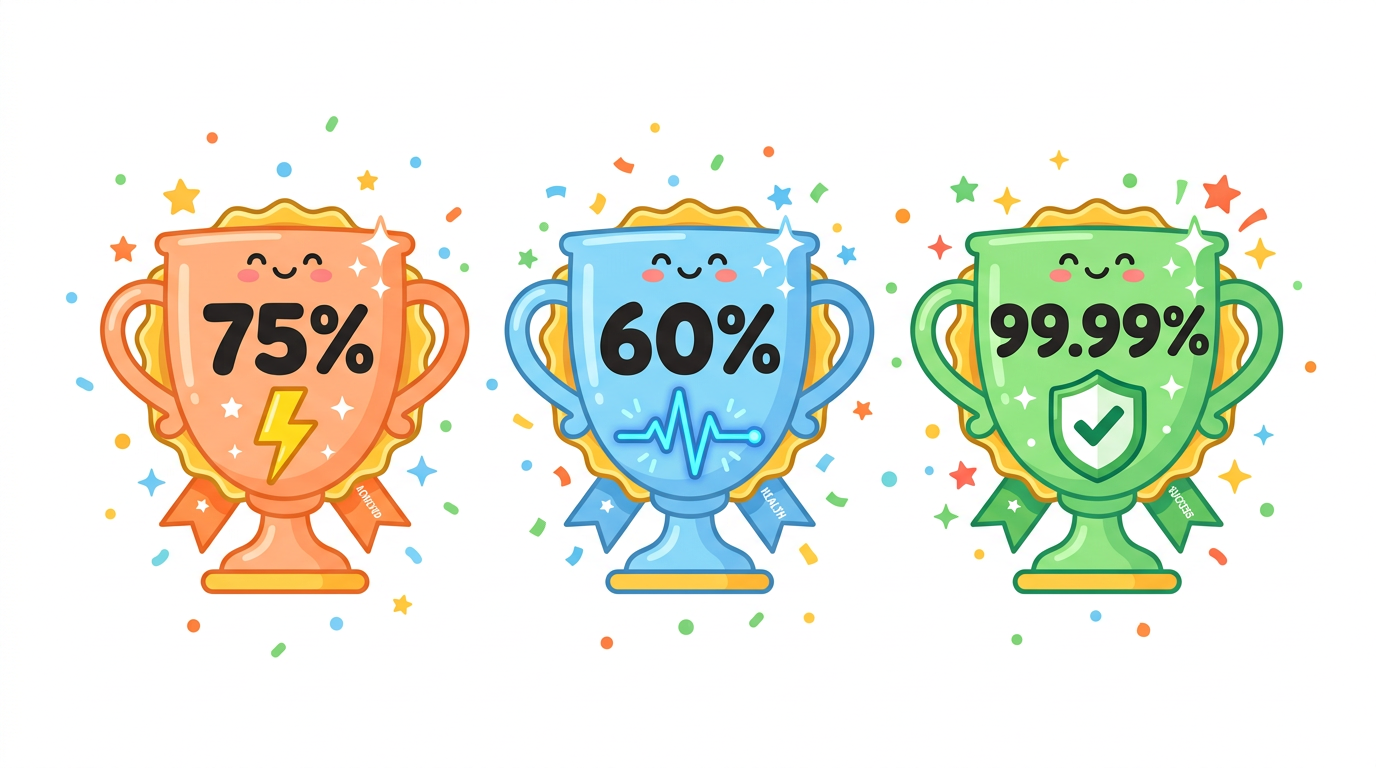
Responslatentie met 75% verlaagd
De end-to-end API-latentie daalde gemiddeld met 75%. Bij streamingscenario's verbetert dit vooral de time to first token (TTFT), het interval tussen het verzenden van een verzoek en het ontvangen van het eerste uitvoertoken, wat bepaalt hoe responsief een chattoepassing aanvoelt.
Latentieschommelingen met 60% verlaagd
De variantie van de latentie tussen opeenvolgende verzoeken daalde met 60%. Consistente latentie is belangrijk voor productietoepassingen: het houdt de responstijden voor gebruikers voorspelbaar en vermindert time-outs door langzaamste verzoeken.
Servicebeschikbaarheid van 99,99%
De beschikbaarheid, gemeten over productieverkeer, bereikt 99,99%. Dit is een gemeten cijfer dat alle uren omvat, inclusief weekenden en feestdagen.
Architectuur
Zelfgebouwde edge-nodes
Het netwerk draait op speciale versnellingsnodes die over meerdere regio's zijn verspreid en niet afhankelijk zijn van één verbinding of cloudleverancier. Elke node doorloopt benchmarks voor latentie, pakketverlies en piekbelasting voordat hij in productie gaat; nodes die de drempelwaarden niet halen, worden uit de pool verwijderd. Routering kiest voor elke API-aanroep het snelste beschikbare pad.
Gezondheidsmonitoring met probes op minutenniveau
Gedistribueerde probes in meerdere regio's voeren elke minuut een end-to-end gezondheidscontrole uit op elke node, met drie dimensies: latentie, slagingspercentage en stabiliteit. Het volledige netwerk wordt elke 60 seconden gescand, zodat afwijkingen van nodes binnen één probecyclus worden gedetecteerd.
Verkeersverdeling met automatische failover
Het planningssysteem berekent elke minuut een gezondheidsscore voor elke node, op basis van probegegevens uit vier glijdende vensters: 1 minuut, 5 minuten, 15 minuten en 1 uur. Verkeer wordt naar de node met de beste huidige score geleid. Wanneer een node achteruitgaat, verloopt de failover naar een gezonde node binnen milliseconden, zonder menselijke tussenkomst.
Geautomatiseerde operaties
Nodebeheer, routeoptimalisatie, configuratie-uitrol, certificaatrotatie en herstel na storingen zijn allemaal geautomatiseerd. Incidentafhandeling hangt niet af van de reactietijd van de wachtdienst: afgeschreven nodes worden door het planningssysteem uit de rotatie gehaald zodra de probes de afwijking detecteren.
Wat dit betekent voor uw toepassing
- Lagere en consistentere TTFT bij streamingresponses.
- Minder time-outfouten en latentiepieken onder belasting.
- Geen wijzigingen in de integratie nodig: versnelling wordt automatisch toegepast op de standaard API-endpoints.
Veelgestelde vragen
Moet ik mijn integratie aanpassen om te profiteren van het versnellingsnetwerk?
Nee. Versnelling wordt toegepast in de platforminvoerlaag. Bestaande API-endpoints, sleutels en verzoekformaten werken ongewijzigd.
Hoe vaak wordt de gezondheid van nodes gecontroleerd?
Gedistribueerde probes scannen elke 60 seconden elke node in het netwerk en meten end-to-end latentie, slagingspercentage en stabiliteit.
Wat gebeurt er wanneer een node achteruitgaat?
Het planningssysteem berekent elke minuut gezondheidsscores op basis van vier glijdende vensters (1 minuut, 5 minuten, 15 minuten, 1 uur) en verschuift verkeer automatisch naar gezonde nodes. Failover is binnen milliseconden voltooid.
Laatst bijgewerkt: 2026-06-01