LLM을 연결하는 것만으로는 애플리케이션이 텍스트를 생성하게 만들 수 있습니다. 하지만 AI 에이전트가 실제 세계의 작업을 완료하게 만들기에는 충분하지 않습니다.
문서가 이미 컨텍스트에 있는 상태에서 요약을 요청한다면 모델 계층만으로도 충분합니다. 그러나 오늘의 경쟁사 가격을 비교하거나, 기업 정보를 보강하거나, 소셜 계정을 확인하거나, 낯선 작업에 가장 적합한 API를 고르라고 요청하면 빠진 절반이 분명해집니다. 에이전트에게는 외부 시스템에 안정적으로 접근할 방법이 필요합니다.
따라서 프로덕션 에이전트는 두 가지 별도의 결정을 내립니다:
- 이 단계는 어떤 모델이 처리해야 할까?
- 데이터나 동작을 제공할 도구 또는 API는 무엇이어야 할까?
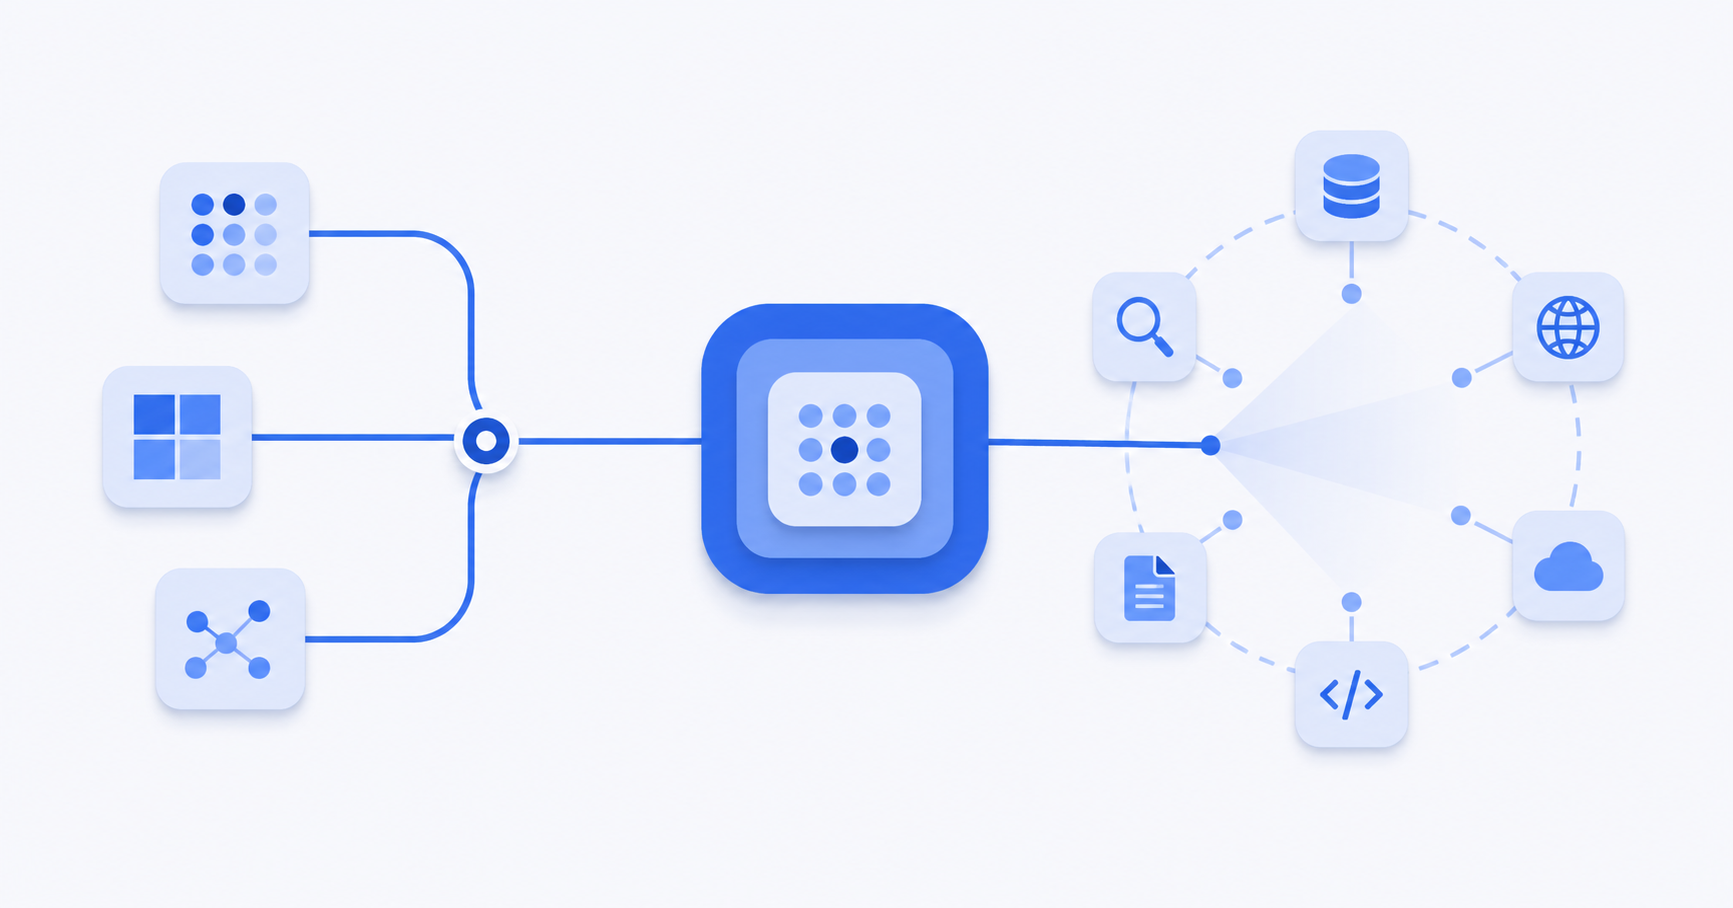
AIHubMix는 통합 모델 접근과 요청 시점의 모델 라우팅으로 첫 번째 결정을 다룹니다. Monid는 런타임 도구 탐색, 스키마 검사, 호출당 과금 방식의 실행으로 두 번째 결정을 다룹니다. 두 제품은 같은 아키텍처의 서로 다른 계층에 위치합니다.
공개 고지: 이 글은 Monid와의 콘텐츠 협업의 일환으로 작성되었습니다. 아래에서 다루는 모델 플랫폼은 AIHubMix이며, Monid는 도구 플랫폼입니다. 두 서비스는 각각 독립적으로 사용할 수 있습니다.
AI 에이전트 내부의 두 가지 라우팅 문제
에이전트 실행은 단일하고 동질적인 모델 호출인 경우가 드뭅니다. 리서치 에이전트는 요청을 분류하고, 최신 정보를 검색하고, 구조화된 사실을 추출하고, 결과를 비교한 뒤 최종 답변을 작성할 수 있습니다. 이 단계들은 서로 다른 역량을 요구합니다.
모델 바깥에서도 마찬가지입니다. 기업 리서치 작업은 오늘은 검색 API, 내일은 기업 정보 보강 엔드포인트, 다음 주에는 브라우저 자동화 도구가 필요할 수 있습니다. 모든 모델과 도구를 빌드 시점에 하드코딩하면 새로운 작업마다 새로운 통합 프로젝트가 됩니다.
두 계층은 병렬 구조를 가집니다:
| 모델 계층 | 도구 계층 | |
|---|---|---|
| 핵심 결정 | 어떤 모델이 응답해야 할까? | 어떤 API를 호출해야 할까? |
| 선택 시점 | 요청마다 | 작업마다, 런타임에 |
| 입력 | 프롬프트, 모달리티, 품질 및 지연 시간 요구사항 | 목표, 필요한 데이터 또는 동작, 스키마와 가격 |
| 출력 | 모델 completion 결과 | 외부 데이터 또는 실행된 동작 |
| 예시 | AIHubMix | Monid |
이 분리는 중요합니다. 더 나은 모델이 실시간 데이터에 대한 접근을 만들어낼 수는 없고, 더 큰 도구 카탈로그가 반환된 데이터를 추론해 주지도 않습니다. 에이전트에는 두 역량이 모두 필요하며, 그 사이에 명확한 계약이 있어야 합니다.
Monid는 AI 에이전트에 두 가지 통합이 필요한 이유에서 도구 측 관점의 보완적인 내용을 다룹니다. 모델 측에서 얻는 아키텍처상의 교훈도 같습니다. 모델 선택과 도구 선택을 독립적으로 유지하고, 각 계층을 고유한 역할에 맞게 최적화하는 것입니다.
에이전트 루프에서 고정된 단일 모델이 비싸지는 이유
모든 단계에 하나의 모델을 쓰는 방식은 단순해 보입니다. 하지만 실제로는 모든 단계가 역량, 지연 시간, 가격 사이의 같은 절충안을 받아들이도록 강요합니다.
시장 조사 에이전트를 예로 들어 보겠습니다:
- 의도 분류는 짧고 기계적인 작업입니다.
- 도구 선택에는 안정적인 지시 이행 능력이 필요합니다.
- 반환된 JSON에서 필드를 추출하는 작업은 대부분 변환 작업입니다.
- 최종 보고서에는 더 강한 추론 능력과 더 나은 글쓰기 능력이 필요할 수 있습니다.
네 단계를 모두 가장 성능이 뛰어난 모델로 보내면 일상적인 작업에 돈이 낭비됩니다. 반대로 네 단계를 모두 가장 저렴한 모델로 보내면 사용자가 읽는 유일한 결과물의 품질이 떨어질 수 있습니다. 에이전트 루프가 커질수록 이런 절충은 모든 호출에서 반복됩니다.
AIHubMix는 폭넓은 모델 카탈로그에 걸쳐 OpenAI 호환 엔드포인트를 제공합니다. 기존 OpenAI SDK 통합은 API 키와 base_url만 바꾸면 AIHubMix를 가리키도록 할 수 있습니다:
from openai import OpenAI

client = OpenAI(
    api_key="<AIHUBMIX_API_KEY>",
    base_url="https://aihubmix.com/v1",
)

response = client.chat.completions.create(
    model="auto:balanced",
    messages=[
        {"role": "user", "content": "Classify this request and propose the next step."}
    ],
)
model을 auto로 설정하면 모델 선택이 요청 경로 안으로 들어옵니다. 라우터가 작업을 분석해 적합한 모델을 결정합니다. 정책 접미사를 붙이면 최적화 목표를 명시할 수 있습니다:
| 라우터 값 | 우선순위 | 일반적인 에이전트 단계 |
|---|---|---|
auto |
비용 우선 | 배치 작업과 일상적인 변환 작업 |
auto:balanced |
역량, 비용, 지연 시간의 균형 | 범용 에이전트 작업 |
auto:quality_first |
역량 우선 | 복잡한 추론과 최종 결과물 |
auto:latency_critical |
속도 우선 | 대화형 루프와 가벼운 계획 수립 |
라우팅에는 별도의 수수료가 없습니다. 요청은 실제로 처리한 모델의 정가로 과금됩니다. 응답에는 X-Aihubmix-Router-Resolved-Model 헤더를 포함한 해석된 모델과 라우팅 세부 정보가 노출되므로, 이 결정은 블랙박스가 되지 않고 관찰 가능한 상태로 남습니다.
전체 동작, 지원 엔드포인트, 정책 및 현재 제한 사항은 AIHubMix LLM 라우터 가이드에 문서화되어 있습니다.
모델 라우팅으로는 에이전트에 실시간 데이터를 제공할 수 없습니다
모델 라우팅을 설정하면 에이전트는 각 단계마다 더 적합한 "두뇌"를 선택할 수 있습니다. 하지만 도구가 해당 기능을 제공하지 않는 한, 모델의 학습 데이터 이후에 무엇이 바뀌었는지 알 수 없고, 비공개 비즈니스 시스템에 접근하거나 다른 애플리케이션에서 동작을 수행할 수도 없습니다.
여기서 많은 에이전트 프로젝트가 취약한 코드를 쌓기 시작합니다. 팀은 검색 API 하나를 연결하고, 그다음 스크래핑 API, 그다음 보강 API를 연결합니다. 각 통합은 계정, 자격 증명, 요청 형식, 오류 모델, 결제 관계를 하나씩 더 추가합니다. 도구 설명은 종종 시스템 프롬프트에 복사되고, 시간이 지나면서 점점 낡은 정보가 됩니다.
이 실패 모드는 성공처럼 보일 수 있기 때문에 위험합니다. 모델은 오래된 스키마에 대해 그럴듯한 호출을 만들고, 불완전한 응답을 받은 뒤에도 작업이 성공한 것처럼 계속 진행할 수 있습니다. 학습 데이터나 오래된 프롬프트에서 얻은 API 계약을 모델이 기억하도록 요구하는 것보다, 런타임에 스키마를 검사하는 편이 더 안전합니다.
따라서 도구 계층은 실행 전에 세 가지 질문에 답해야 합니다:
- 이 목표를 충족할 수 있는 도구는 무엇인가?
- 지금 적용되는 스키마와 가격은 무엇인가?
- 그 호출이 실제로 반환한 결과는 무엇인가?
도구 탐색은 두 번째 라우팅 계층입니다
Monid는 도구 접근을 탐색-검사-실행 워크플로로 바꿉니다. 개발자가 에이전트에 필요할 모든 API를 미리 예측하도록 요구하는 대신, 에이전트는 자연어로 카탈로그를 검색하고, 후보의 계약을 검사한 뒤, 선택한 엔드포인트를 실행할 수 있습니다.
기본 흐름은 다음과 같습니다:
# 1. Find tools that match the goal
monid discover -q "find current product pricing from a public web page"

# 2. Read the selected endpoint's schema and pricing
monid inspect -p PROVIDER_SLUG -e ENDPOINT_PATH

# 3. Execute only after the agent has checked the contract
monid run -p PROVIDER_SLUG -e ENDPOINT_PATH \
  --query '{"url":"https://example.com/product"}'
탐색과 검사를 통해 에이전트는 비용을 쓰기 전에 옵션을 비교할 수 있습니다. 실행은 선택된 엔드포인트의 가격 모델에 따라 과금됩니다. 개발자는 하나의 통합을 유지하면서, 에이전트는 여러 제공업체의 도구에 접근할 수 있게 됩니다.
설정 지침을 읽을 수 있는 에이전트 런타임을 위해, Monid는 기계가 읽을 수 있는 스킬도 함께 제공합니다:
Set up https://monid.ai/SKILL.md
Monid 워크플로 문서에서 카탈로그, 검사, 실행 단계를 더 자세히 설명합니다.
두 계층이 함께 작동하는 방식
모델 게이트웨이와 도구 계층은 작고 명시적인 전달 지점을 가진 별개의 구성 요소로 유지하는 것이 좋습니다:
- 에이전트가 사용자 목표를 받습니다.
- AIHubMix가 계획 호출을 적절한 모델로 라우팅합니다.
- 계획에서 부족한 정보나 필요한 외부 동작을 식별합니다.
- Monid가 후보 도구를 찾고, 그 스키마와 가격을 노출합니다.
- 에이전트가 권한과 예산 범위 안에서 도구를 선택하고 실행합니다.
- 도구가 사실 정보나 동작 결과를 반환합니다.
- AIHubMix가 요구되는 품질, 비용 또는 지연 시간에 따라 종합 호출을 라우팅합니다.
- 에이전트가 도구 결과에 근거한 답변을 반환합니다.
단순화한 Python 예시에서는 도구 결과를 컨텍스트로 삽입하는 동안 모델 측 호출은 그대로 유지할 수 있습니다:
from openai import OpenAI

client = OpenAI(
    api_key="<AIHUBMIX_API_KEY>",
    base_url="https://aihubmix.com/v1",
)

# A fast model is sufficient for a lightweight planning step.
plan = client.chat.completions.create(
    model="auto:latency_critical",
    messages=[
        {
            "role": "user",
            "content": "Plan how to compare the current prices of these products.",
        }
    ],
)

# Your agent uses Monid to discover, inspect, and run an appropriate tool.
# Replace these placeholders with the structured result returned by that call.
tool_result = {
    "source": "<source-url>",
    "data": "<structured-tool-result>",
}

report = client.chat.completions.create(
    model="auto:quality_first",
    messages=[
        {
            "role": "system",
            "content": (
                "Write a concise comparison. Use only the supplied tool result, "
                "preserve source URLs, and state when a value is missing."
            ),
        },
        {"role": "user", "content": str(tool_result)},
    ],
)
중요한 것은 줄 수가 아닙니다. 어떤 선택도 애플리케이션 로직에 영구적으로 내장될 필요가 없다는 점이 중요합니다. 프롬프트가 바뀌면 모델이 바뀔 수 있고, 작업이 바뀌면 도구가 바뀔 수 있습니다.
비용 통제는 두 계층 모두에 필요합니다
모델 비용과 도구 비용은 서로 다른 단위를 사용하므로 따로 측정해야 합니다.
모델 계층에서는 해석된 모델이 토큰 가격을 결정합니다. AIHubMix는 이 결정을 추적 가능하게 만들고, 개발자가 라우팅 정책을 선택하거나 API 키가 사용할 수 있는 모델을 제한할 수 있게 합니다. 일상적인 단계는 비용이나 지연 시간을 우선할 수 있고, 사용자에게 보이는 결과물은 품질을 우선할 수 있습니다.
도구 계층에서는 엔드포인트가 호출당 또는 결과당 요금을 부과할 수 있습니다. Monid는 실행 전 검사 단계에서 가격을 노출합니다. 에이전트는 예산을 초과하는 엔드포인트를 거부하거나, 검증된 옵션을 우선하거나, 유난히 비싼 작업 전에 승인을 요청할 수 있습니다.
유용한 프로덕션 통제 항목은 다음과 같습니다:
- API 키별 모델 허용 목록 또는 가격 상한.
- 작업당 최대 도구 호출 예산.
- 규제 데이터를 위한 제공업체 또는 엔드포인트 허용 목록.
- 모델 라우팅 결정, 도구 호출, 최종 답변을 연결하는 로그.
- 되돌릴 수 없거나 민감한 동작 전에 명시적인 확인.
- 도구 데이터를 지시가 아닌 신뢰할 수 없는 입력으로 취급하는 출력 검증.
이렇게 계층을 나누면 비용 디버깅도 쉬워집니다. 실행 비용이 높아지면 토큰 로그는 에이전트가 과도하게 추론했는지를 보여주고, 도구 로그는 과도하게 데이터를 가져왔는지를 보여줍니다. 해결 방법은 서로 다르므로, 아키텍처는 이 구분을 유지해야 합니다.
신뢰성에는 최신 계약과 드러나는 결정이 필요합니다
동적 선택이 예측 불가능한 동작을 의미해서는 안 됩니다.
모델 측에서 AIHubMix는 요청마다 해석된 모델과 라우팅 정책을 보고합니다. 세션 고정(stickiness)은 여러 턴에 걸친 작업에서 모델 일관성과 프롬프트 캐시 이점을 유지할 수 있고, 폴백 동작은 필요할 때 상태가 나쁜 모델에서 벗어날 수 있게 합니다.
도구 측에서 에이전트는 유료 호출을 하기 전에 현재 엔드포인트 스키마를 검사합니다. 탐색 결과에는 후보를 비교하는 데 필요한 정보가 포함되며, 실제 호출 결과만이 최종 completion에 전달되는 유일한 외부 근거가 됩니다.
이러한 통제들이 함께 유용한 감사 기록을 만듭니다:
user goal
  -> routing decision and resolved model
  -> discovered tool candidates
  -> inspected schema and price
  -> selected endpoint and result
  -> final model decision and grounded response
이 기록은 많은 모델이나 많은 API에 접근할 수 있다는 사실보다 더 가치가 있습니다. 에이전트가 각 선택을 왜 했는지, 그리고 어떤 근거가 답변을 뒷받침했는지를 설명해 주기 때문입니다.
두 계층이 모두 필요하지 않은 경우
모든 워크플로가 런타임 선택의 이점을 얻는 것은 아닙니다.
애플리케이션이 하나의 고정된 프롬프트를 하나의 벤치마크된 모델에 보낸다면, 그 모델을 직접 지정하는 것이 라우팅보다 더 단순하고 결정적입니다. 예약 파이프라인이 항상 알려진 하나의 API만 호출한다면, 탐색 계층을 추가하기보다 그 API를 직접 통합하는 것이 더 명확할 수 있습니다.
두 계층 아키텍처는 작업 부하에 다양성이 포함될 때 그 가치를 발휘합니다:
- 프롬프트가 충분히 달라서 단계마다 최적의 모델이 바뀌는 경우.
- 에이전트는 여러 번 모델을 호출하므로 누적 비용과 지연 시간을 통제할 필요가 있습니다.
- 필요한 도구는 빌드 시점에 전부 예측할 수 없습니다.
- 외부 데이터는 최신 상태여야 하며, 그 출처가 드러나 있어야 합니다.
- 팀은 기능마다 새로운 벤더 연동을 추가하지 않고도 기능을 늘리고 싶어 합니다.
애플리케이션이 실제로 내려야 하는 결정에 따라 모델 계층, 도구 계층, 또는 두 계층을 모두 사용하십시오.
의존성이 아닌 결정을 중심으로 에이전트를 설계하십시오
프로덕션 AI 에이전트는 접근할 수 있는 모델이나 API의 개수로 정의되지 않습니다. 현재 단계에 맞는 적절한 기능을 선택하고, 예산 안에서 동작하며, 무슨 일이 일어났는지 설명할 수 있는지로 정의됩니다.
AIHubMix는 에이전트에게 통합 모델 엔드포인트와, 비용·품질·지연 시간 우선순위에 따른 요청 시점 라우팅을 제공합니다. Monid는 런타임 도구 탐색, 최신 스키마, 명확히 드러나는 가격 정보, 그리고 외부 제공업체 전반에 걸친 실행 기능을 제공합니다.
한 계층은 에이전트가 어떻게 사고할지를 결정하고, 다른 계층은 에이전트가 정보를 찾고 행동하는 방식을 결정합니다. 이 두 결정을 분리해 두면 확장하고, 관찰하고, 통제하기가 더 쉬운 에이전트를 만들 수 있습니다.
먼저 AIHubMix 빠른 시작 가이드를 따라 시작한 다음, Monid를 통해 도구 측을 연결하십시오.
FAQ
AI 에이전트를 위한 모델 라우팅이란 무엇입니까?
모델 라우팅은 작업 유형, 기능, 비용, 지연 시간 같은 요소에 따라 요청마다 모델을 선택하는 방식입니다. AIHubMix에서는 model을 auto로 설정하거나 auto:quality_first와 같은 정책을 지정하면, OpenAI 호환 API를 유지하면서 요청 시점에 모델을 선택할 수 있습니다.
LLM이 이미 지식을 가지고 있다면 왜 AI 에이전트에 도구가 필요합니까?
LLM은 입력받은 컨텍스트와 학습 과정에서 익힌 내용을 바탕으로 답변을 생성합니다. 연결된 도구 없이는 현재 가격을 안정적으로 알 수 없고, 비공개 데이터베이스를 조회하거나 외부 작업을 수행할 수도 없습니다. 도구는 실시간 데이터와 실행 기능을 제공하고, 모델은 계획을 세우고 그 결과를 해석합니다.
모델 게이트웨이는 MCP 서버나 도구 플랫폼과 같은 것입니까?
아닙니다. 모델 게이트웨이는 추론 요청을 모델로 라우팅합니다. MCP 서버와 도구 플랫폼은 외부 기능을 에이전트에 노출합니다. 두 가지는 서로 보완적인 통합 문제를 해결하며, 함께 사용할 수 있습니다.
AIHubMix와 Monid를 각각 독립적으로 사용할 수 있습니까?
네. 동적 도구 요구사항이 없는 애플리케이션이라면 AIHubMix만으로 모델 호출을 라우팅할 수 있습니다. 다른 모델 제공업체나 게이트웨이를 사용하는 에이전트에도 Monid로 도구 탐색 기능을 제공할 수 있습니다. 에이전트에 두 계층 모두에서 런타임 선택이 필요하다면 둘을 함께 사용하는 것이 유용합니다.
자동 라우팅을 감사 가능한 상태로 유지하려면 어떻게 해야 합니까?
작업마다 확정된 모델, 라우팅 정책, 도구 후보, 조회한 가격, 선택된 엔드포인트, 반환된 결과를 기록하십시오. AIHubMix는 응답에 모델 라우팅 세부 정보를 포함하고, Monid는 탐색과 가격 조회를 실행과 분리하므로 유료 호출 전에 도구 결정을 기록할 수 있습니다.