AIHubMix betreibt ein eigenes globales Beschleunigungsnetzwerk für API-Traffic. Nachdem wir Beschleunigungsanbieter von Drittanbietern evaluiert und ihre Latenz und Stabilität für produktive KI-Workloads als unzureichend befunden hatten, haben wir eigene Edge-Knoten, ein eigenes Monitoring-System und eine eigene Traffic-Steuerung aufgebaut. Dieser Beitrag beschreibt die gemessenen Ergebnisse und die dahinterstehende Architektur.
Gemessene Ergebnisse
Die folgenden Werte stammen aus dem kontinuierlichen Produktionsmonitoring nach mehreren Iterationen des Scheduling-Algorithmus.
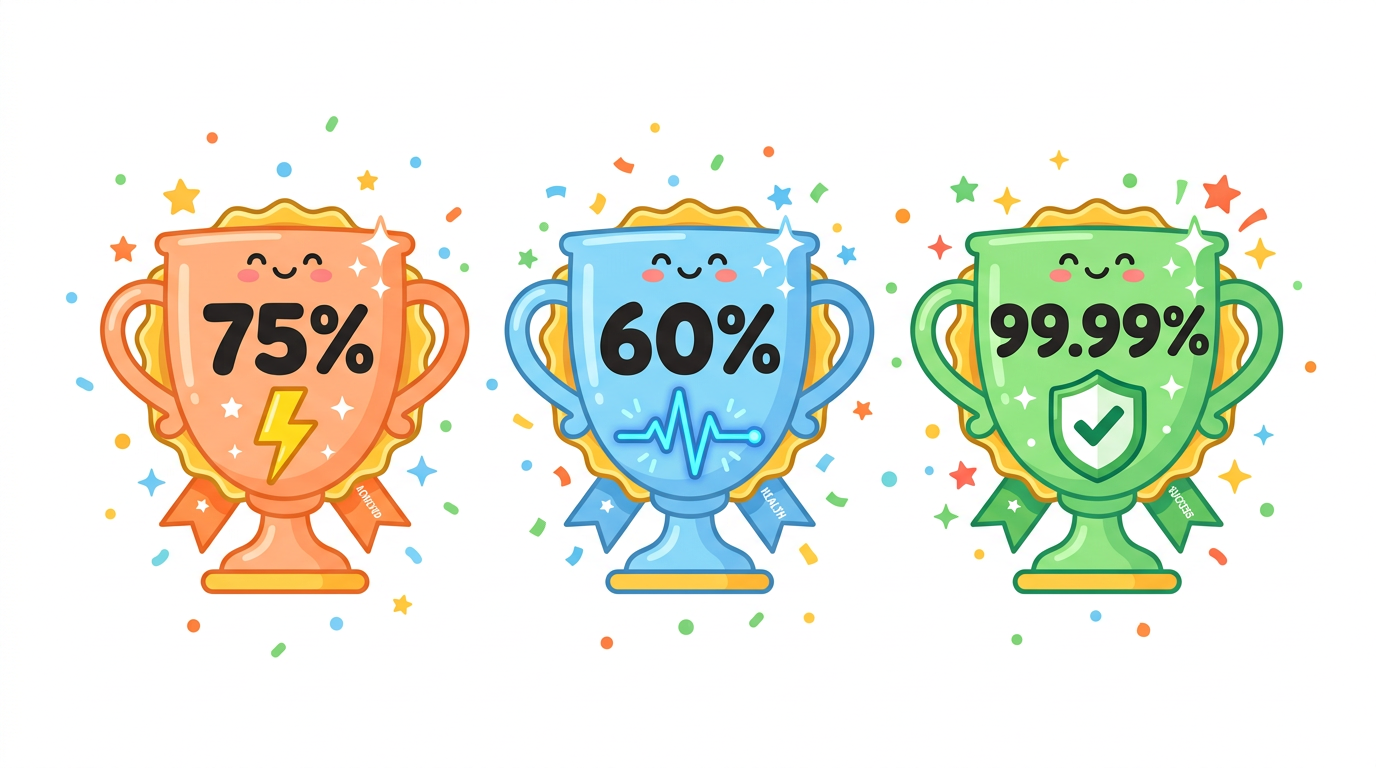
Antwortlatenz um 75% reduziert
Die End-to-End-Latenz der API sank im Durchschnitt um 75%. In Streaming-Szenarien verbessert dies vor allem die Time to First Token (TTFT), also die Zeitspanne zwischen dem Senden einer Anfrage und dem Empfang des ersten Ausgabe-Tokens. Sie bestimmt, wie reaktionsschnell sich eine Chat-Anwendung anfühlt.
Latenzschwankungen um 60% reduziert
Die Varianz der Latenz von Anfrage zu Anfrage sank um 60%. Eine konsistente Latenz ist für produktive Anwendungen wichtig: Sie hält die für Nutzer sichtbaren Antwortzeiten vorhersehbar und reduziert Timeouts bei langsamsten Anfragen (Tail Latency).
Dienstverfügbarkeit von 99,99%
Die über produktiven Traffic gemessene Verfügbarkeit erreicht 99,99%. Dabei handelt es sich um einen gemessenen Wert, der alle Stunden abdeckt, einschließlich Wochenenden und Feiertagen.
Architektur
Eigene Edge-Knoten
Das Netzwerk läuft auf dedizierten Beschleunigungsknoten, die über mehrere Regionen verteilt sind und unabhängig von einzelnen Leitungen oder Cloud-Anbietern arbeiten. Jeder Knoten besteht vor dem Produktiveinsatz Benchmarks für Latenz, Paketverlust und Spitzenlast; Knoten, die die Schwellenwerte nicht erreichen, werden aus dem Pool entfernt. Das Routing wählt für jeden API-Aufruf den schnellsten verfügbaren Pfad.
Zustandsüberwachung mit Prüfungen im Minutentakt
Verteilte Prüfungen in mehreren Regionen führen jede Minute für jeden Knoten eine End-to-End-Zustandsprüfung durch, die drei Dimensionen abdeckt: Latenz, Erfolgsrate und Stabilität. Das gesamte Netzwerk wird alle 60 Sekunden abgetastet, sodass Anomalien einzelner Knoten innerhalb eines Prüfzyklus erkannt werden.
Traffic-Steuerung mit automatischem Failover
Das Scheduling-System berechnet jede Minute für jeden Knoten einen Health-Score neu, und zwar auf Basis von Prüfdaten aus vier gleitenden Zeitfenstern: 1 Minute, 5 Minuten, 15 Minuten und 1 Stunde. Der Traffic wird an den Knoten mit dem aktuell besten Score geleitet. Verschlechtert sich ein Knoten, erfolgt das Failover auf einen gesunden Knoten innerhalb von Millisekunden und ohne manuelles Eingreifen.
Automatisierter Betrieb
Knotenverwaltung, Routenoptimierung, Konfigurationsbereitstellung, Zertifikatserneuerung und Fehlerbehebung sind vollständig automatisiert. Die Behandlung von Störungen hängt nicht von Reaktionszeiten der Bereitschaftsdienste ab: Verschlechterte Knoten werden vom Scheduling-System sofort aus der Rotation genommen, sobald die Prüfungen die Anomalie erkennen.
Was das für Ihre Anwendung bedeutet
- Niedrigere und konsistentere TTFT bei Streaming-Antworten.
- Weniger Timeout-Fehler und Latenzspitzen bei langsamsten Anfragen unter Last.
- Keine Änderungen an der Integration nötig: Die Beschleunigung gilt automatisch für die standardmäßigen API-Endpunkte.
FAQ
Muss ich meine Integration ändern, um vom Beschleunigungsnetzwerk zu profitieren?
Nein. Die Beschleunigung greift auf der Einstiegsebene der Plattform. Bestehende API-Endpunkte, Schlüssel und Anfrageformate funktionieren unverändert.
Wie oft wird der Zustand der Knoten geprüft?
Verteilte Prüfungen erfassen alle 60 Sekunden jeden Knoten im Netzwerk und messen End-to-End Latenz, Erfolgsrate und Stabilität.
Was passiert, wenn sich ein Knoten verschlechtert?
Das Scheduling-System berechnet die Health-Scores jede Minute aus vier gleitenden Zeitfenstern (1 Minute, 5 Minuten, 15 Minuten, 1 Stunde) neu und verlagert den Traffic automatisch auf gesunde Knoten. Das Failover ist in Millisekunden abgeschlossen.
Zuletzt aktualisiert: 2026-06-01