AIHubMix 为 API 流量运营一套自建的全球加速网络。在评估了第三方加速服务商后,我们发现其延迟和稳定性不足以支撑生产环境中的 AI 工作负载,于是部署了自有的边缘节点、监控系统和流量调度体系。本文介绍实测结果以及背后的架构。
实测结果
以下数据来自我们在调度算法经过多轮迭代后的持续生产环境监控。
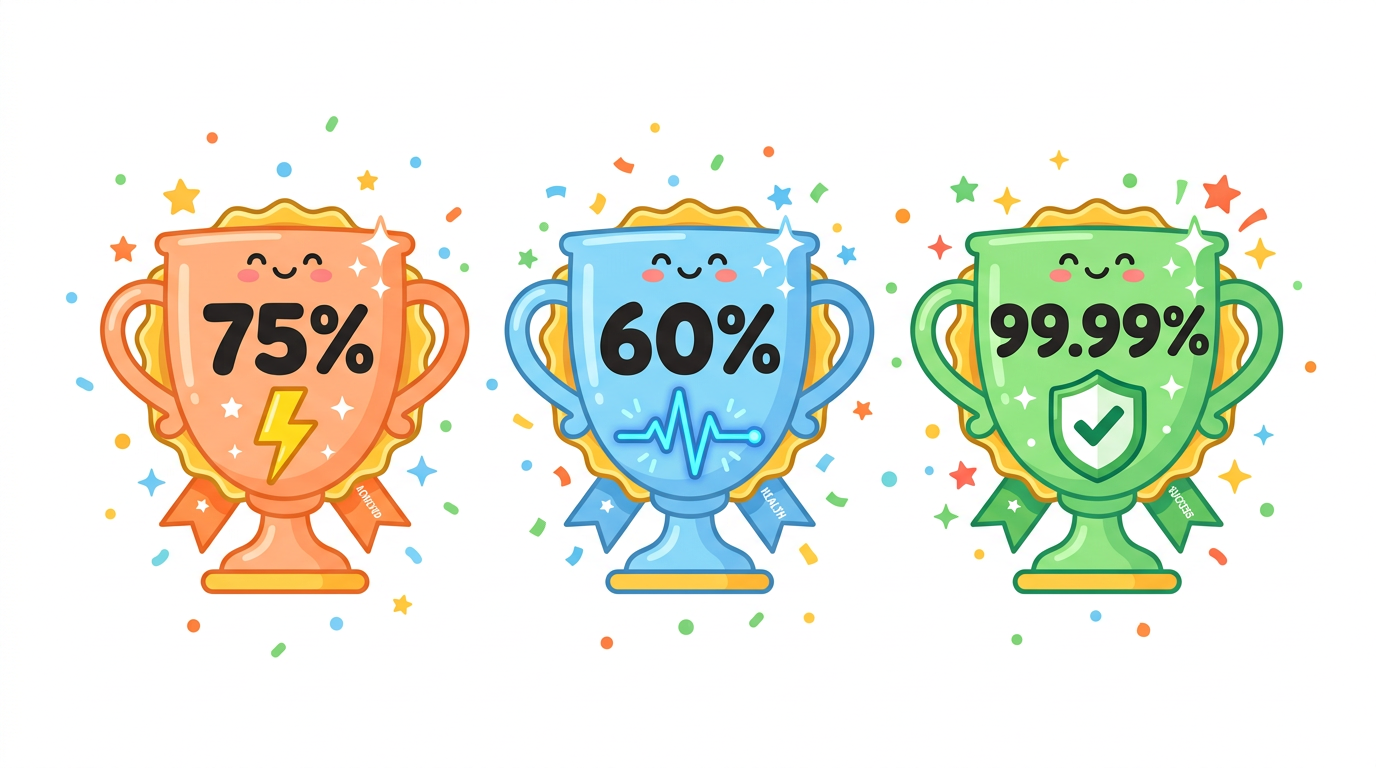
响应延迟降低75%
端到端 API 延迟平均下降75%。在流式场景中,这主要改善了首 Token 时间(TTFT),即从发送请求到收到第一个输出 Token 之间的间隔,它决定了聊天应用的响应速度是否灵敏。
延迟波动降低60%
请求之间的延迟方差下降了60%。对生产应用而言,延迟的稳定性十分重要:它能让面向用户的响应时间更可预测,并减少长尾延迟导致的超时。
服务可用性达99.99%
基于生产流量测得的可用性达到99.99%。这是覆盖全部时段的实测数据,包括周末和节假日。
架构
自建边缘节点
网络运行在部署于多个地区的专用加速节点上,不依赖任何单一线路或云服务商。每个节点在投入生产前都需通过延迟、丢包率和峰值负载基准测试;未达标的节点会被移出节点池。路由会为每次 API 调用选择当前最快的可用路径。
分钟级探测的健康监控
分布在多个地区的探测器每分钟对每个节点执行一次端到端健康检查,覆盖延迟、成功率和稳定性三个维度。整个网络每60秒扫描一遍,因此节点异常可在一个探测周期内被发现。
自动故障切换的流量调度
调度系统每分钟基于四个滑动窗口的探测数据重新计算每个节点的健康评分,窗口分别为1分钟、5分钟、15分钟和1小时。流量会被路由到当前评分最高的节点。当某个节点性能下降时,切换到健康节点可在毫秒级内完成,无需人工干预。
自动化运维
节点管理、路由优化、配置部署、证书轮换和故障恢复均已实现自动化。事件处理不依赖值班人员的响应时间:探测一旦发现异常,调度系统便会立即将性能下降的节点移出轮换。
这对您的应用意味着什么
- 流式响应的 TTFT 更低且更稳定。
- 在高负载下,超时错误和长尾延迟峰值更少。
- 无需修改集成:加速会自动作用于标准 API 端点。
常见问题
我需要修改集成才能享受加速网络的优势吗?
不需要。加速作用于平台入口层。现有的 API 端点、密钥和请求格式均无需改动即可正常使用。
节点健康检查的频率是多少?
分布式探测器每60秒扫描网络中的每个节点,端到端地测量延迟、成功率和稳定性。
节点性能下降时会发生什么?
调度系统每分钟基于四个滑动窗口(1分钟、5分钟、15分钟、1小时)重新计算健康评分,并自动将流量转移到健康节点。故障切换在毫秒级内完成。
最后更新:2026-06-01